Tudo o que quer saber antes de instalar.
Uma análise detalhada de como o AI Competitor: Monitorização de Preços da Concorrência com IA funciona, porque o construímos assim e o raciocínio por trás das funcionalidades acima.
Porquê vigiar os preços da concorrência em contínuo
Dois compradores em cada três comparam preços antes de comprar. Uma variação de 3 por cento num concorrente direto pode inverter uma decisão de compra. Sem vigilância automatizada descobre essas diferenças tarde demais, depois de perder a venda. O AI Competitor vigia os seus concorrentes em segundo plano, com a frequência que escolher, e só o avisa quando é relevante.
Obter o catálogo completo de um concorrente
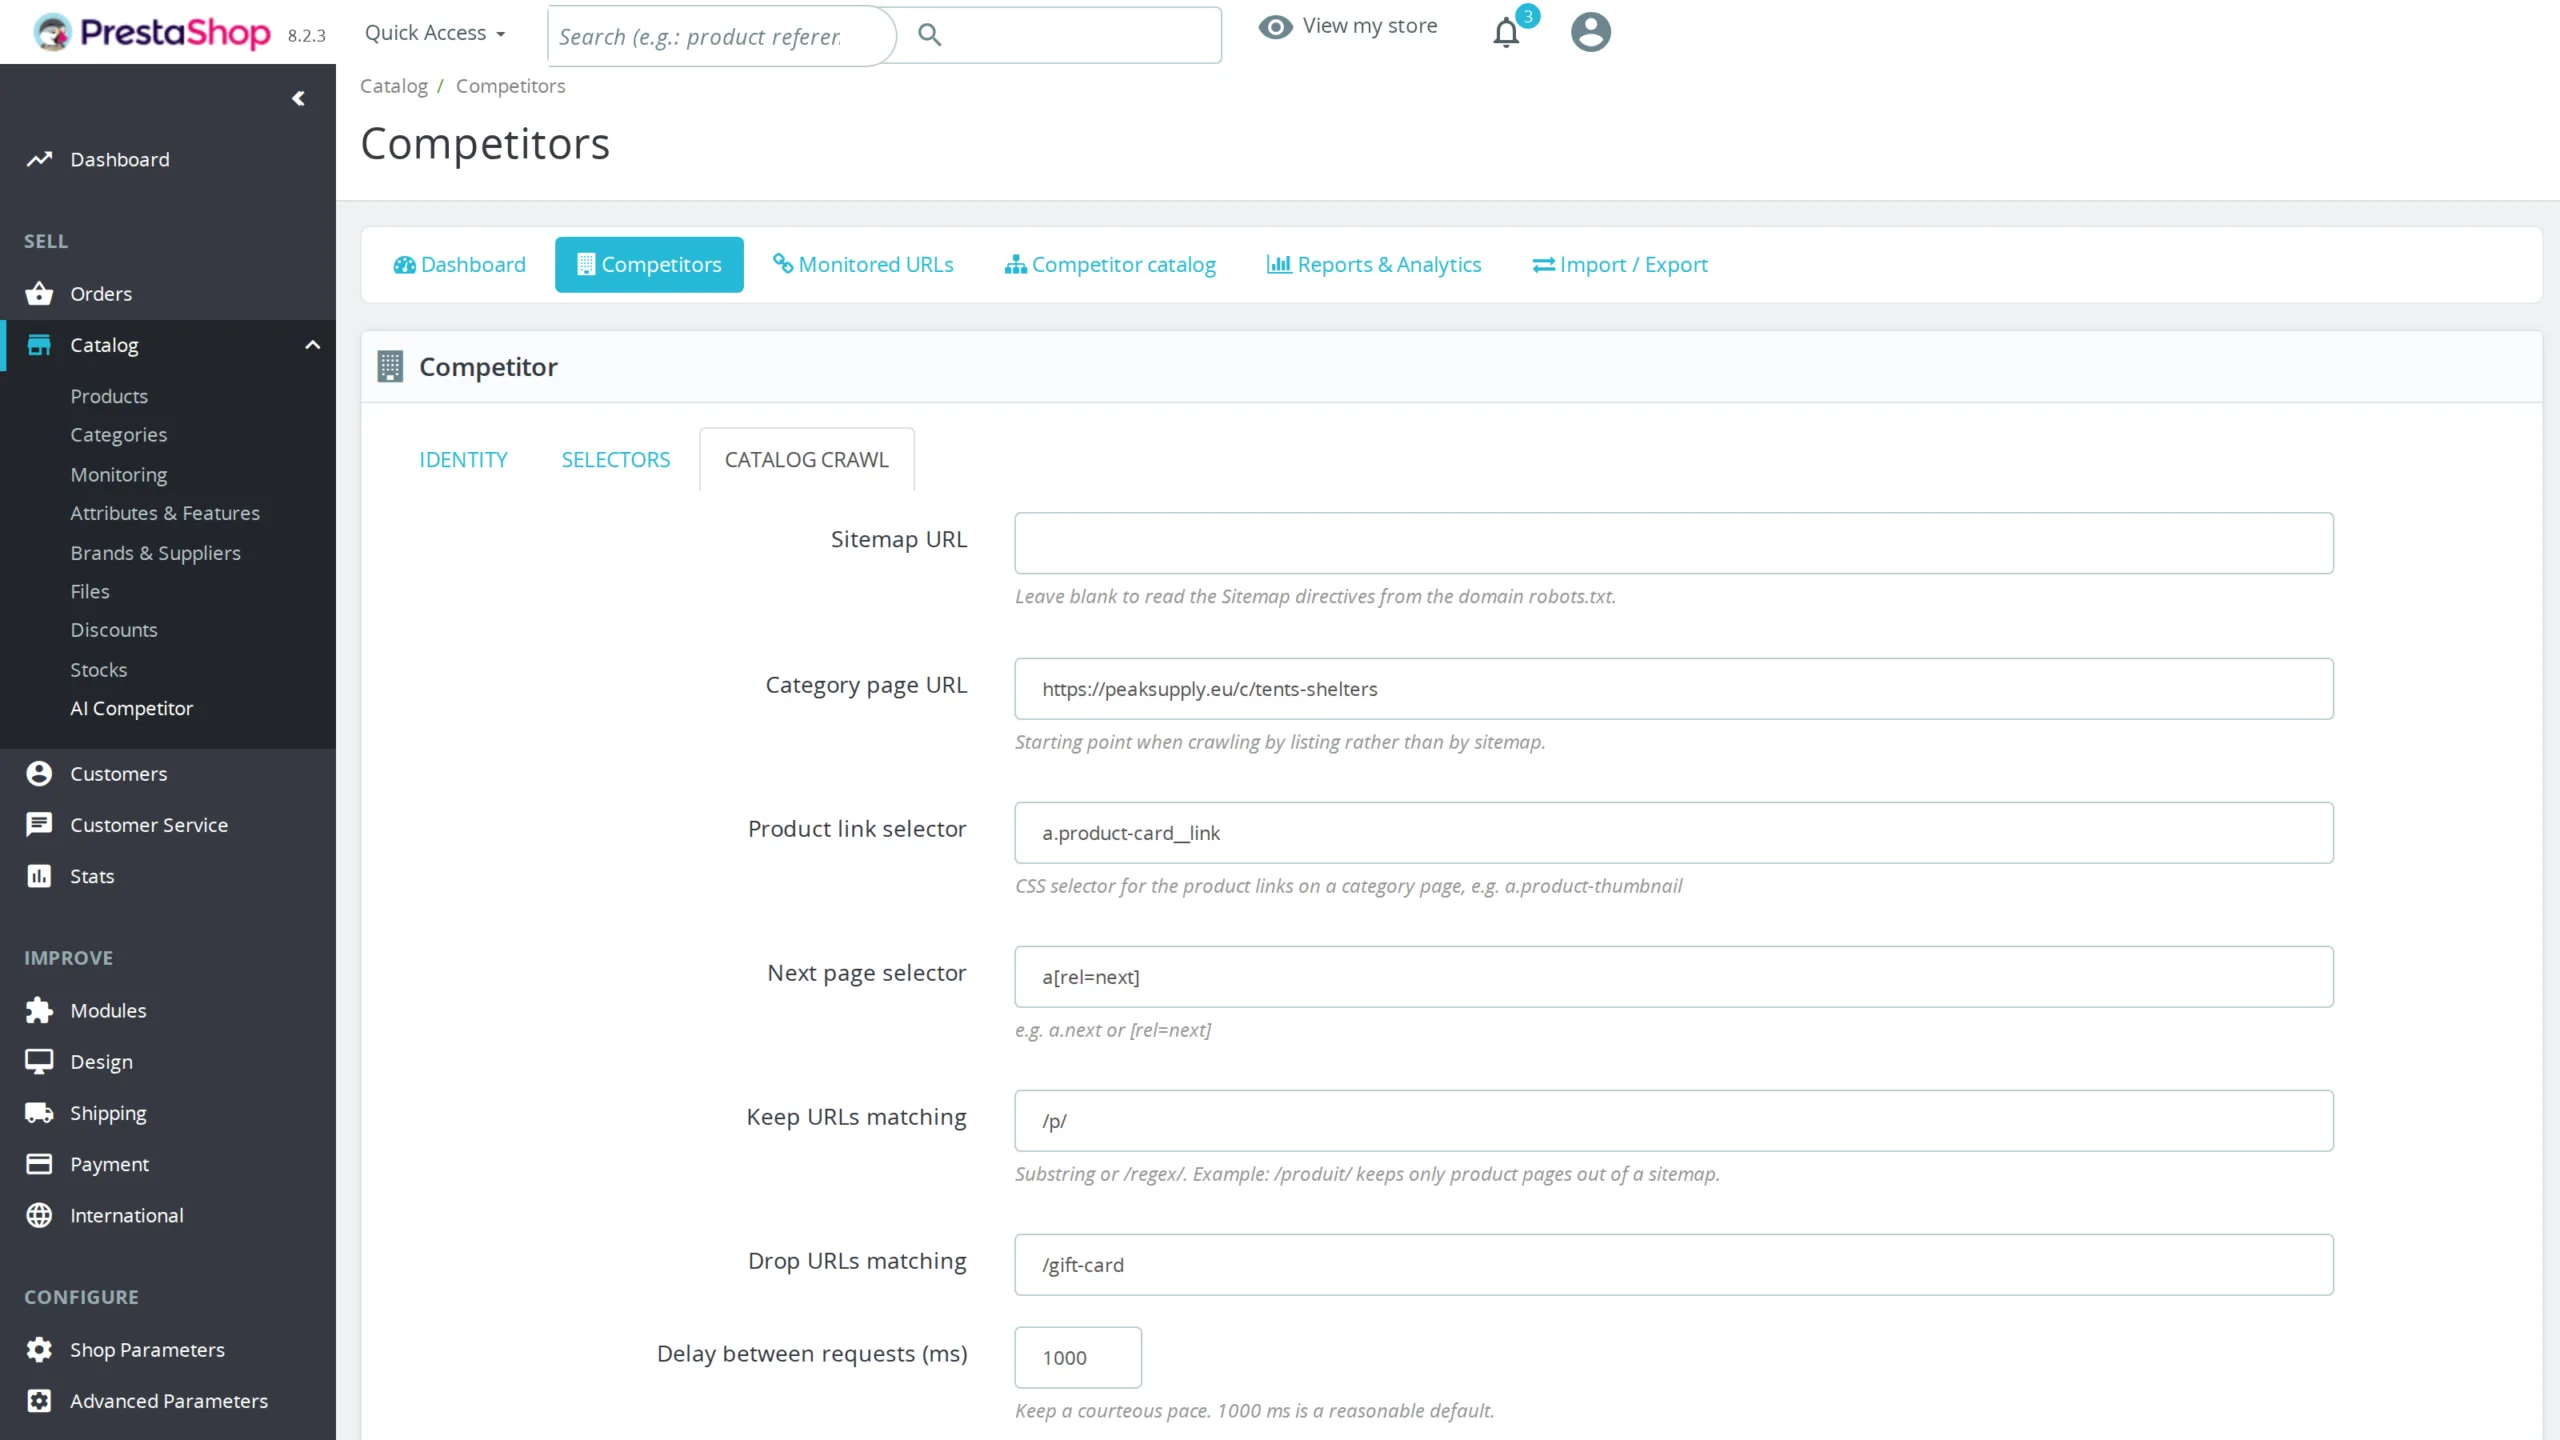
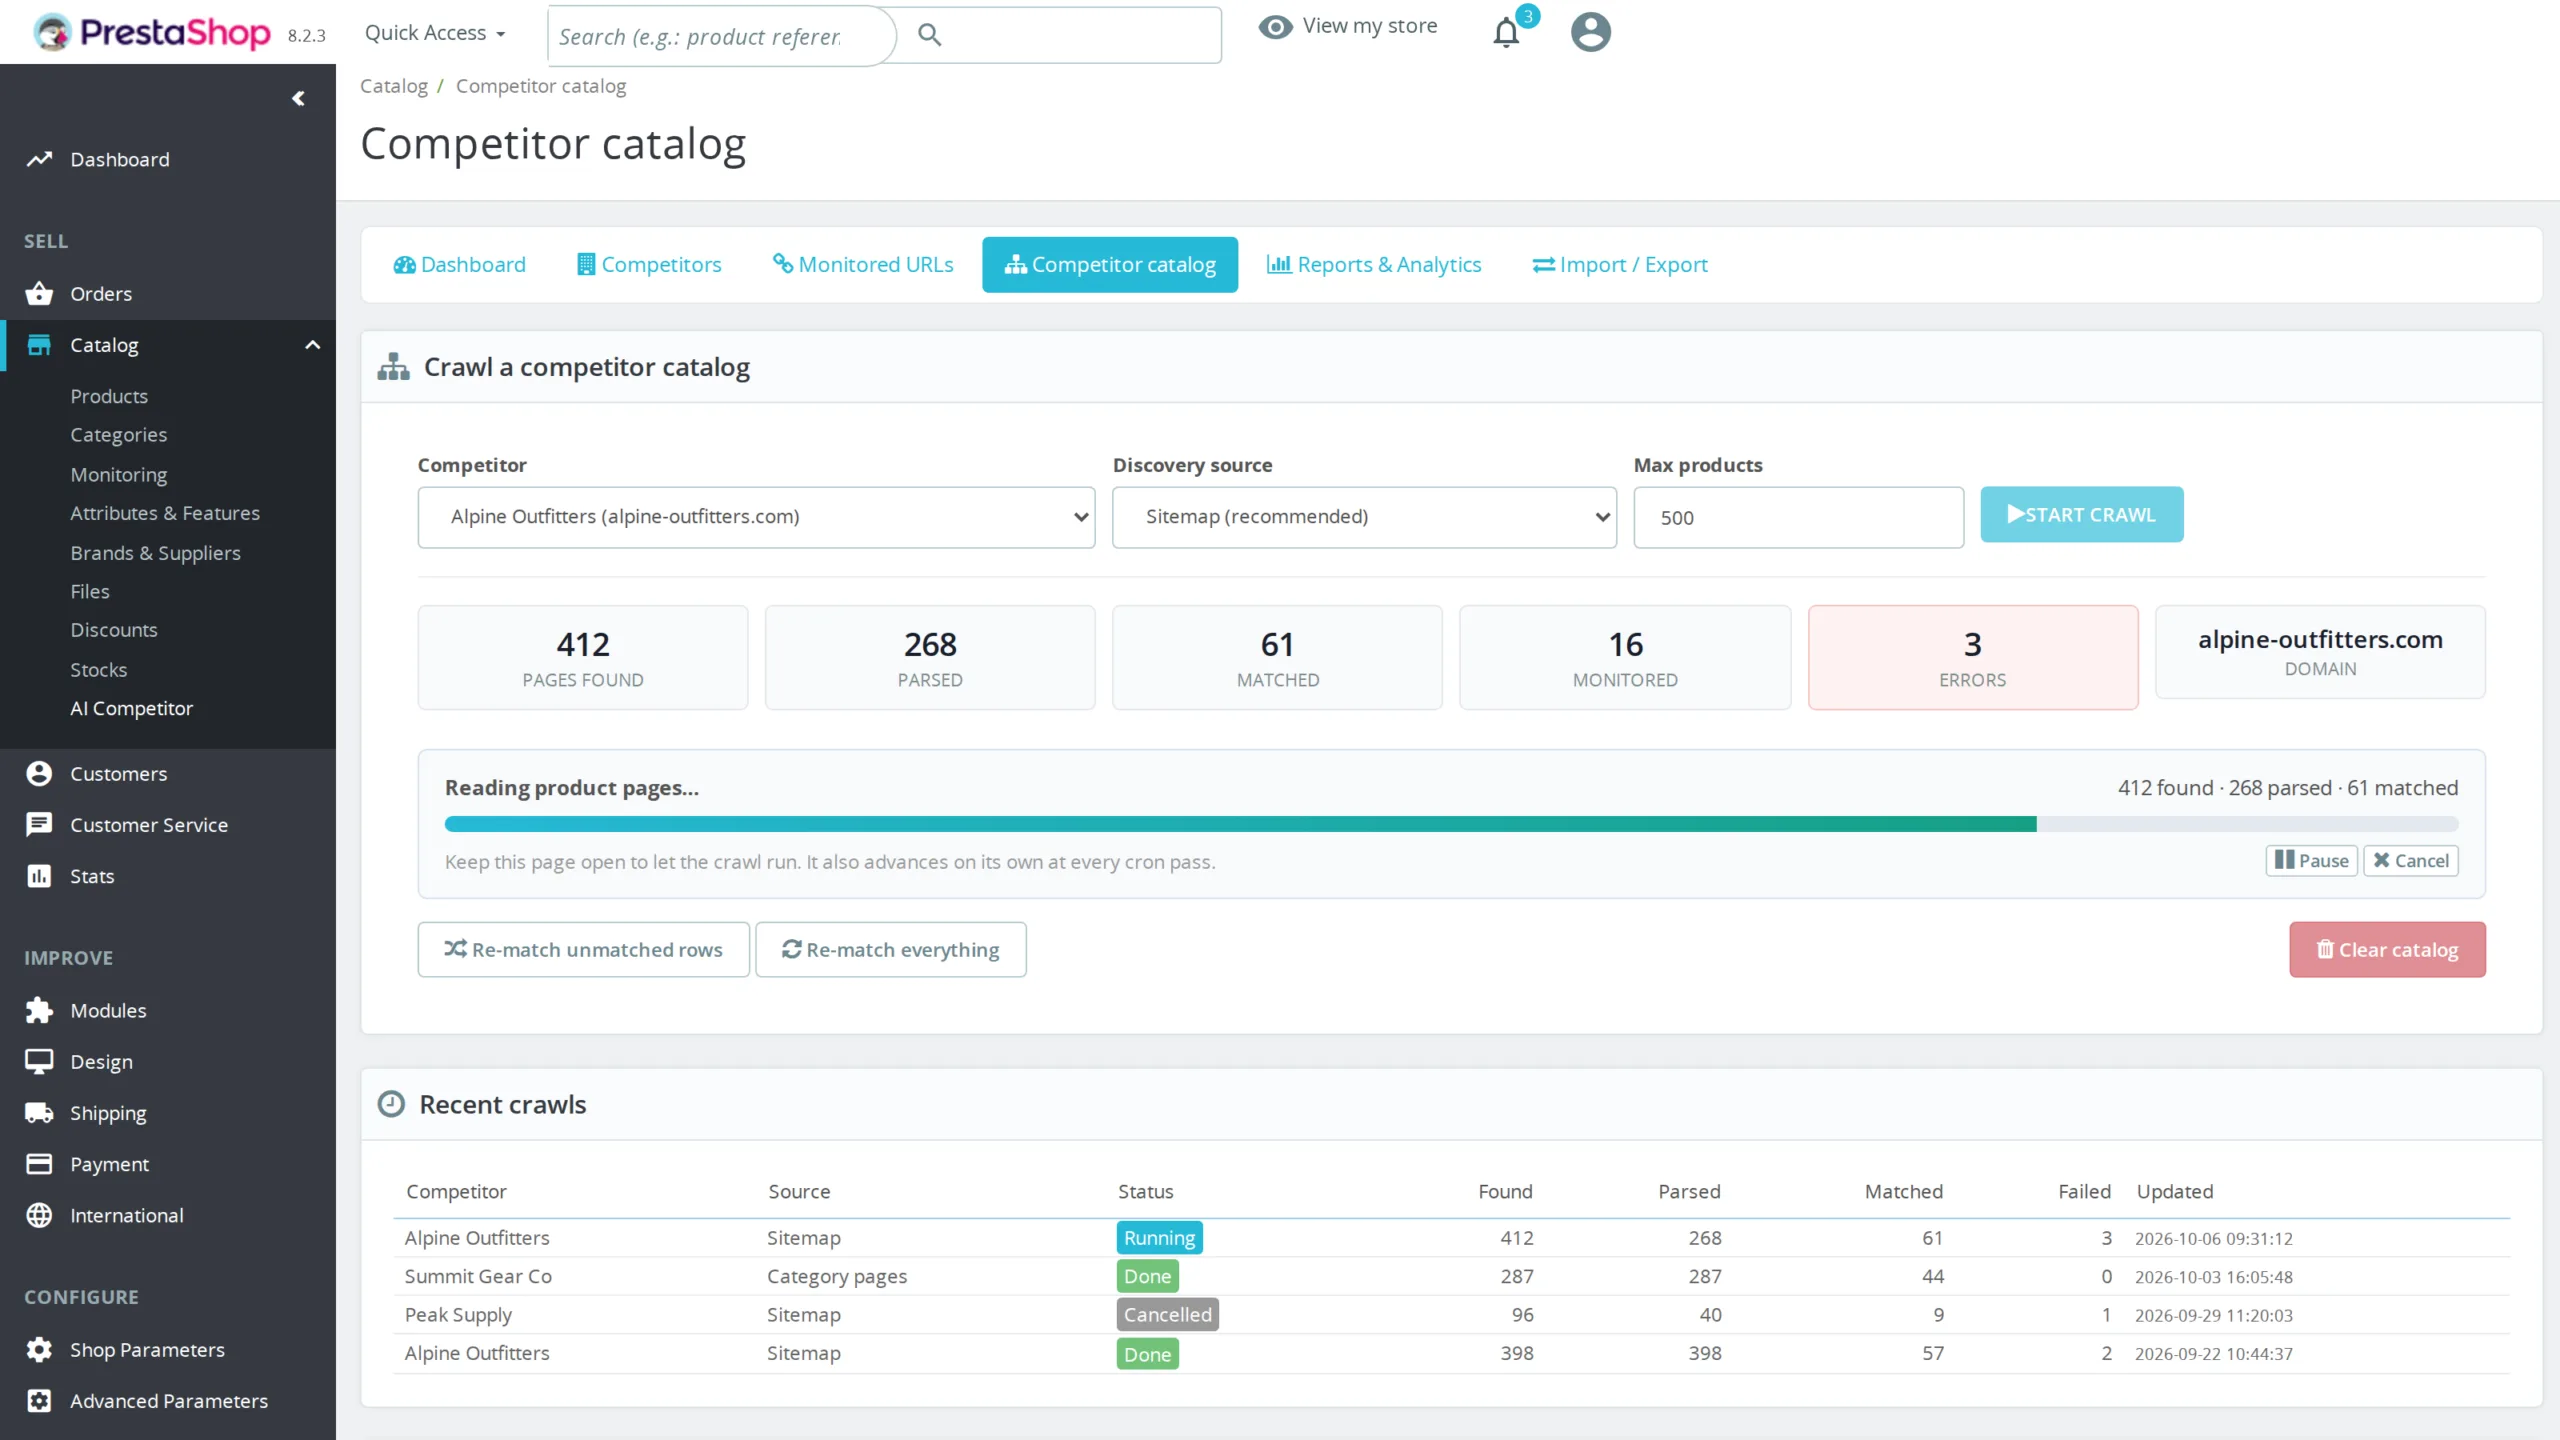
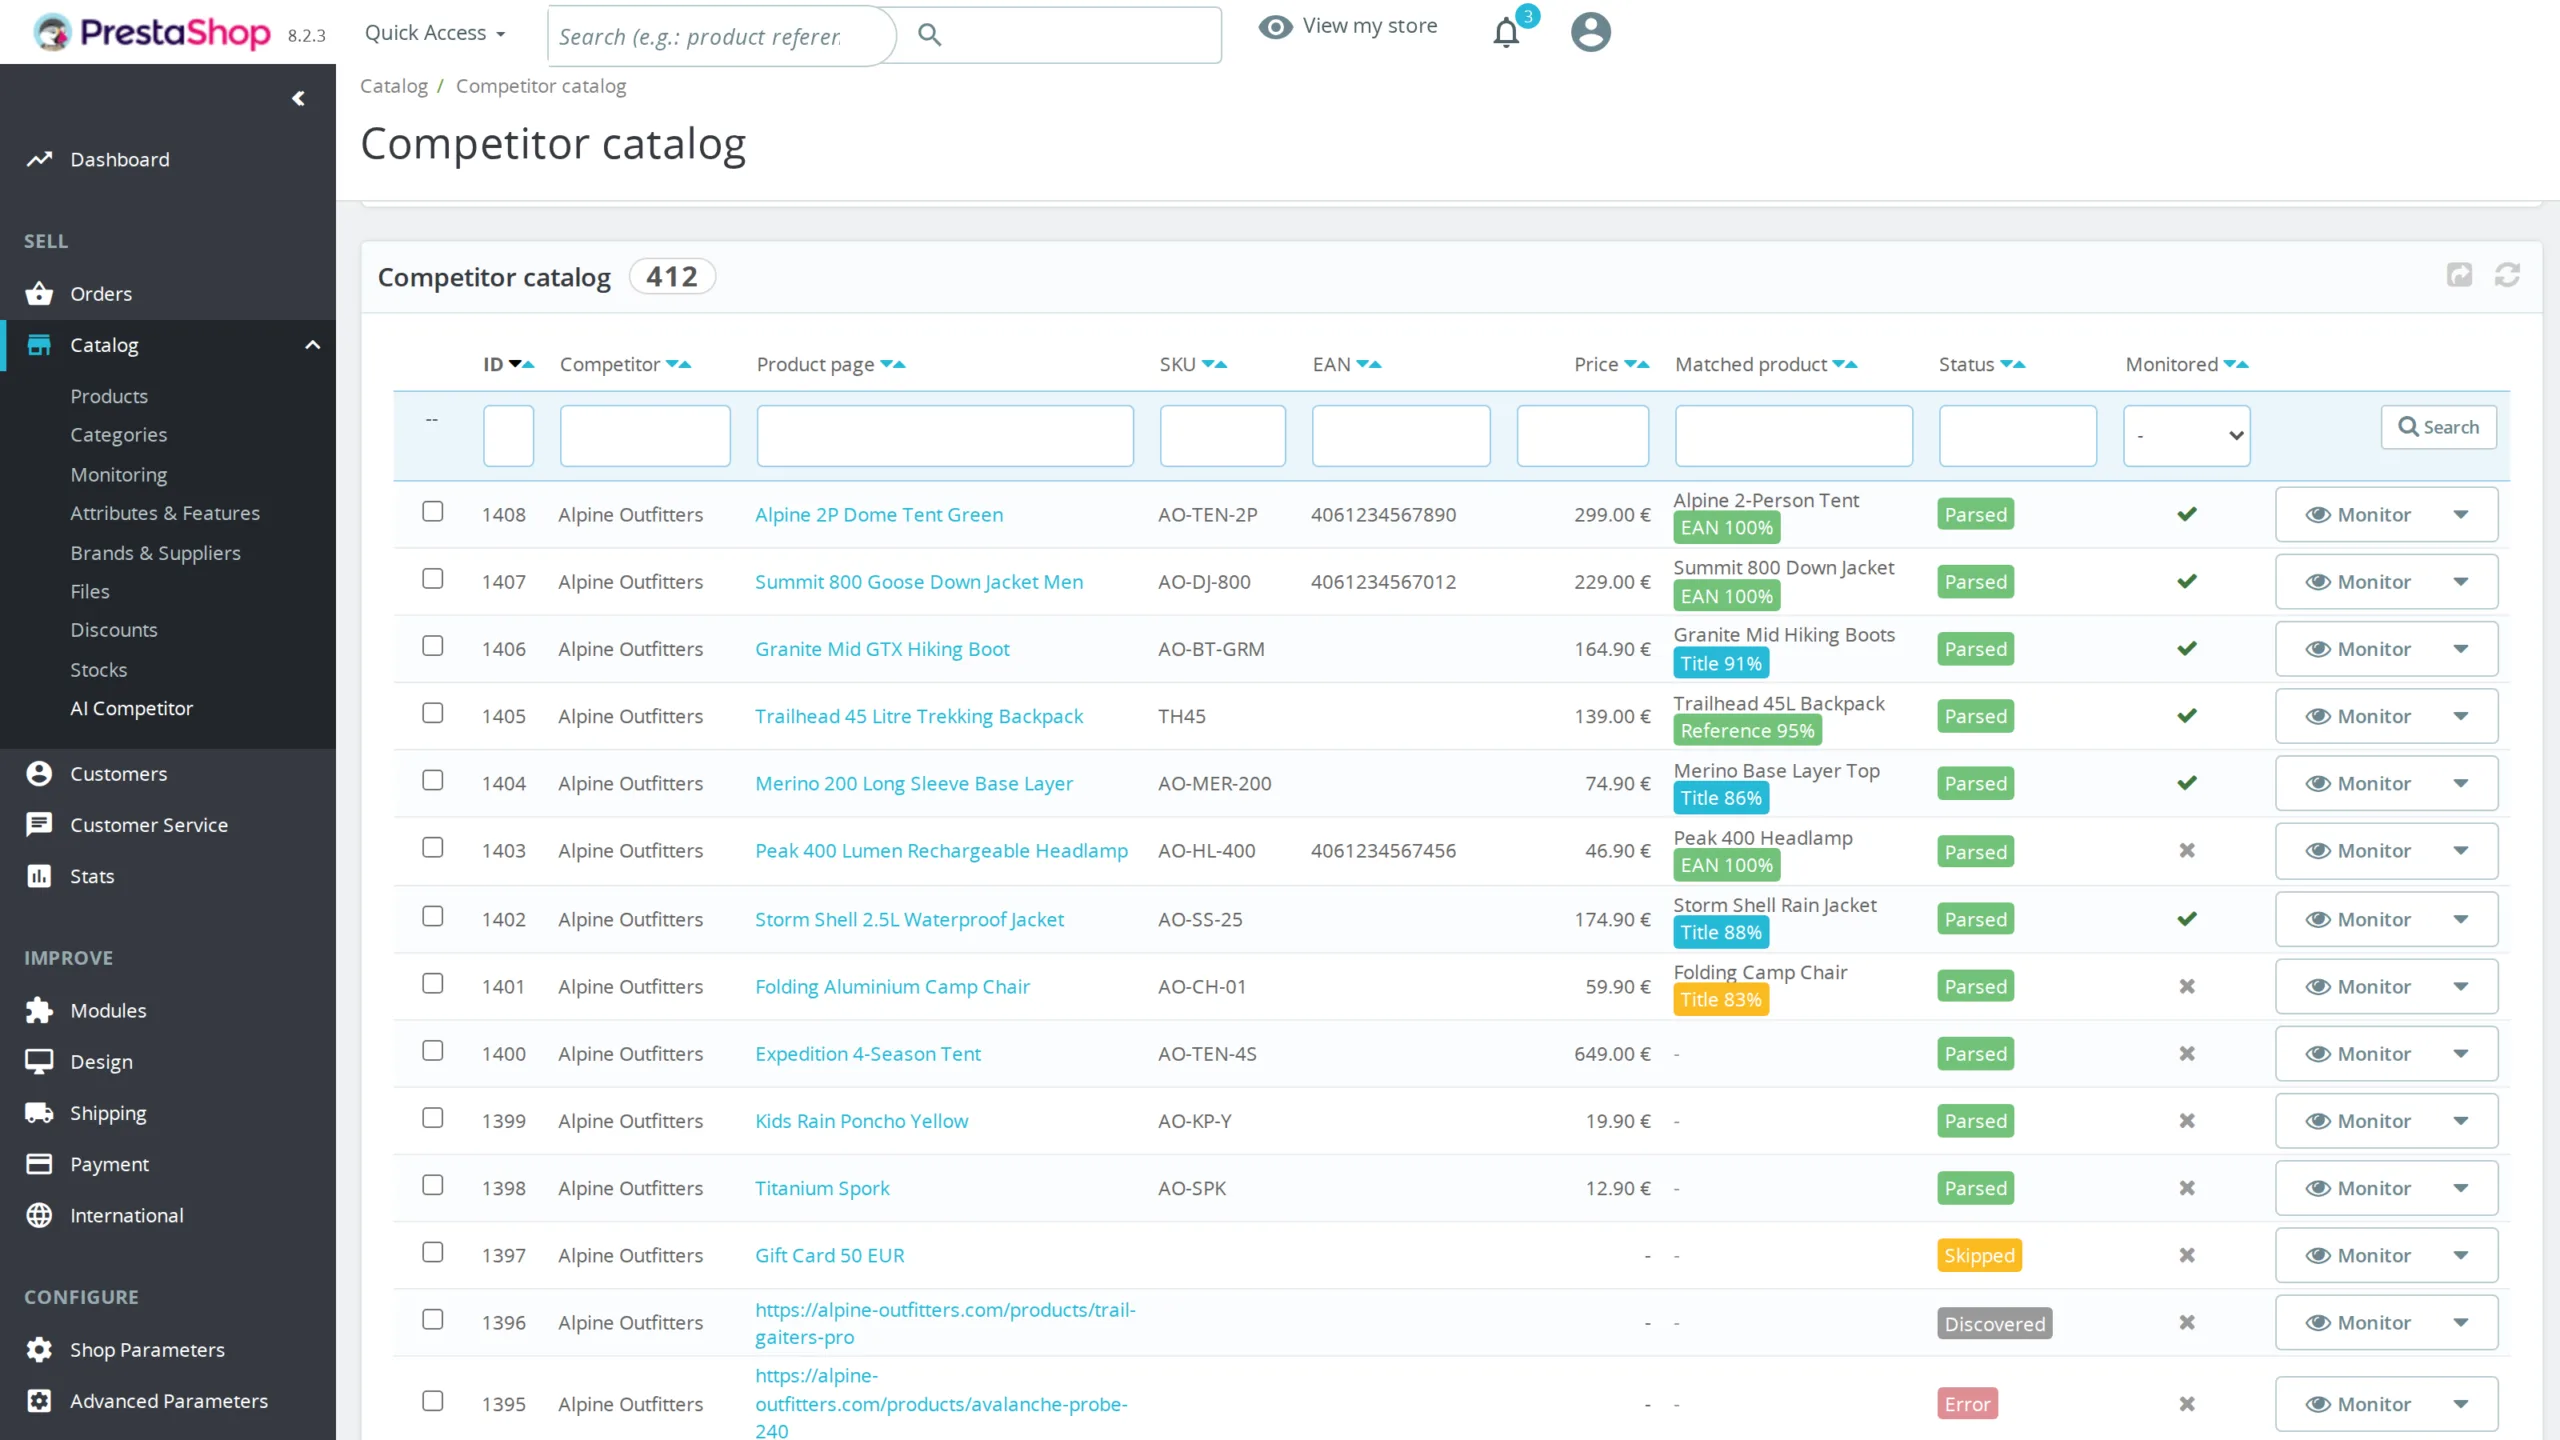
Introduzir os URLs da concorrência um a um não escala num catálogo real. O módulo constrói a lista sozinho: indica-lhe um domínio, ele lê o sitemap configurado ou o anunciado pelo robots.txt, segue os índices de sitemaps de forma recursiva e retém os endereços que correspondem ao padrão das páginas de produto. Se o concorrente não expõe um sitemap aproveitável, o rastreio parte de uma página de categoria, recolhe as ligações de produto e segue a paginação. Cada página descoberta é depois aberta para extrair título, SKU, EAN, marca, preço, disponibilidade e imagem.
A correspondência com o seu catálogo
Uma lista de páginas da concorrência só vale relacionada com os seus próprios produtos. O módulo tenta primeiro o EAN13, no produto como nas suas variantes, o que dá uma correspondência certa. Na falta dele compara a referência, a referência de fornecedor e o MPN. Em último recurso avalia a semelhança dos títulos, com uma ponderação que dá mais peso aos números de modelo e às marcas do que às palavras comuns, contra um limiar que você define. As correspondências duvidosas ficam visíveis e corrigem-se à mão com preenchimento automático sobre o seu catálogo. Uma página relacionada torna-se um URL monitorizado com um clique, ou em massa a partir da lista.
Um concorrente definido uma vez, reutilizado em todo o lado
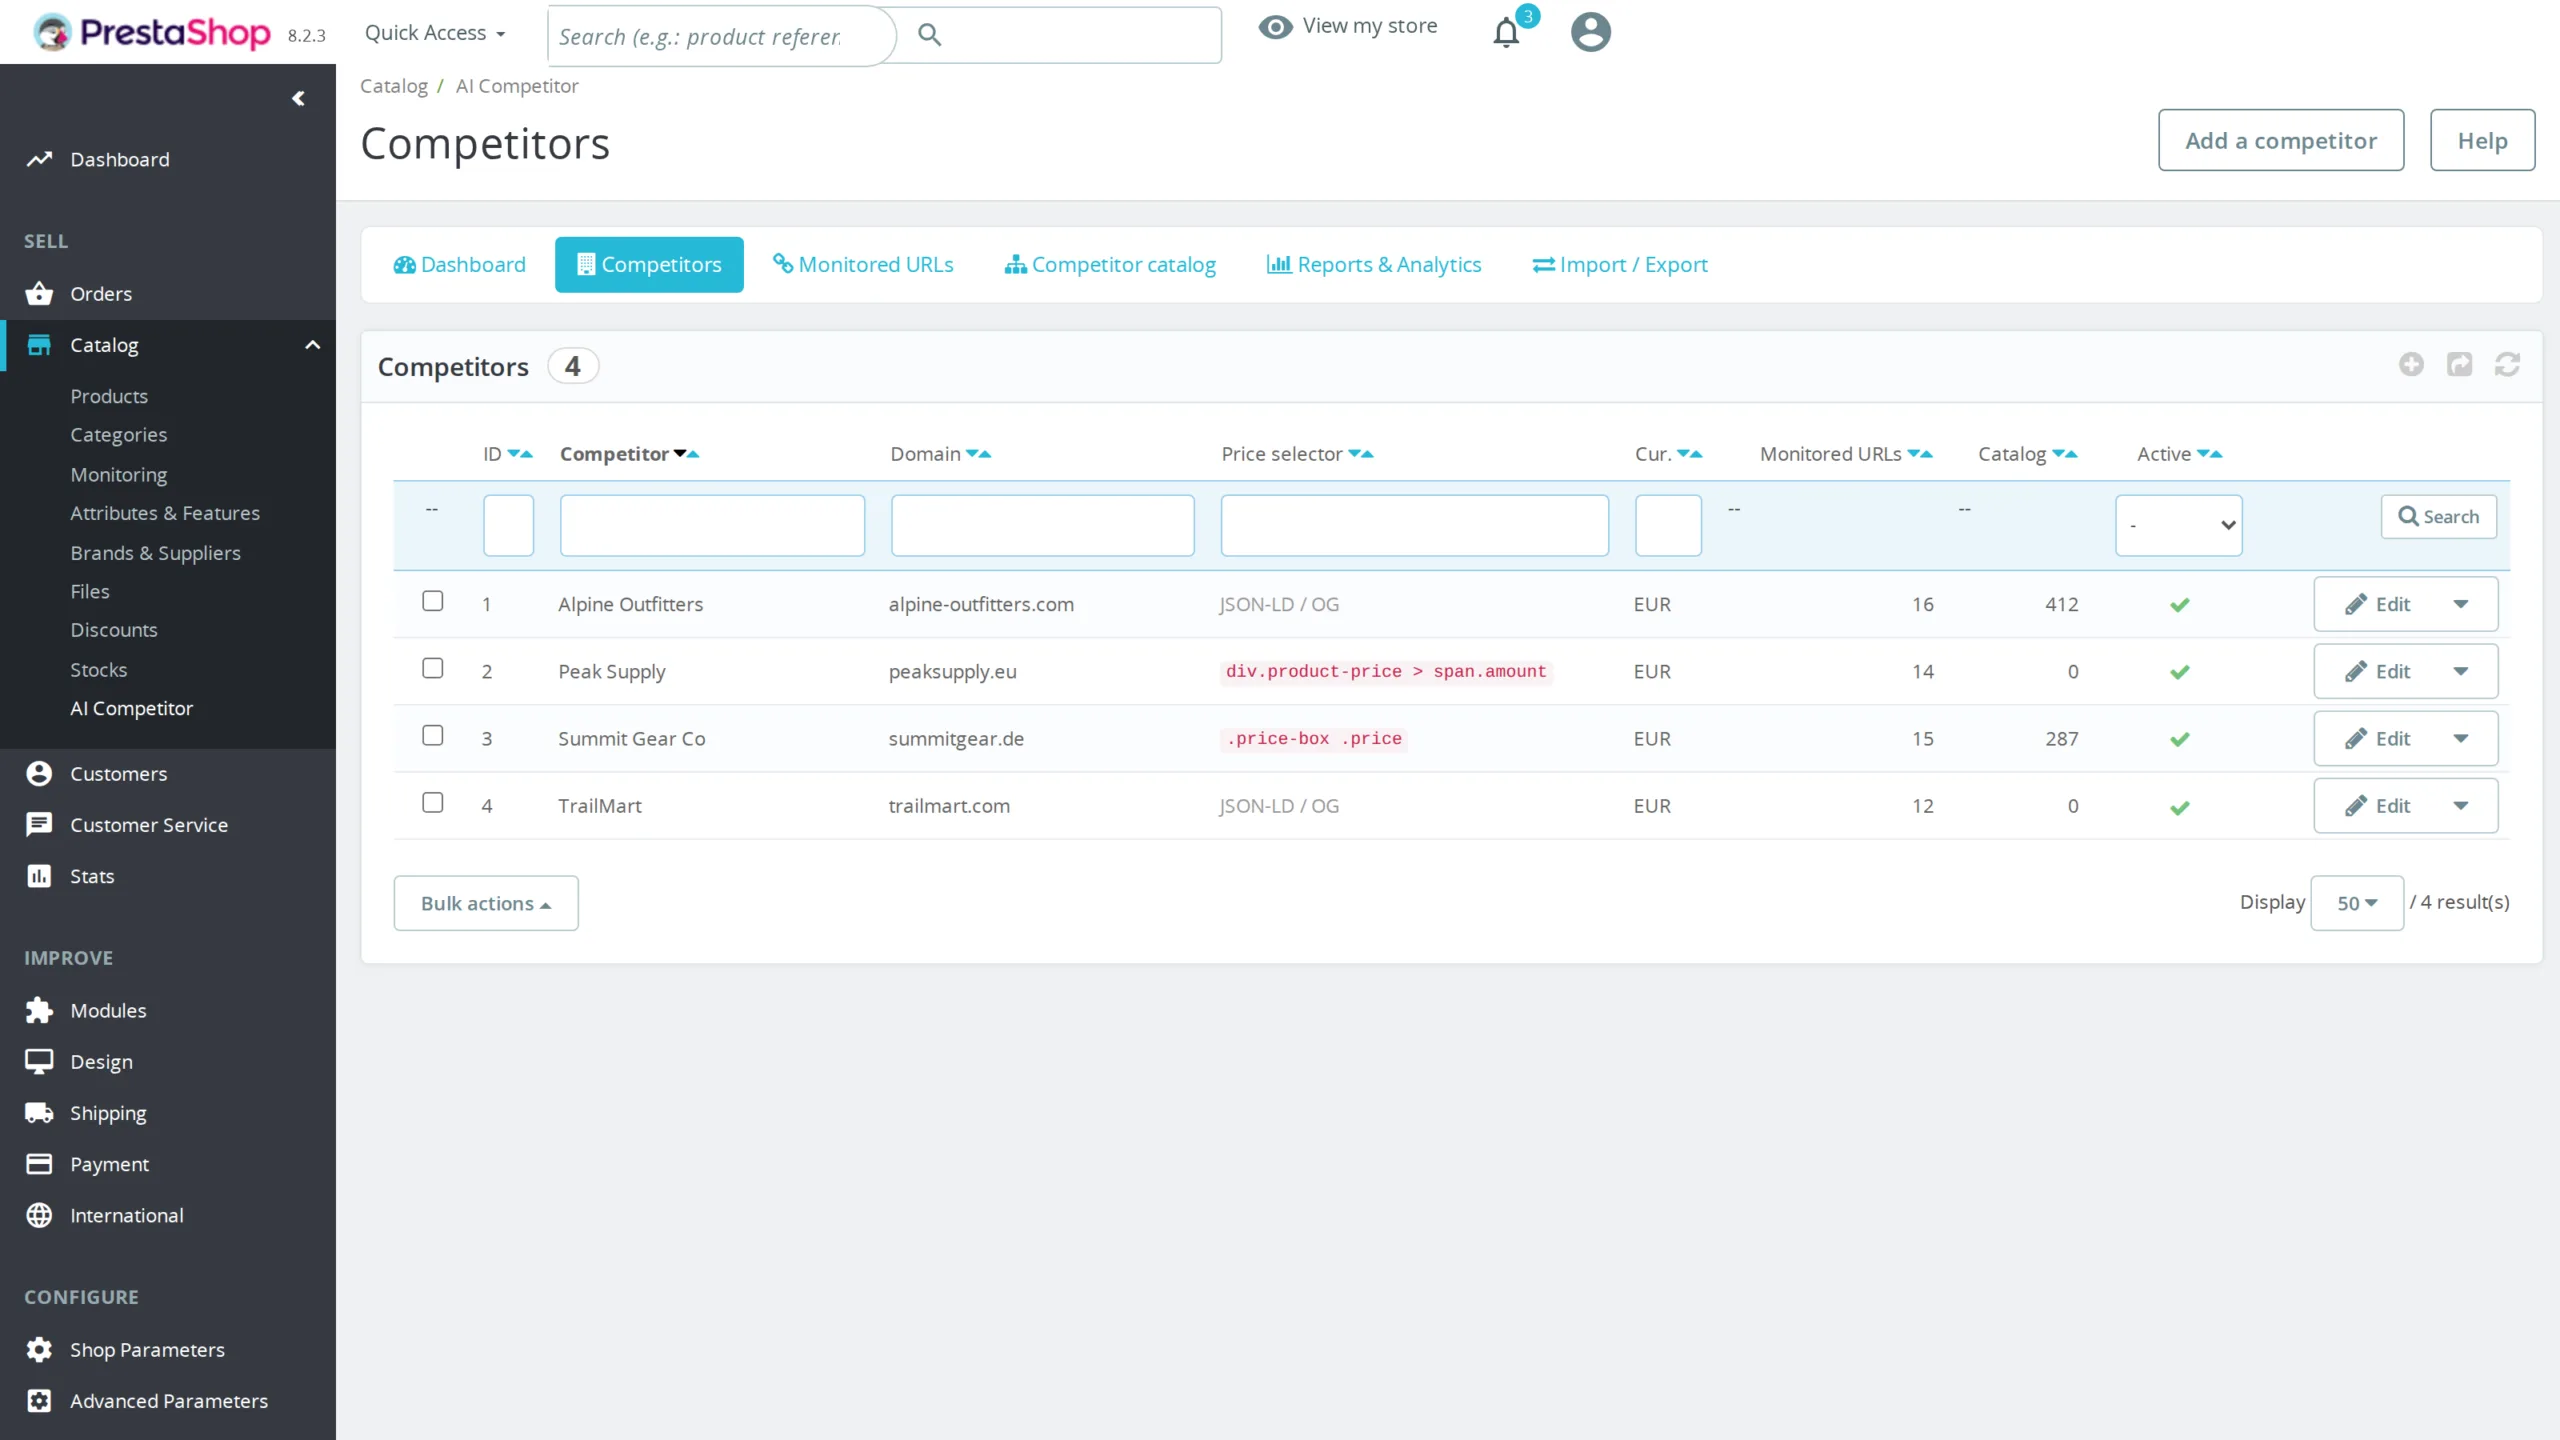
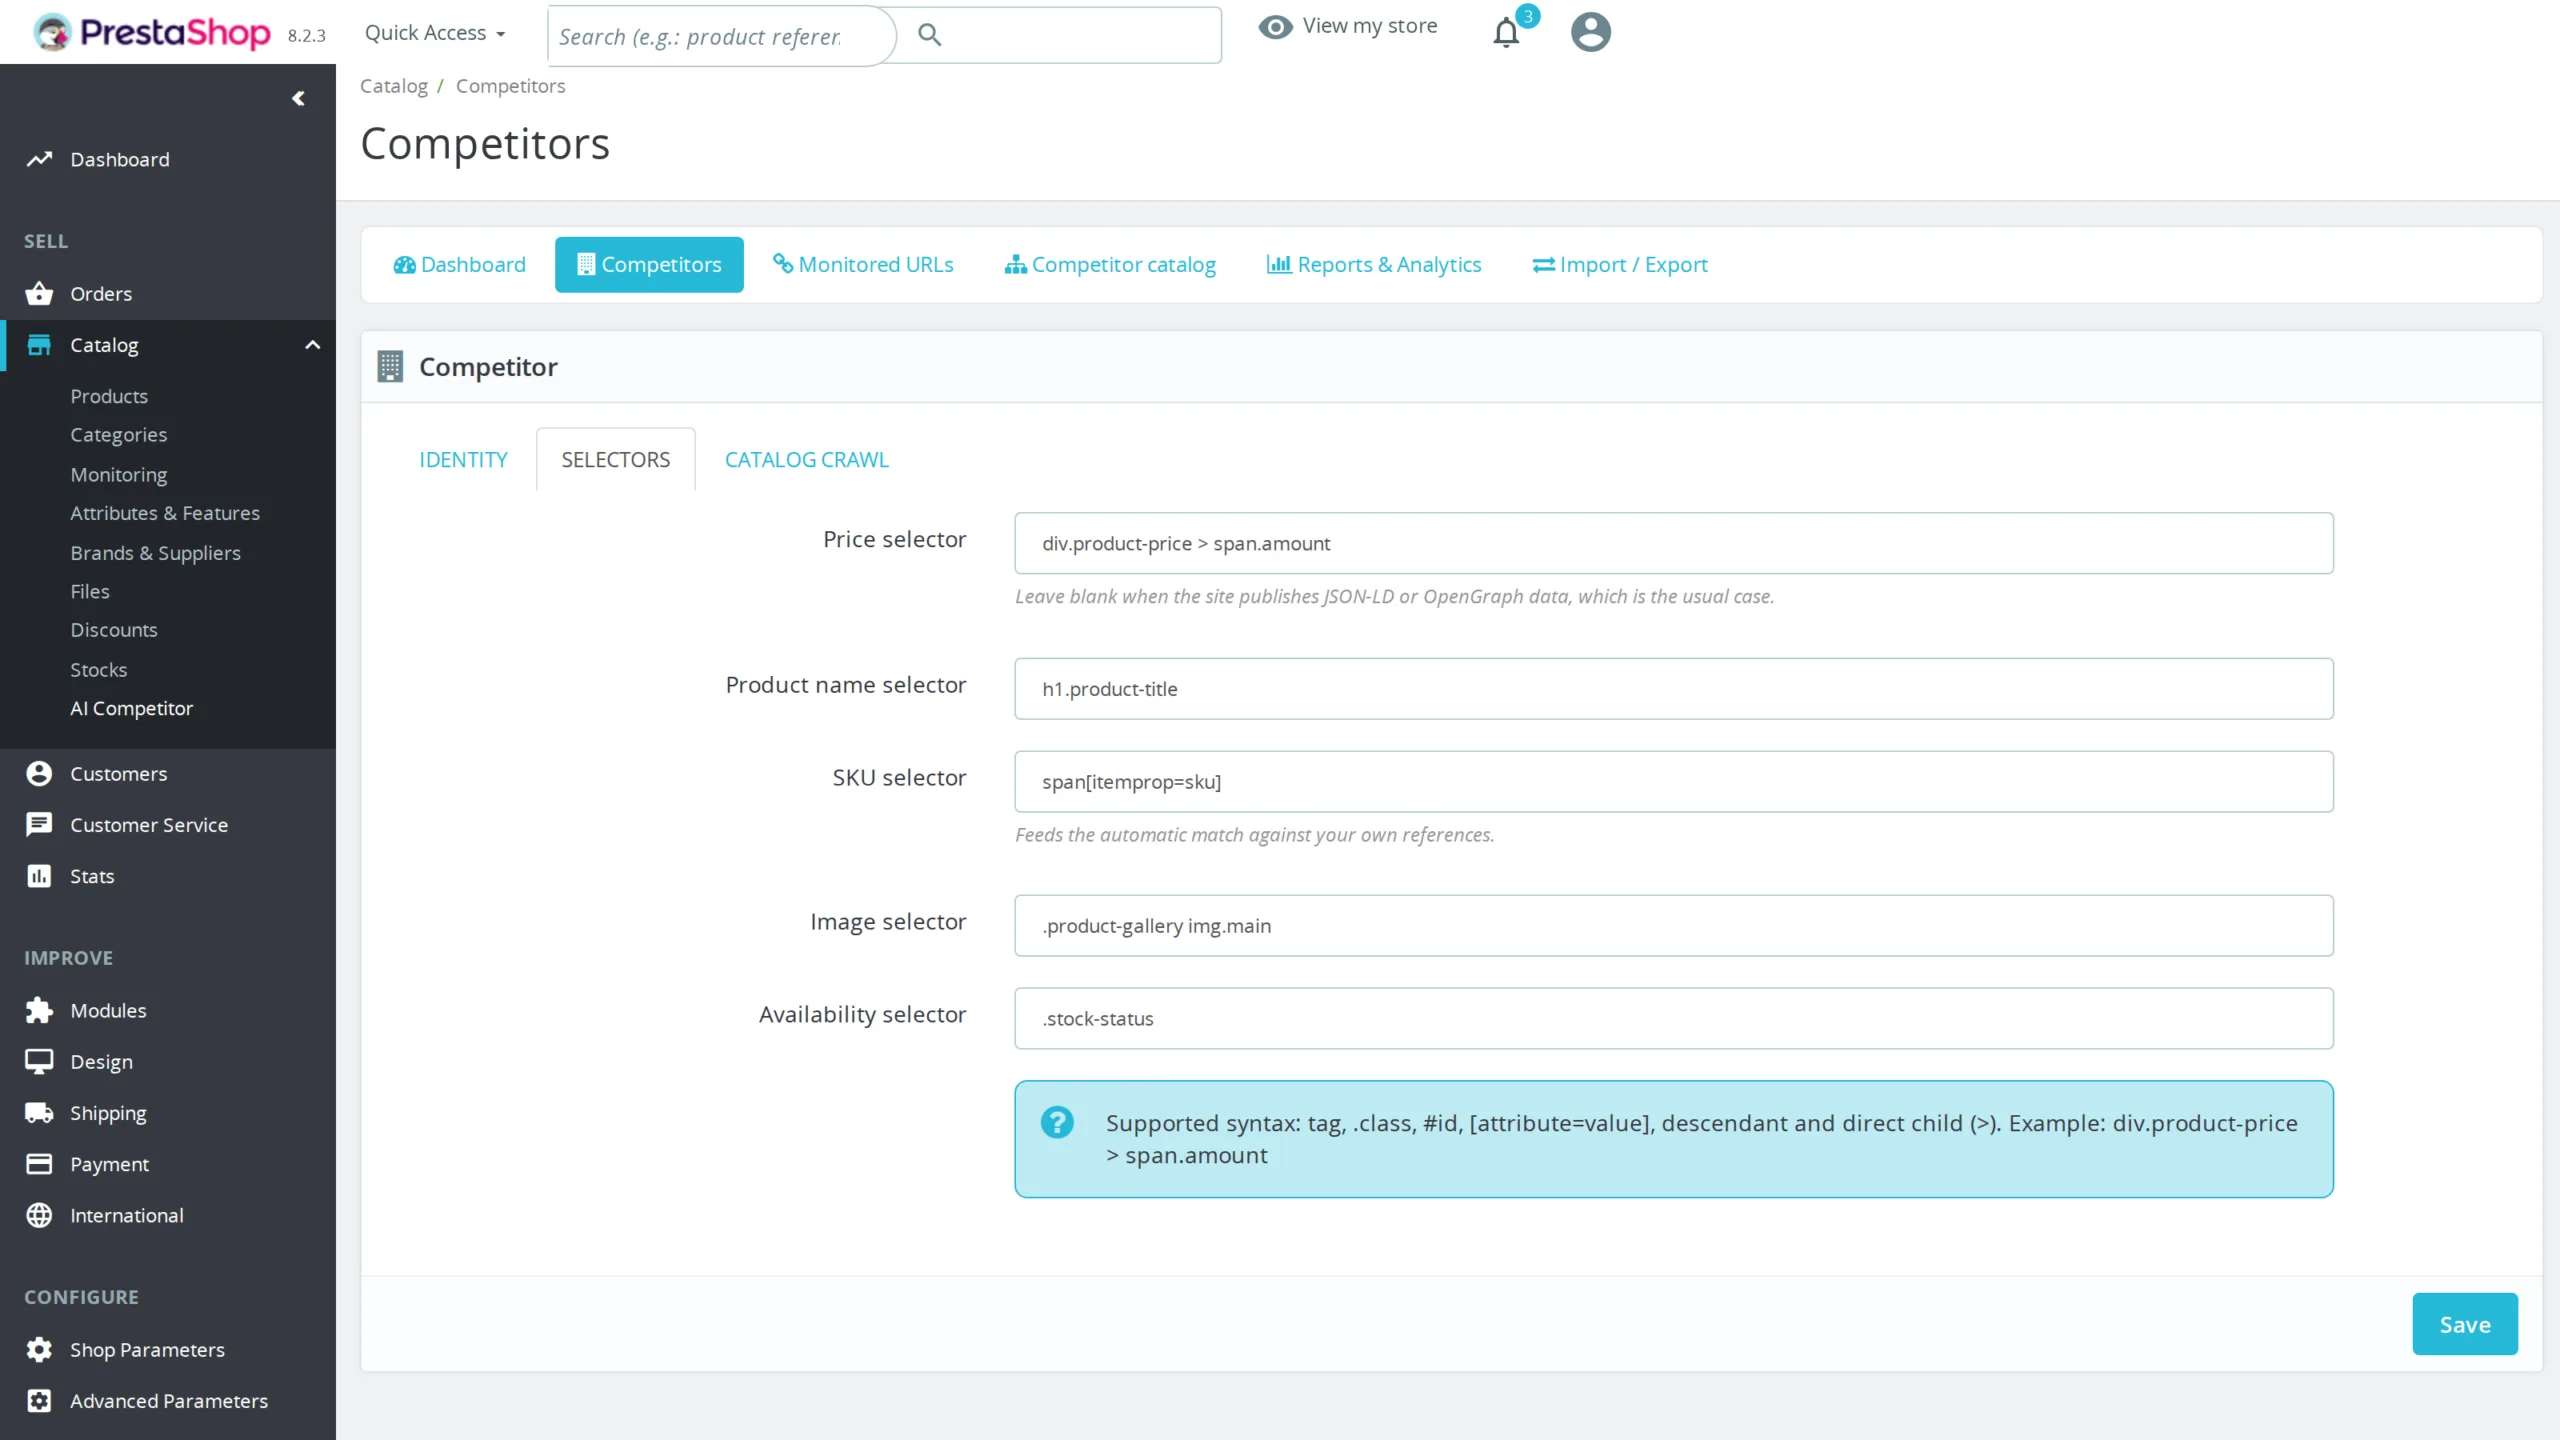
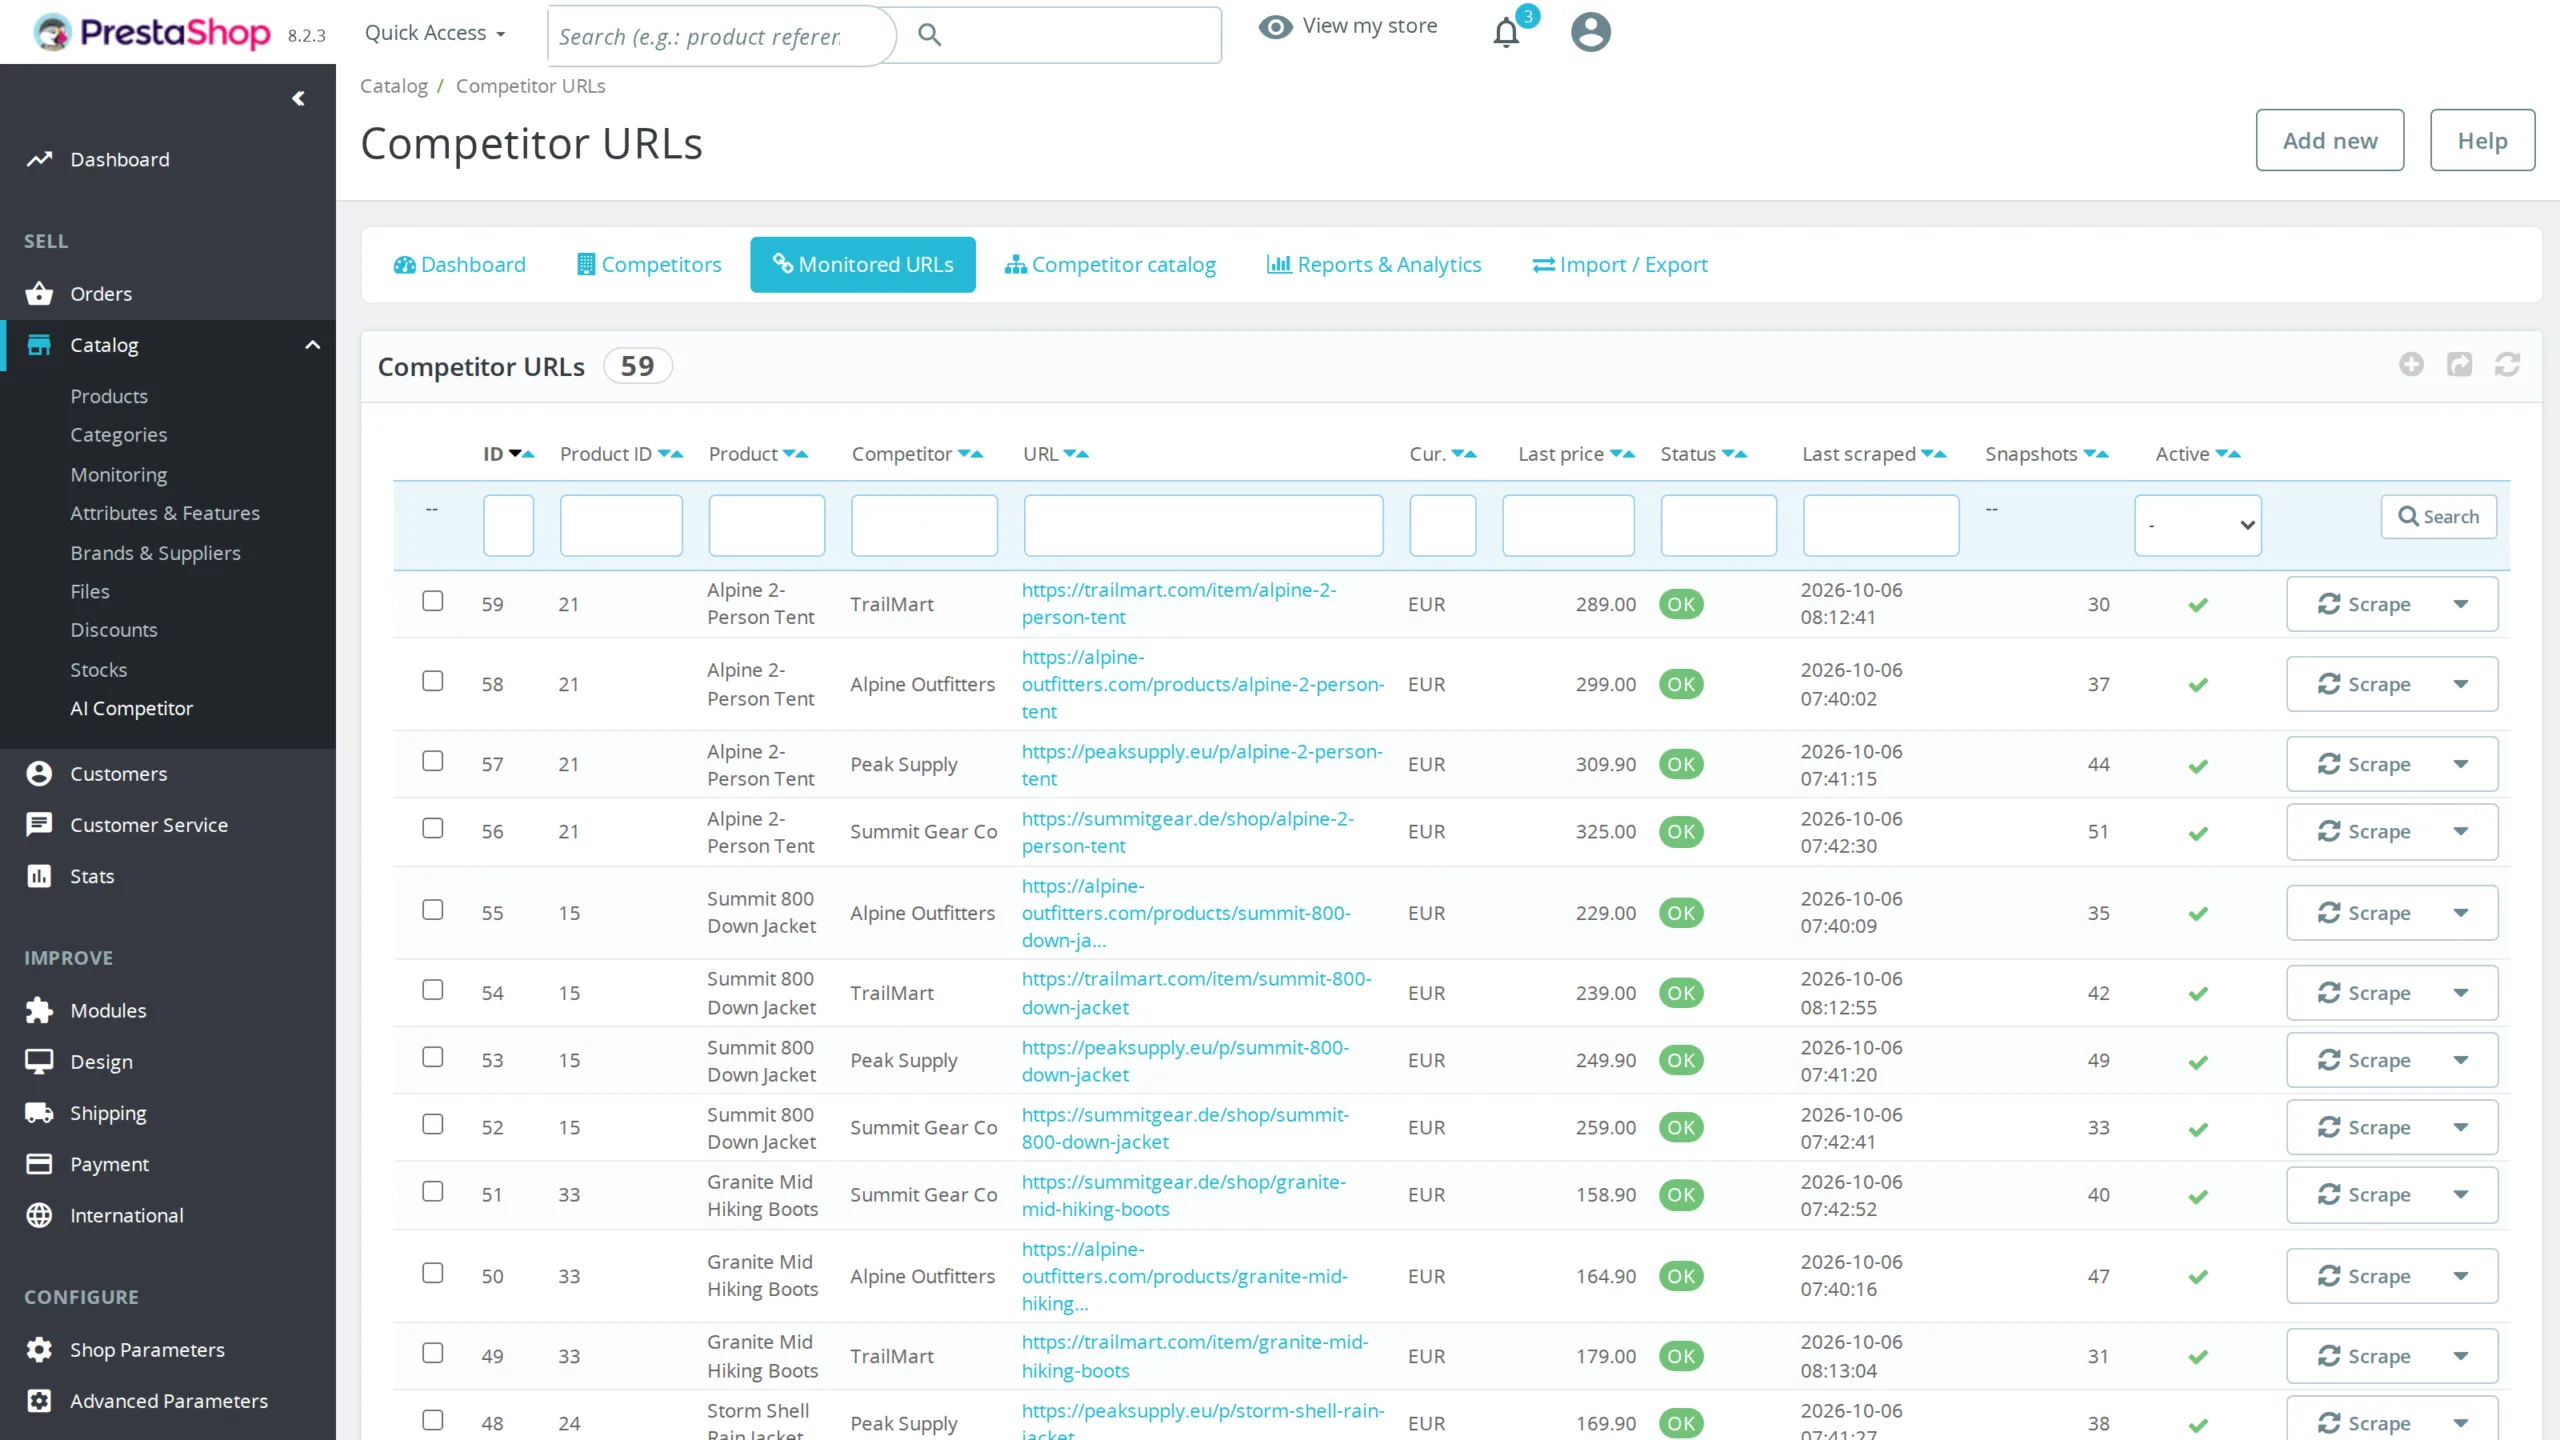
O nome do concorrente e os seus seletores CSS deixam de se reescrever em cada URL. Um concorrente é uma ficha: nome, domínio, seletor de preço, de título, de SKU, de imagem, de disponibilidade, moeda, intervalo de leitura, definições de rastreio. Qualquer URL associado herda tudo isso, e a associação faz-se automaticamente comparando o domínio do endereço introduzido. No dia em que um concorrente refaz o site e parte um seletor, corrige-o na ficha do concorrente e a correção propaga-se a todos os seus URLs.
Levar a sua configuração de uma loja para outra
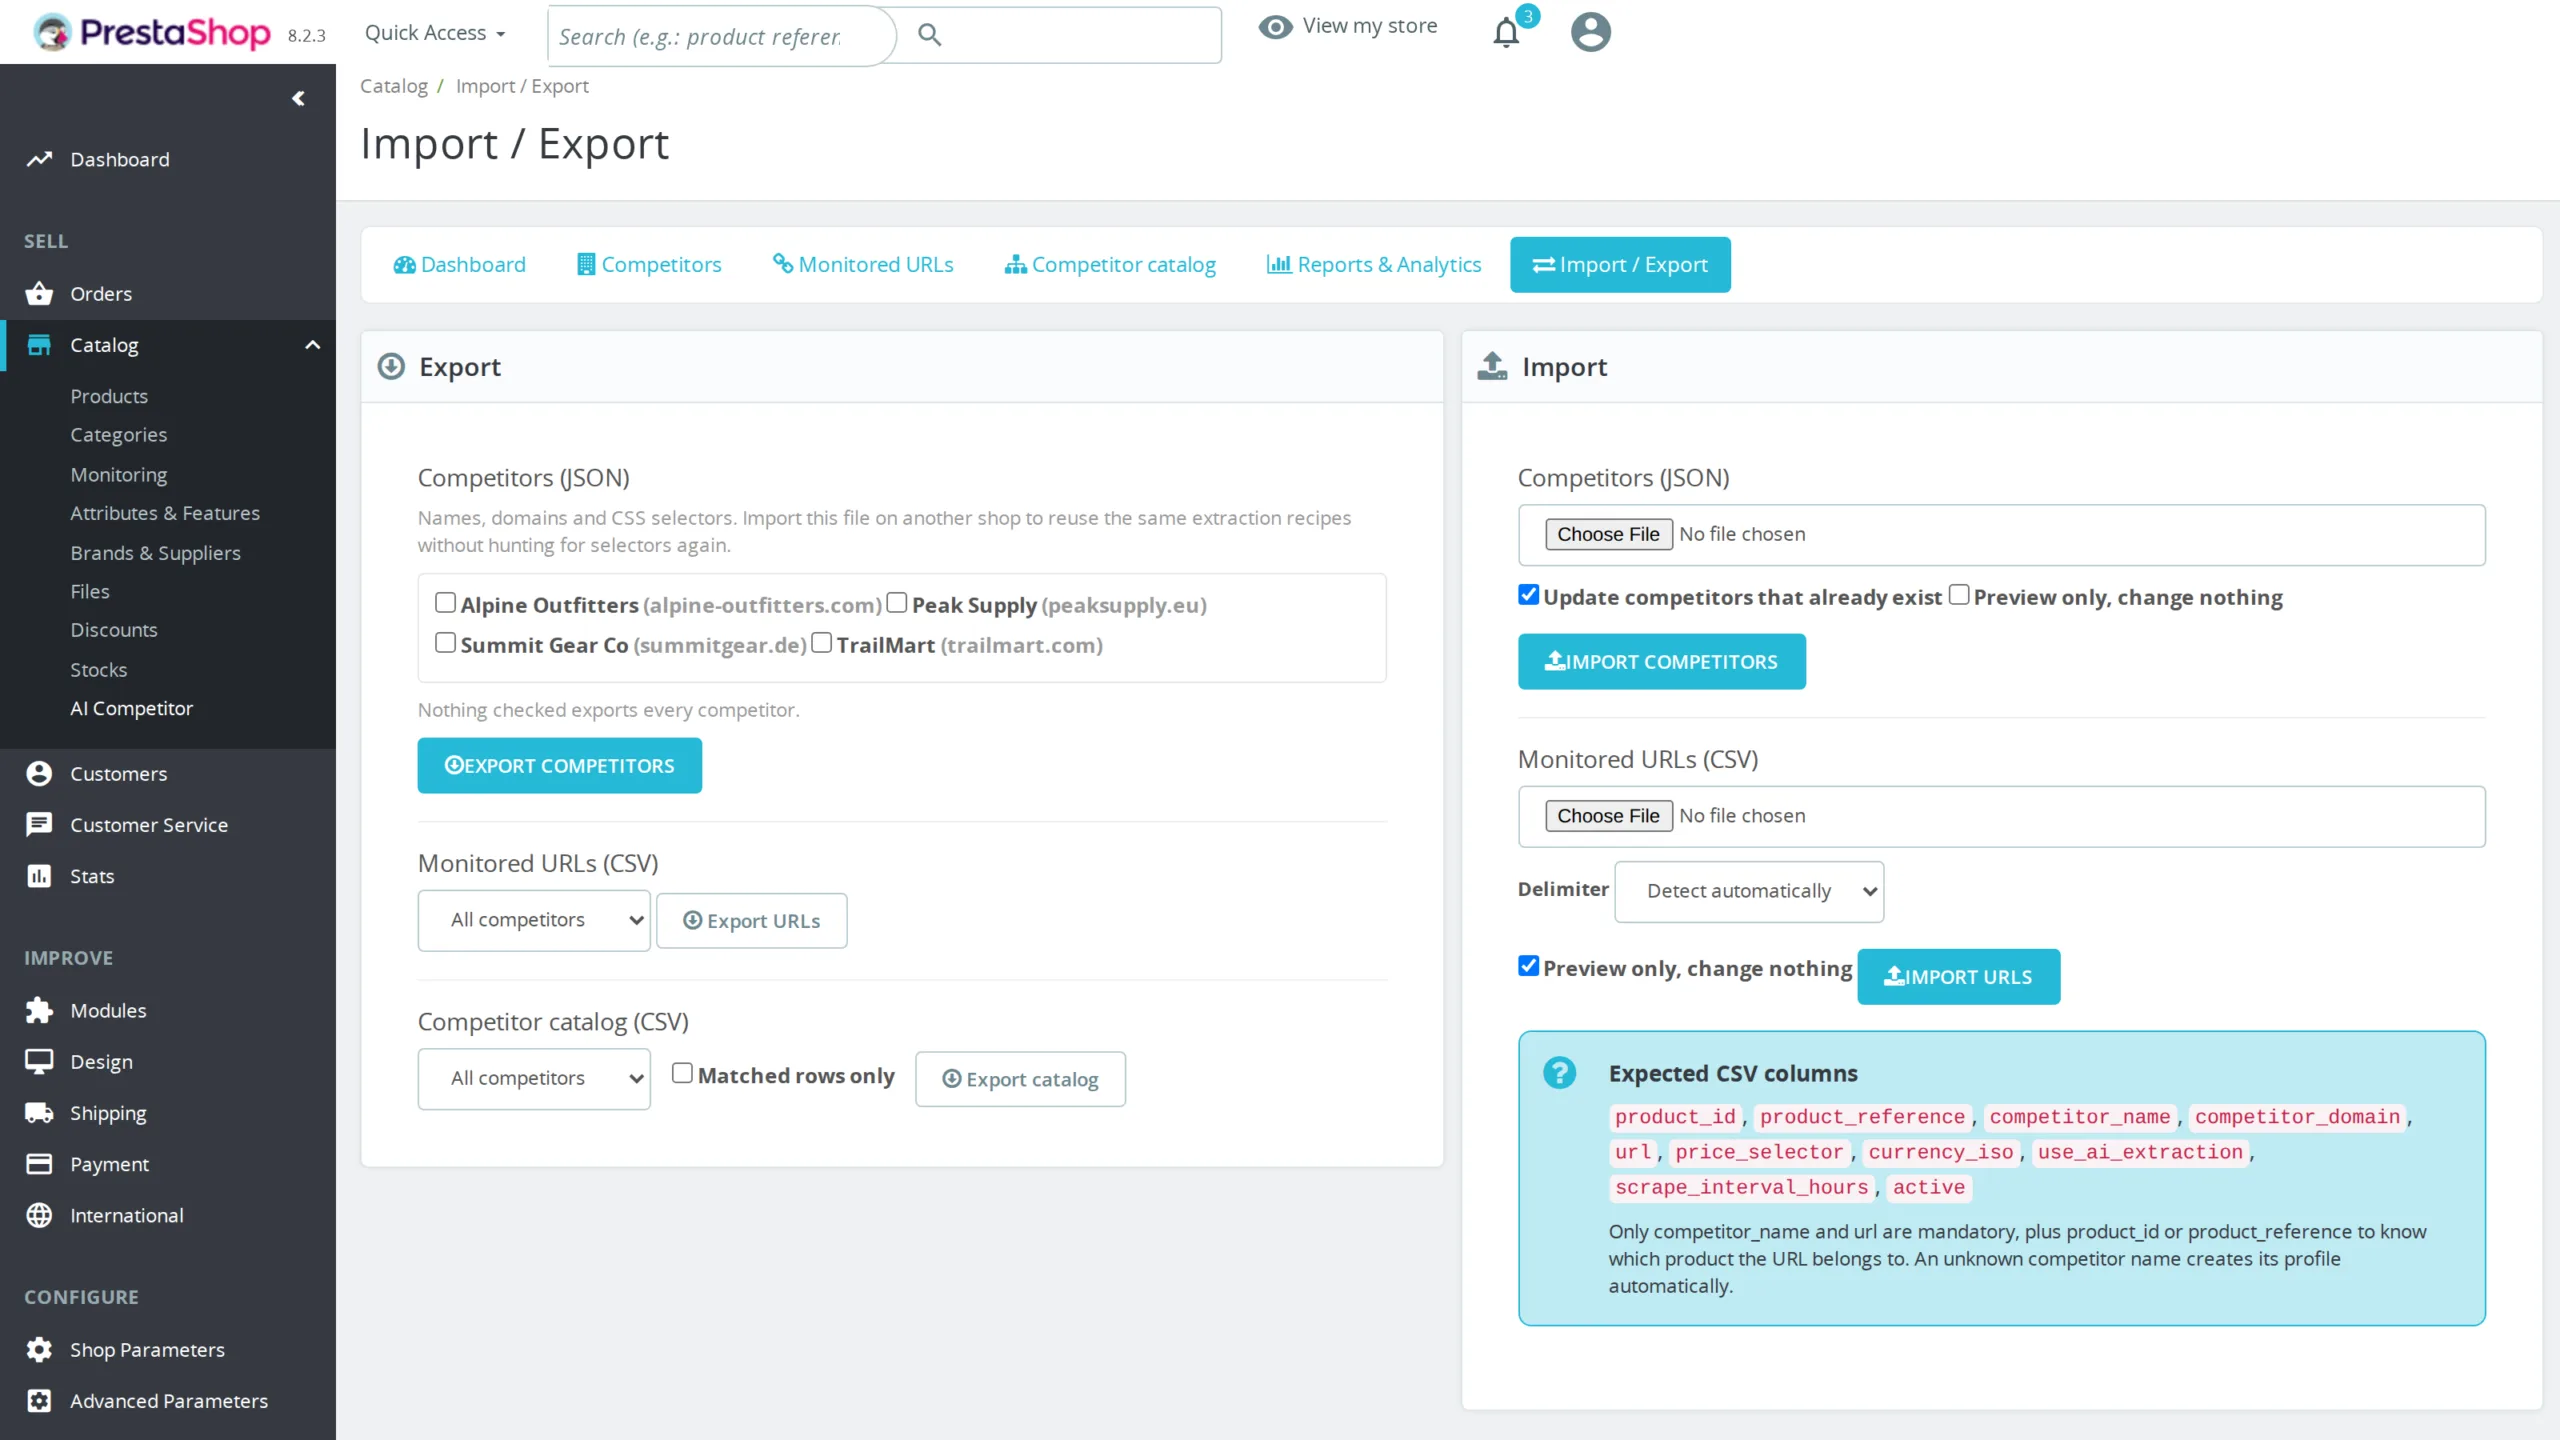
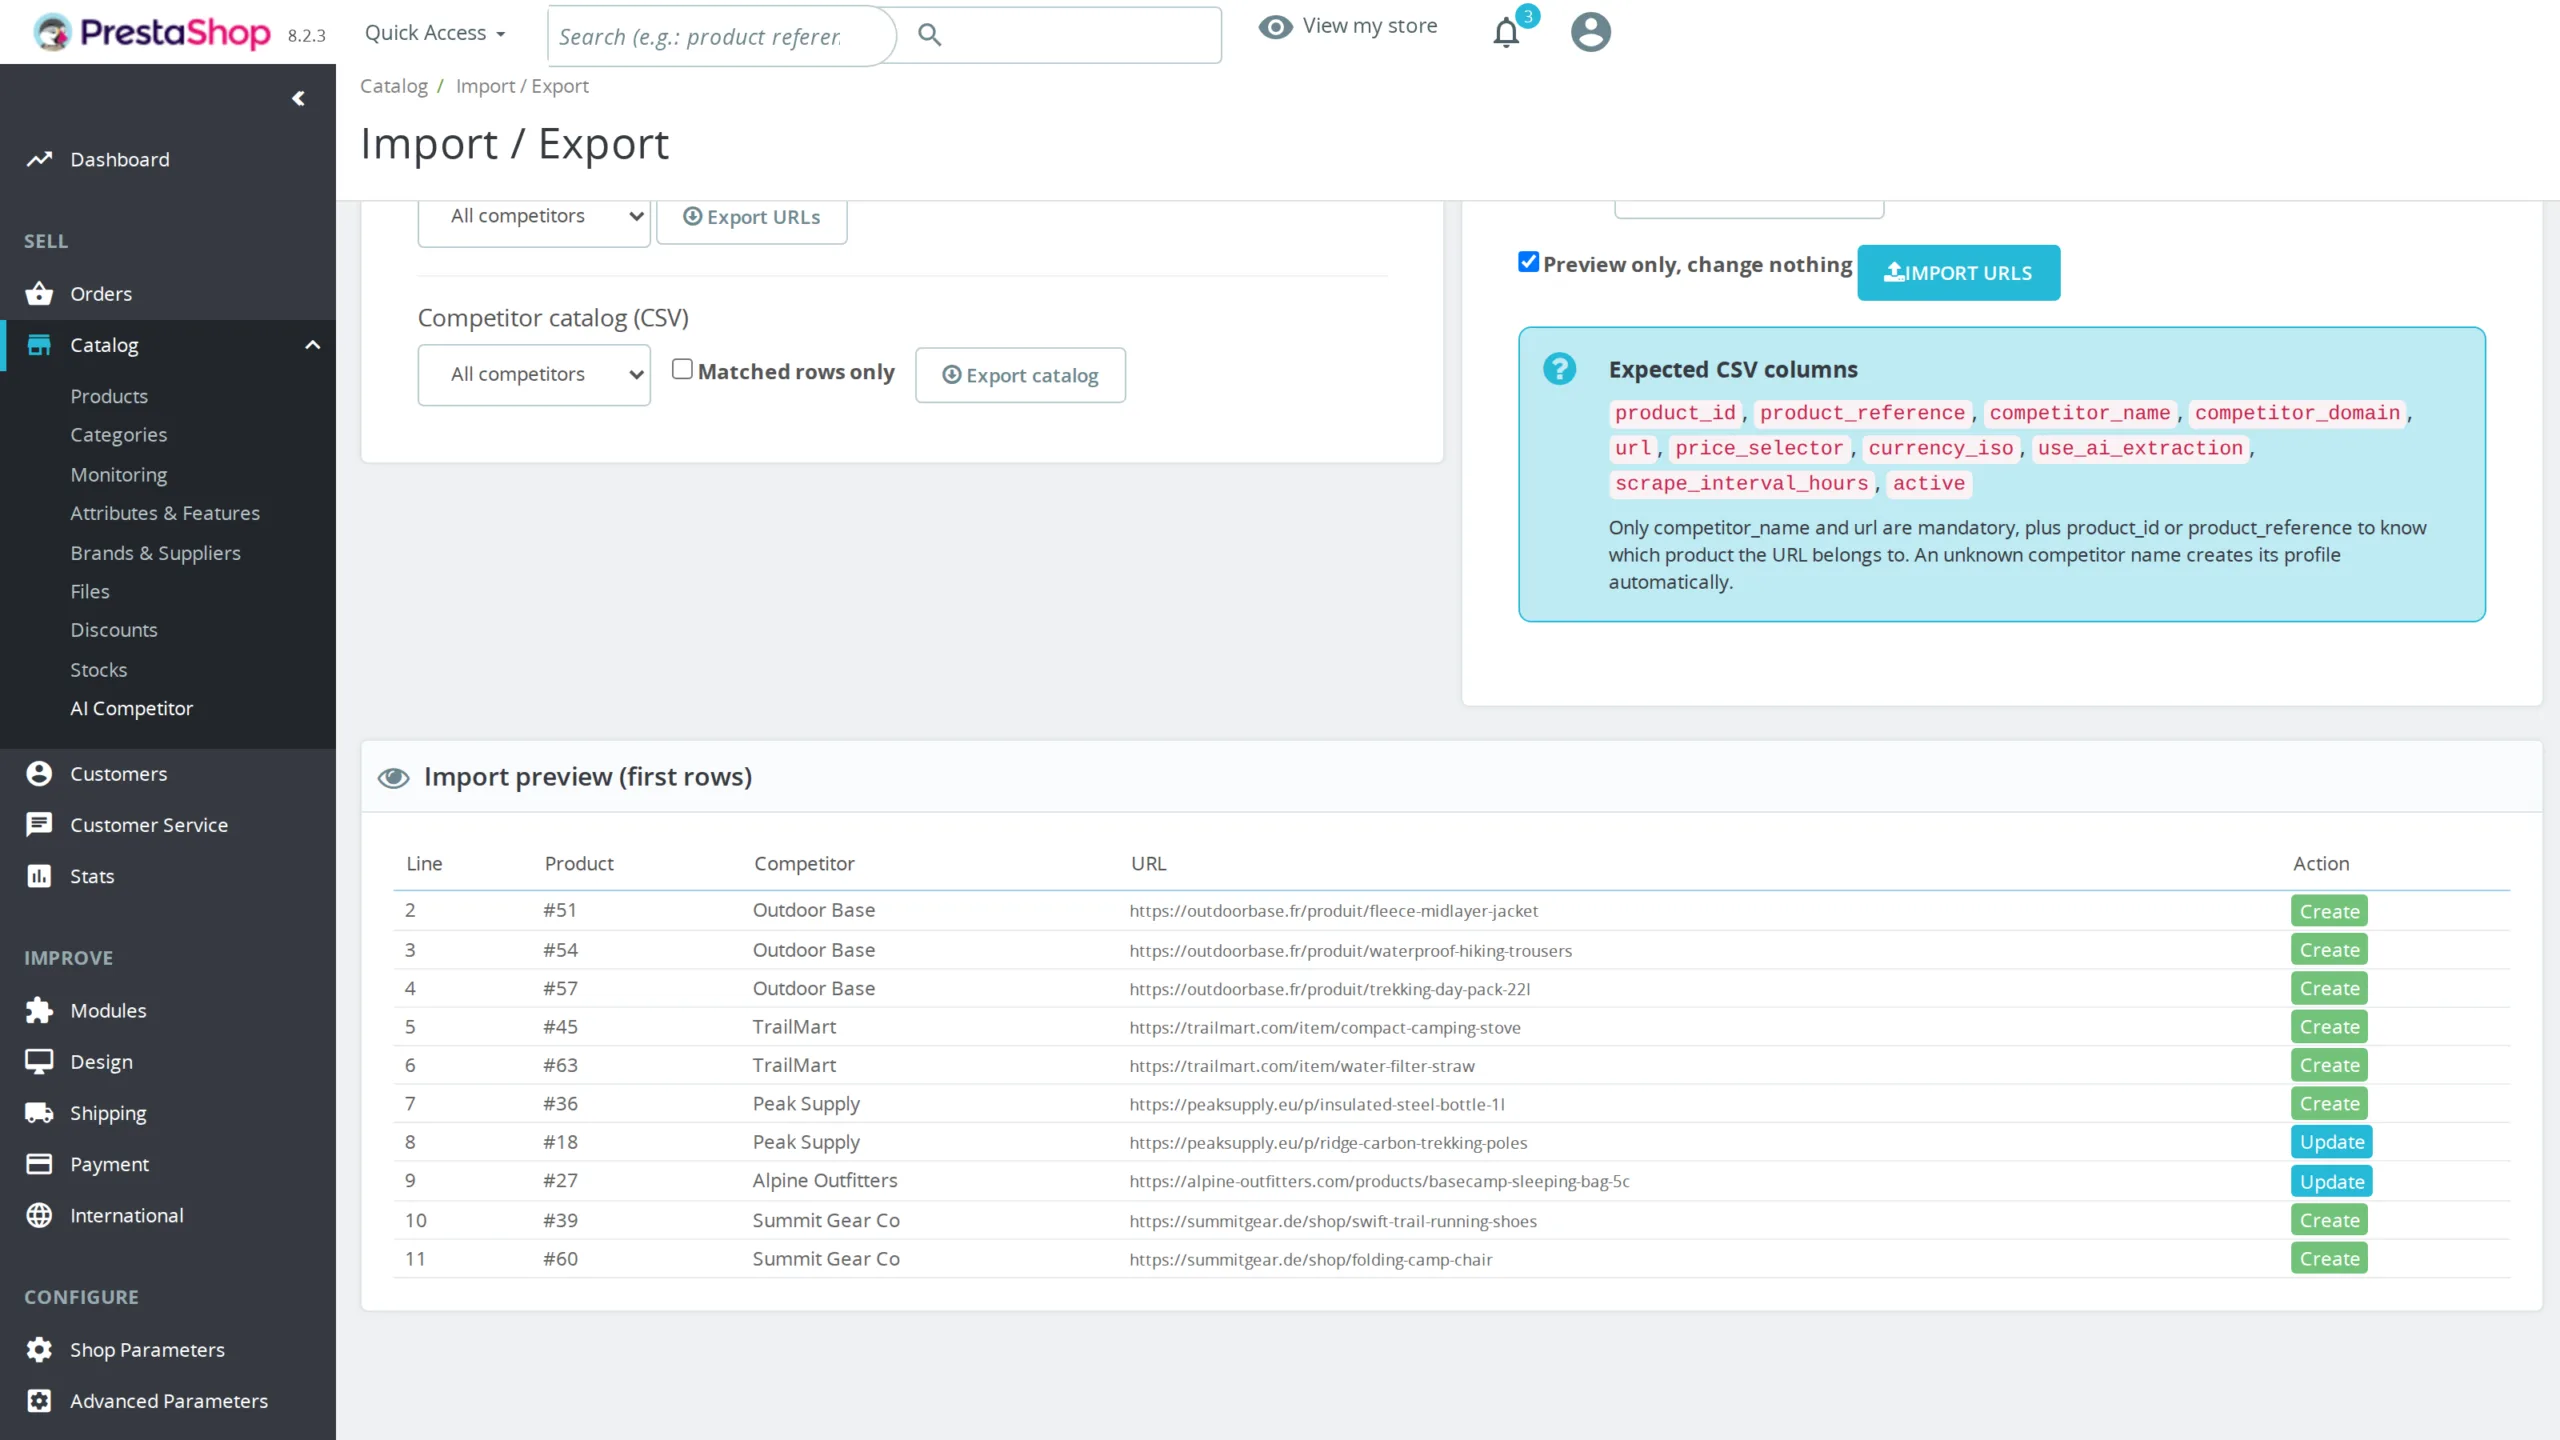
A biblioteca de concorrentes exporta-se num ficheiro JSON e reimporta-se noutro lado. As receitas de extração que afinou numa loja servem de imediato na seguinte, em vez de serem redescobertas seletor a seletor. Os URLs monitorizados viajam em CSV: o produto é encontrado por identificador ou por referência, e um nome de concorrente desconhecido cria a sua ficha na hora, de modo que um único ficheiro basta para arrancar uma instalação inteira. O separador é detetado automaticamente, e a importação arranca em modo de pré-visualização, que relata linha a linha o que seria criado, atualizado ou ignorado antes da menor escrita.
Uma extração de preços que nunca parte
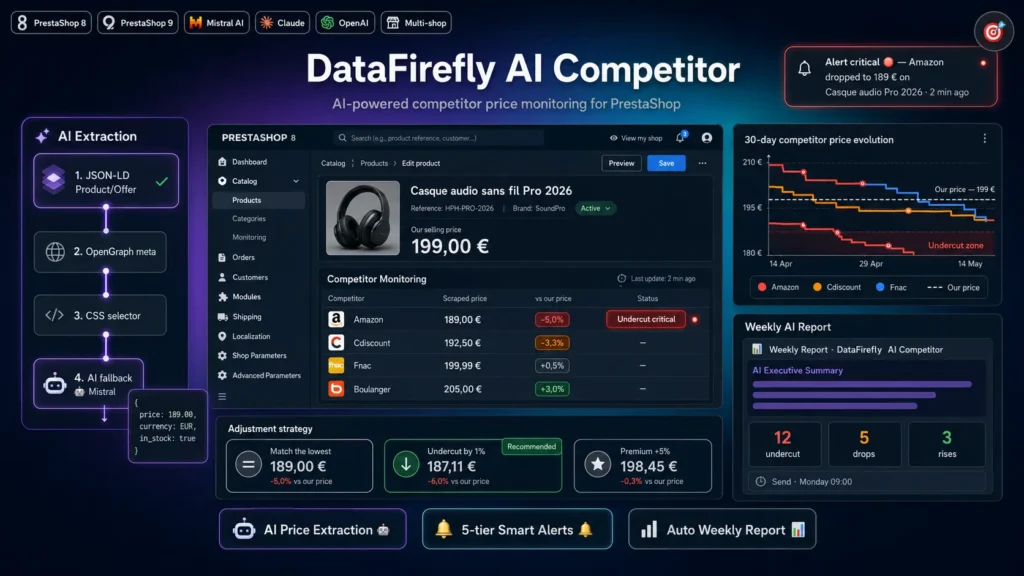
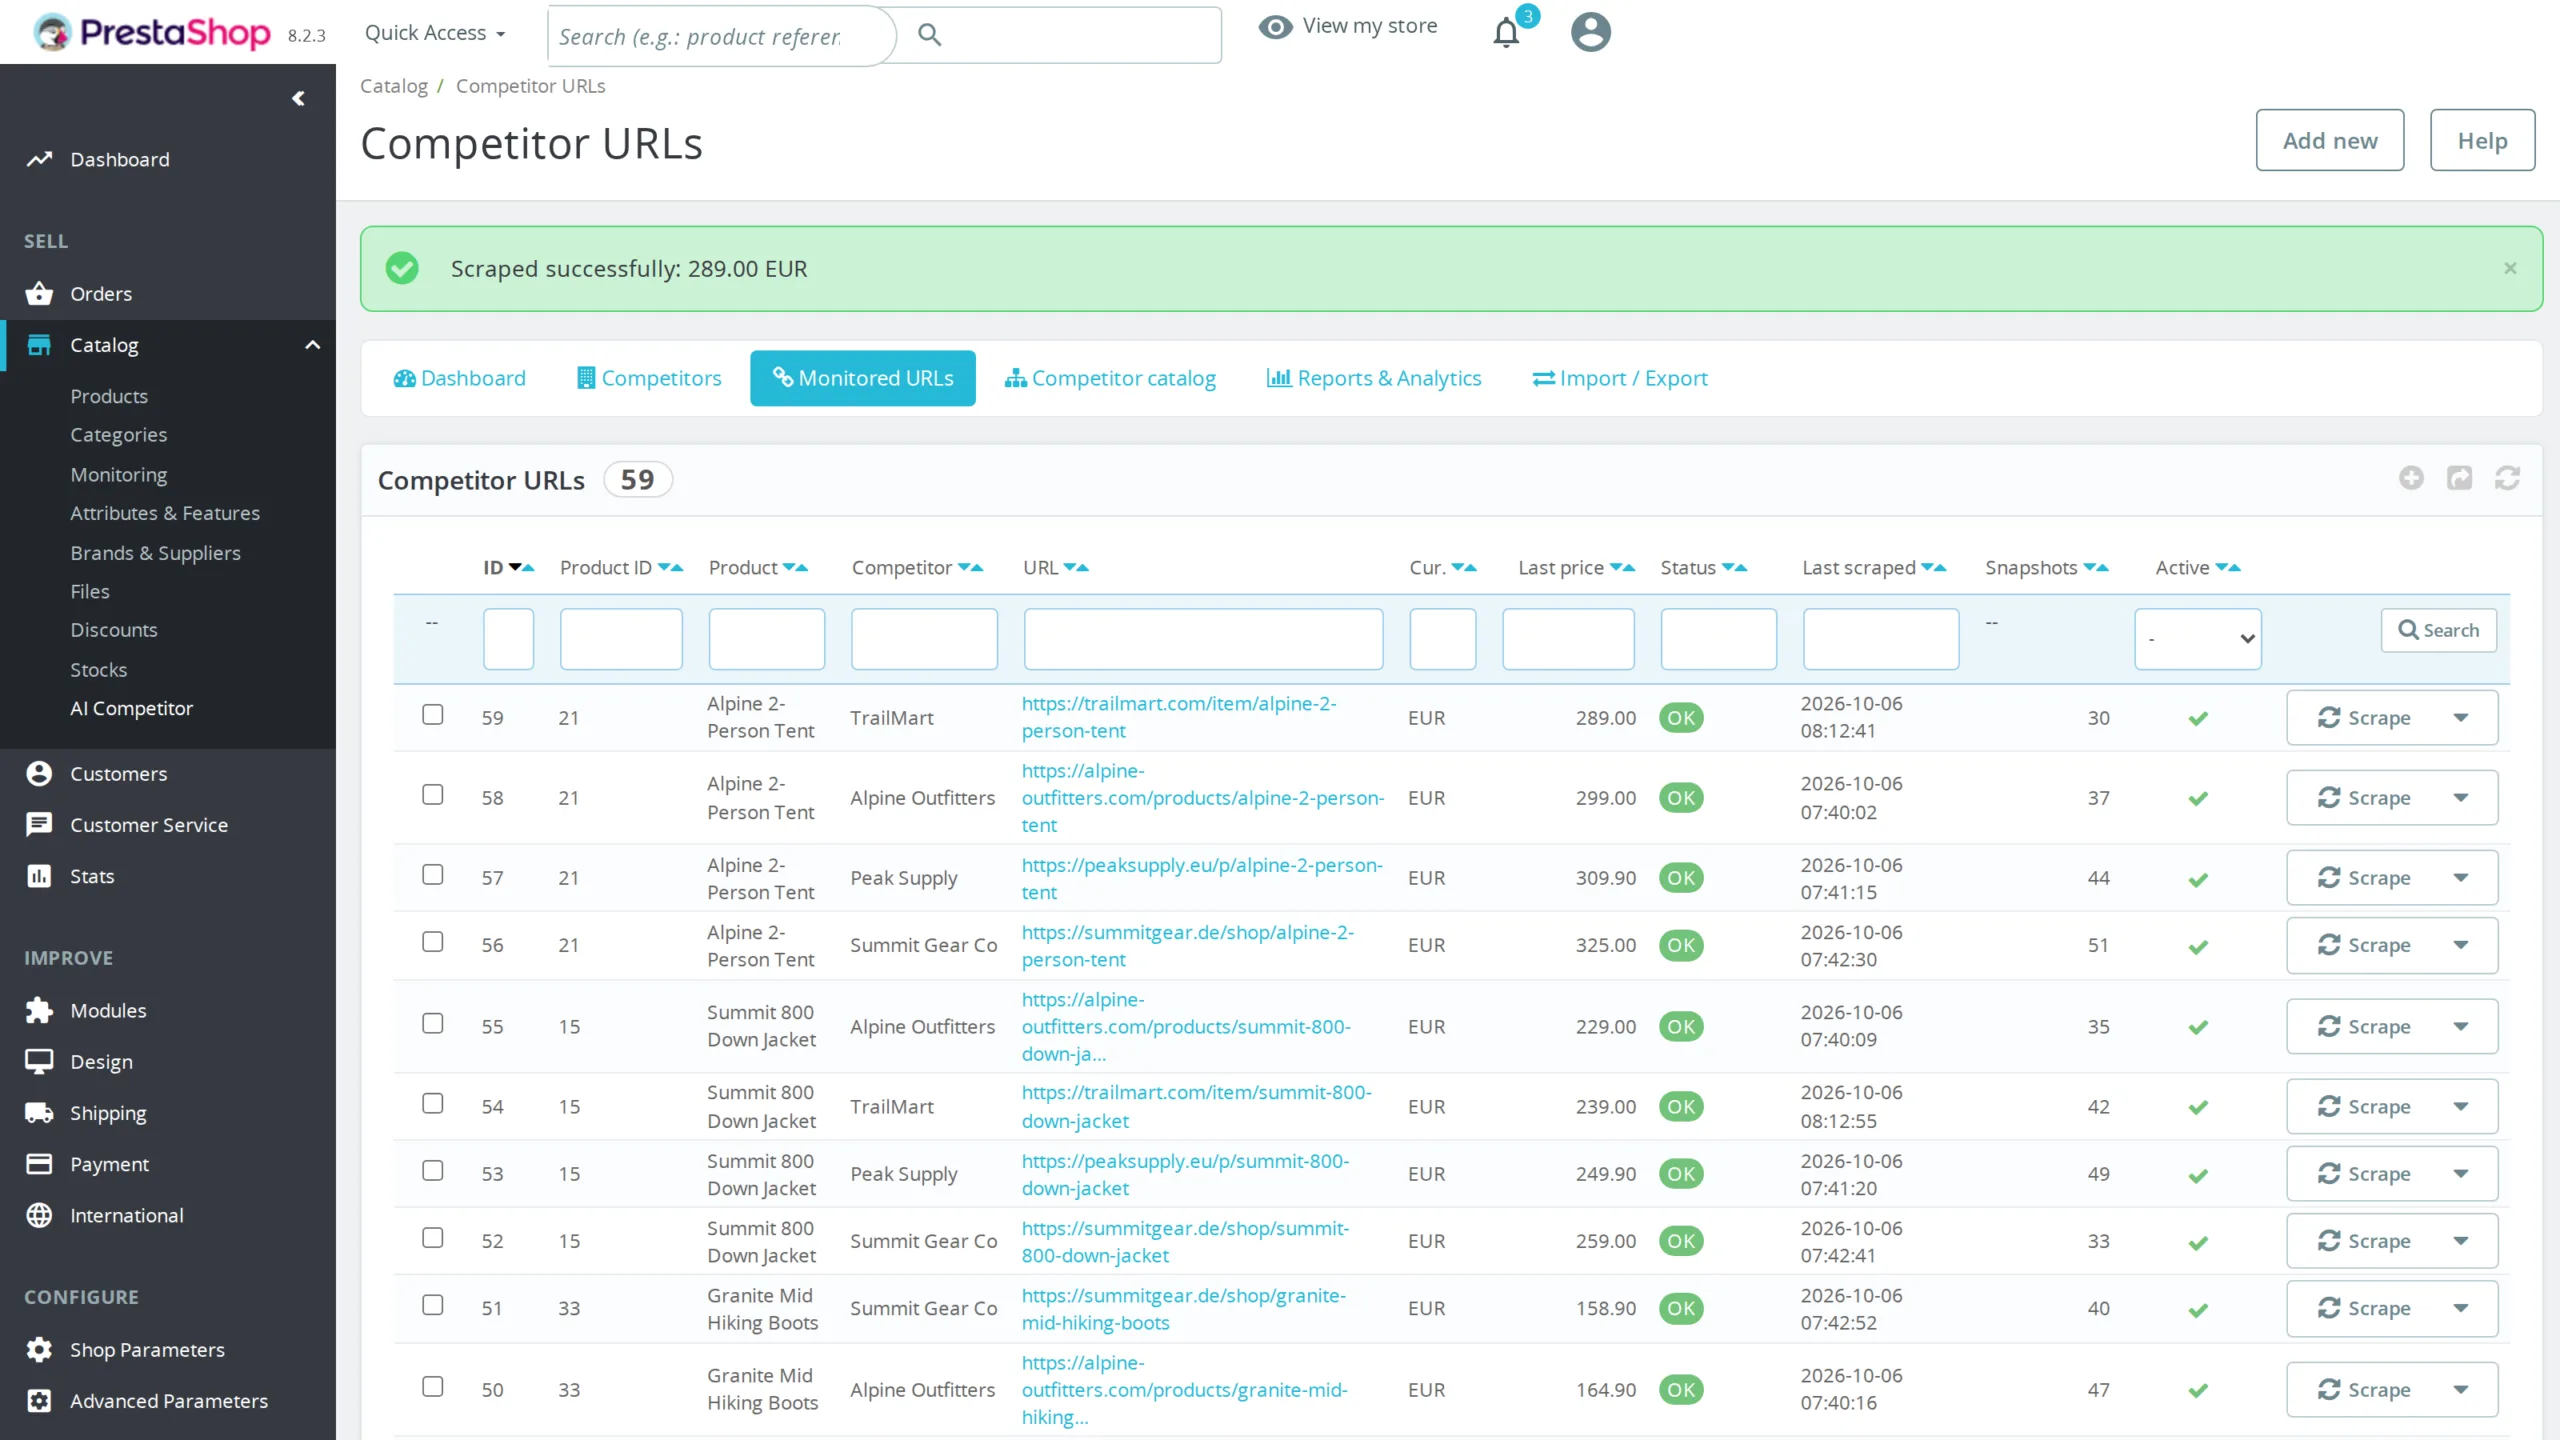
O módulo tenta em cascata vários métodos de extração para cada URL. Primeiro os dados estruturados JSON-LD Product/Offer, presentes na maioria dos sites modernos. Depois as etiquetas OpenGraph product price amount. Depois o seu seletor CSS se indicou um. E em último recurso a IA: um excerto HTML limpo é enviado ao fornecedor à sua escolha, que devolve o preço, a moeda e o estado de stock em formato JSON estrito. Na prática, mesmo que um concorrente refaça o site amanhã, a sua vigilância continua a funcionar.
Análises que respondem à pergunta útil
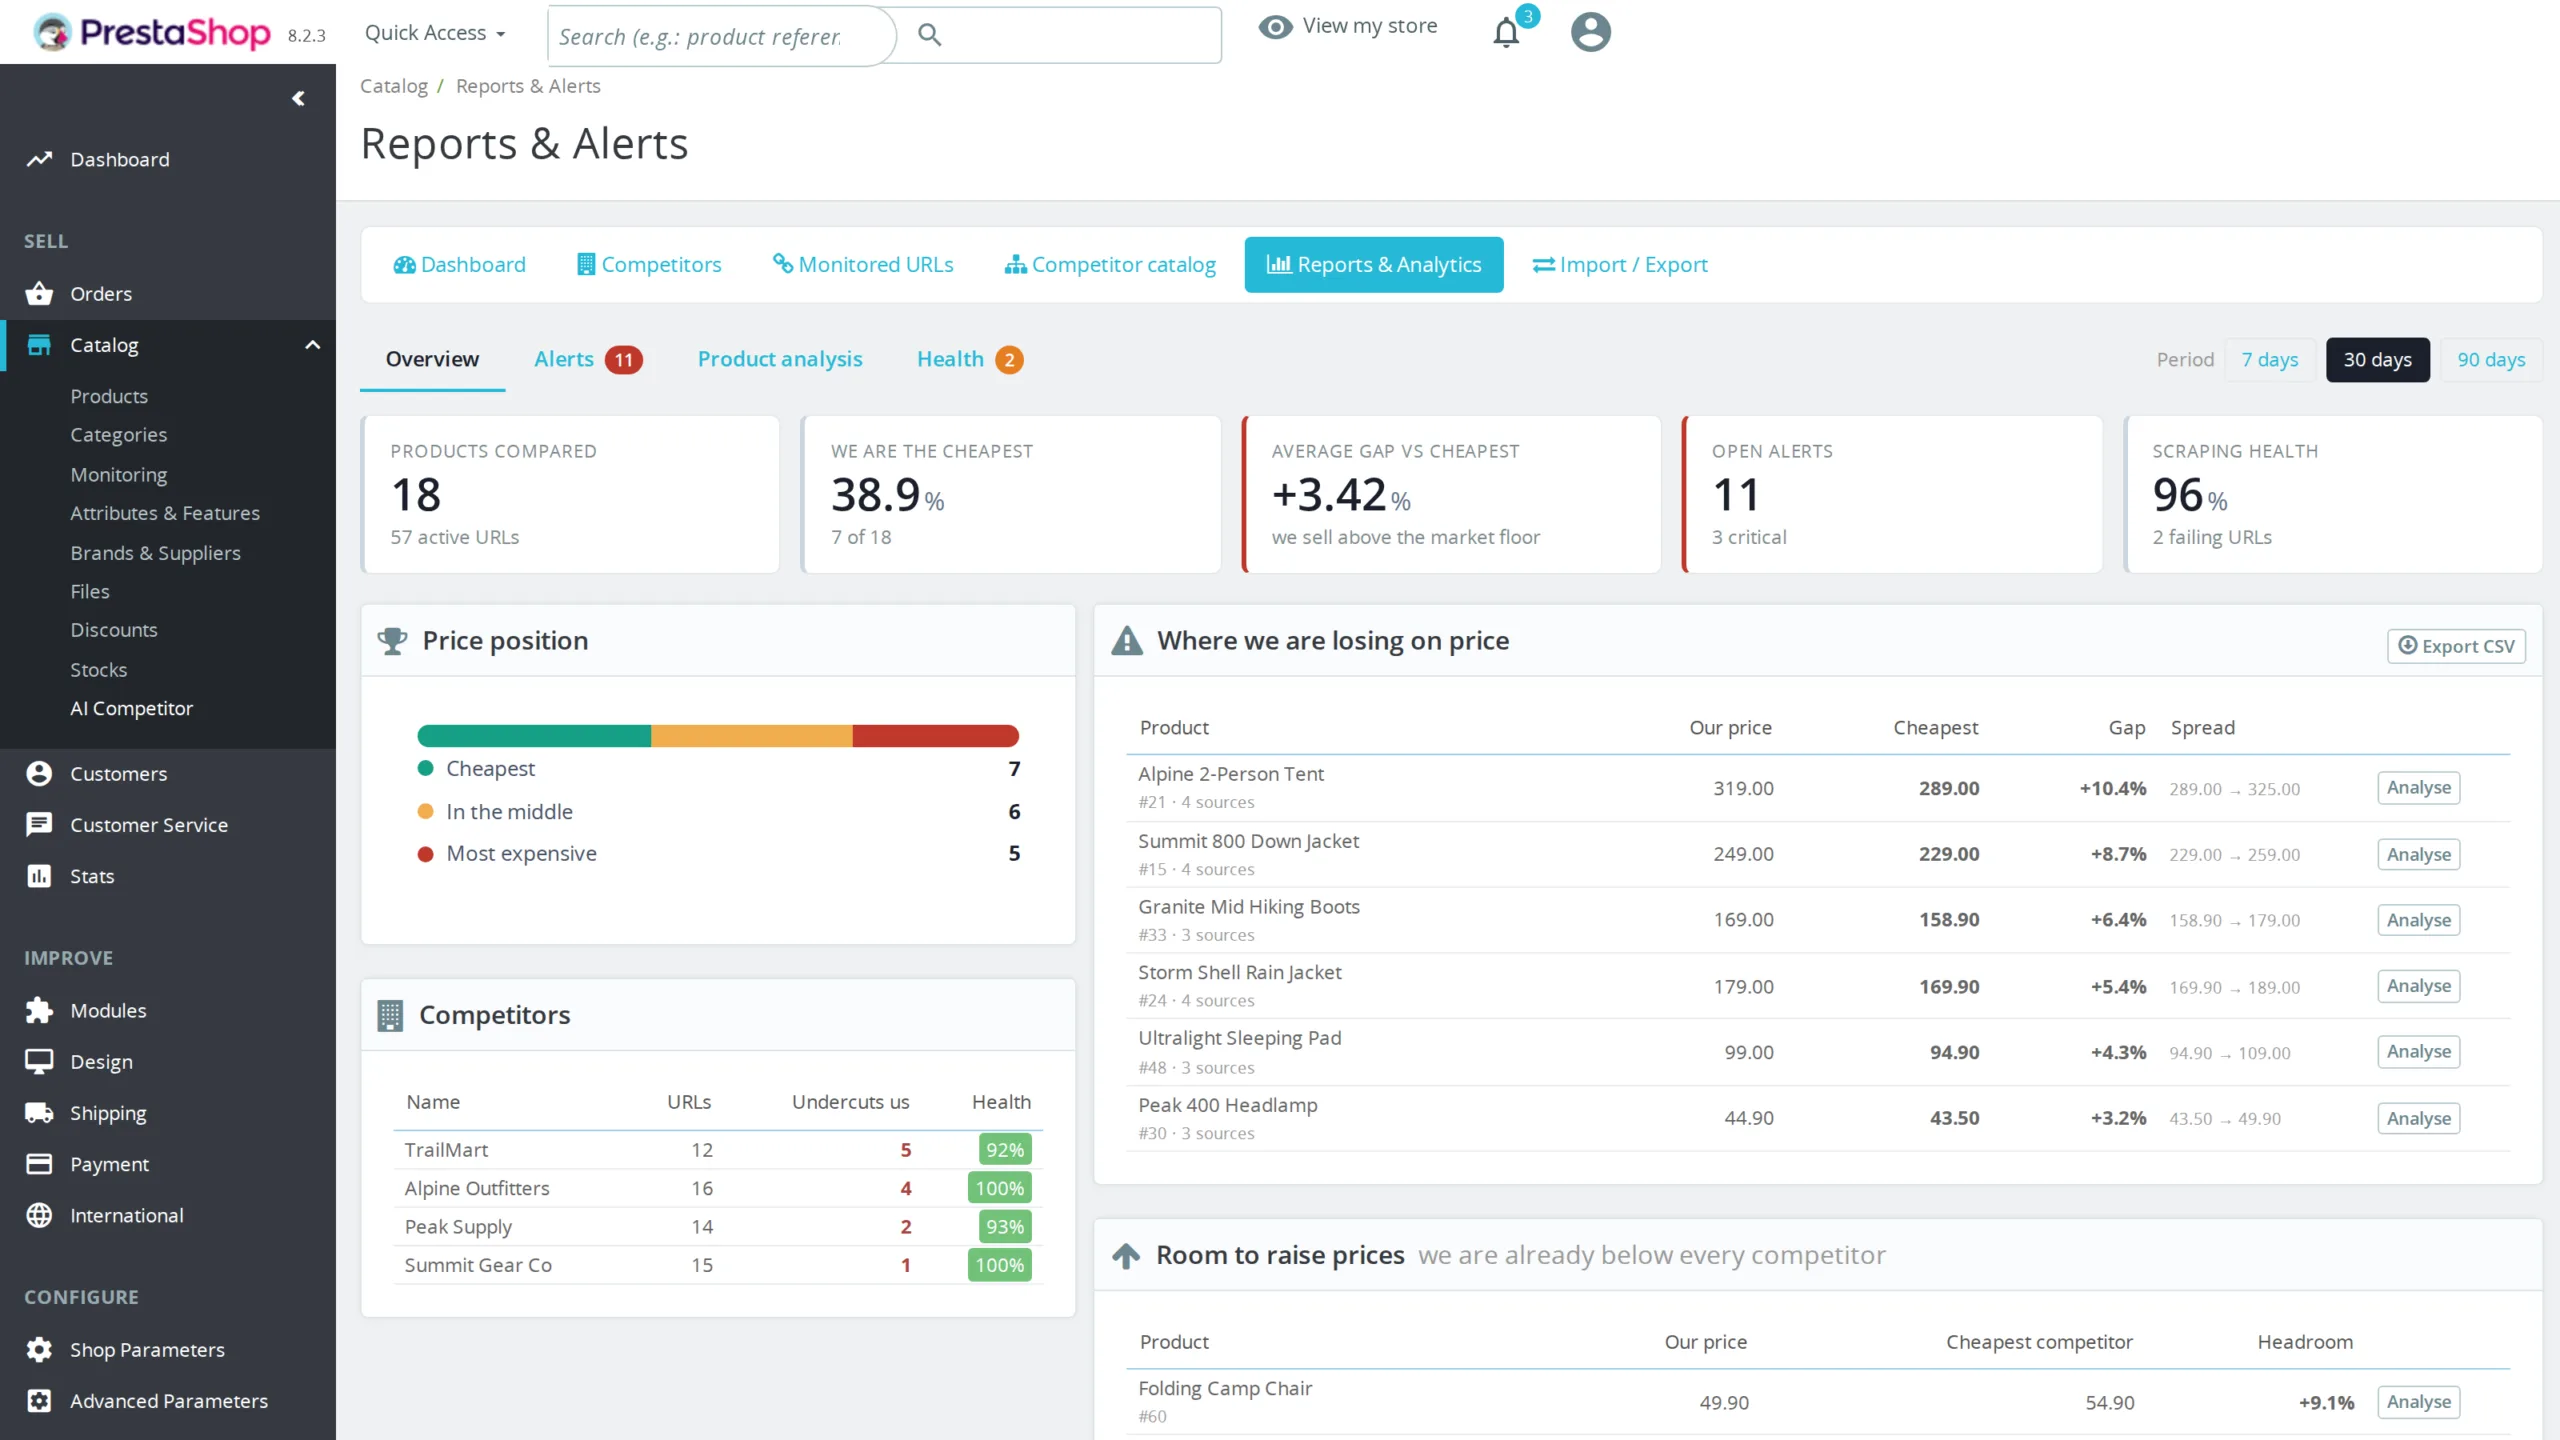
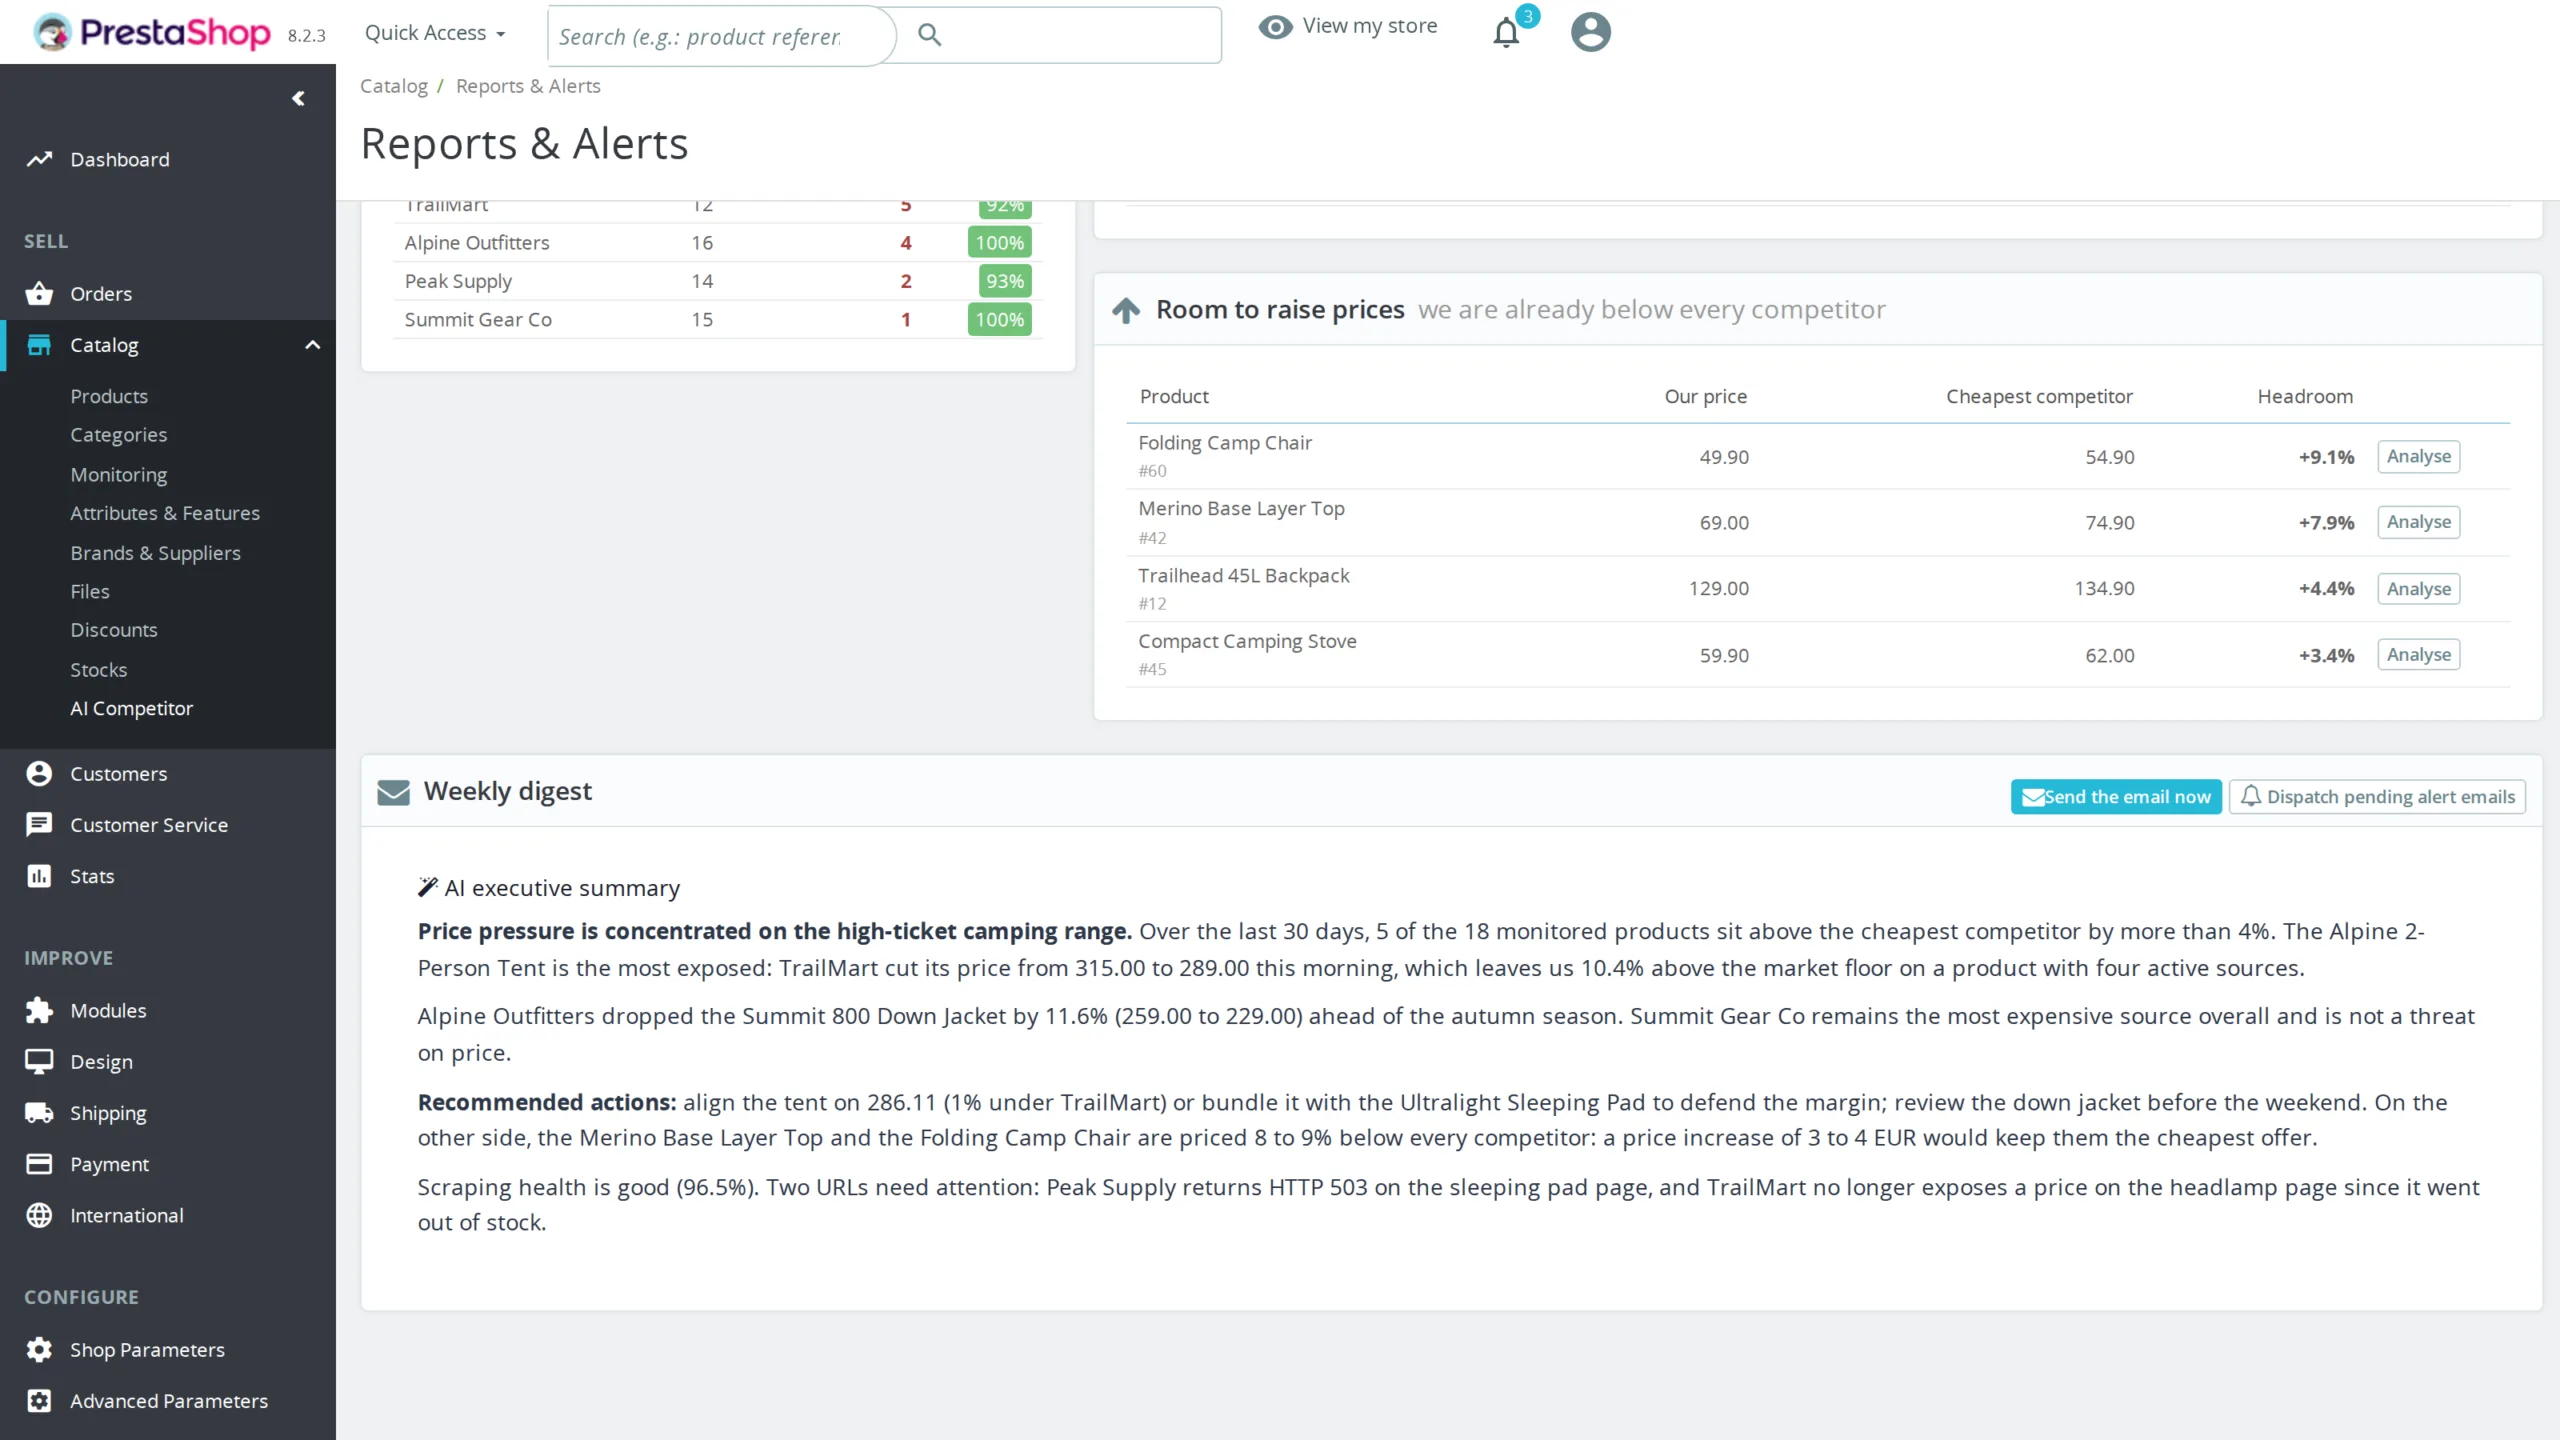
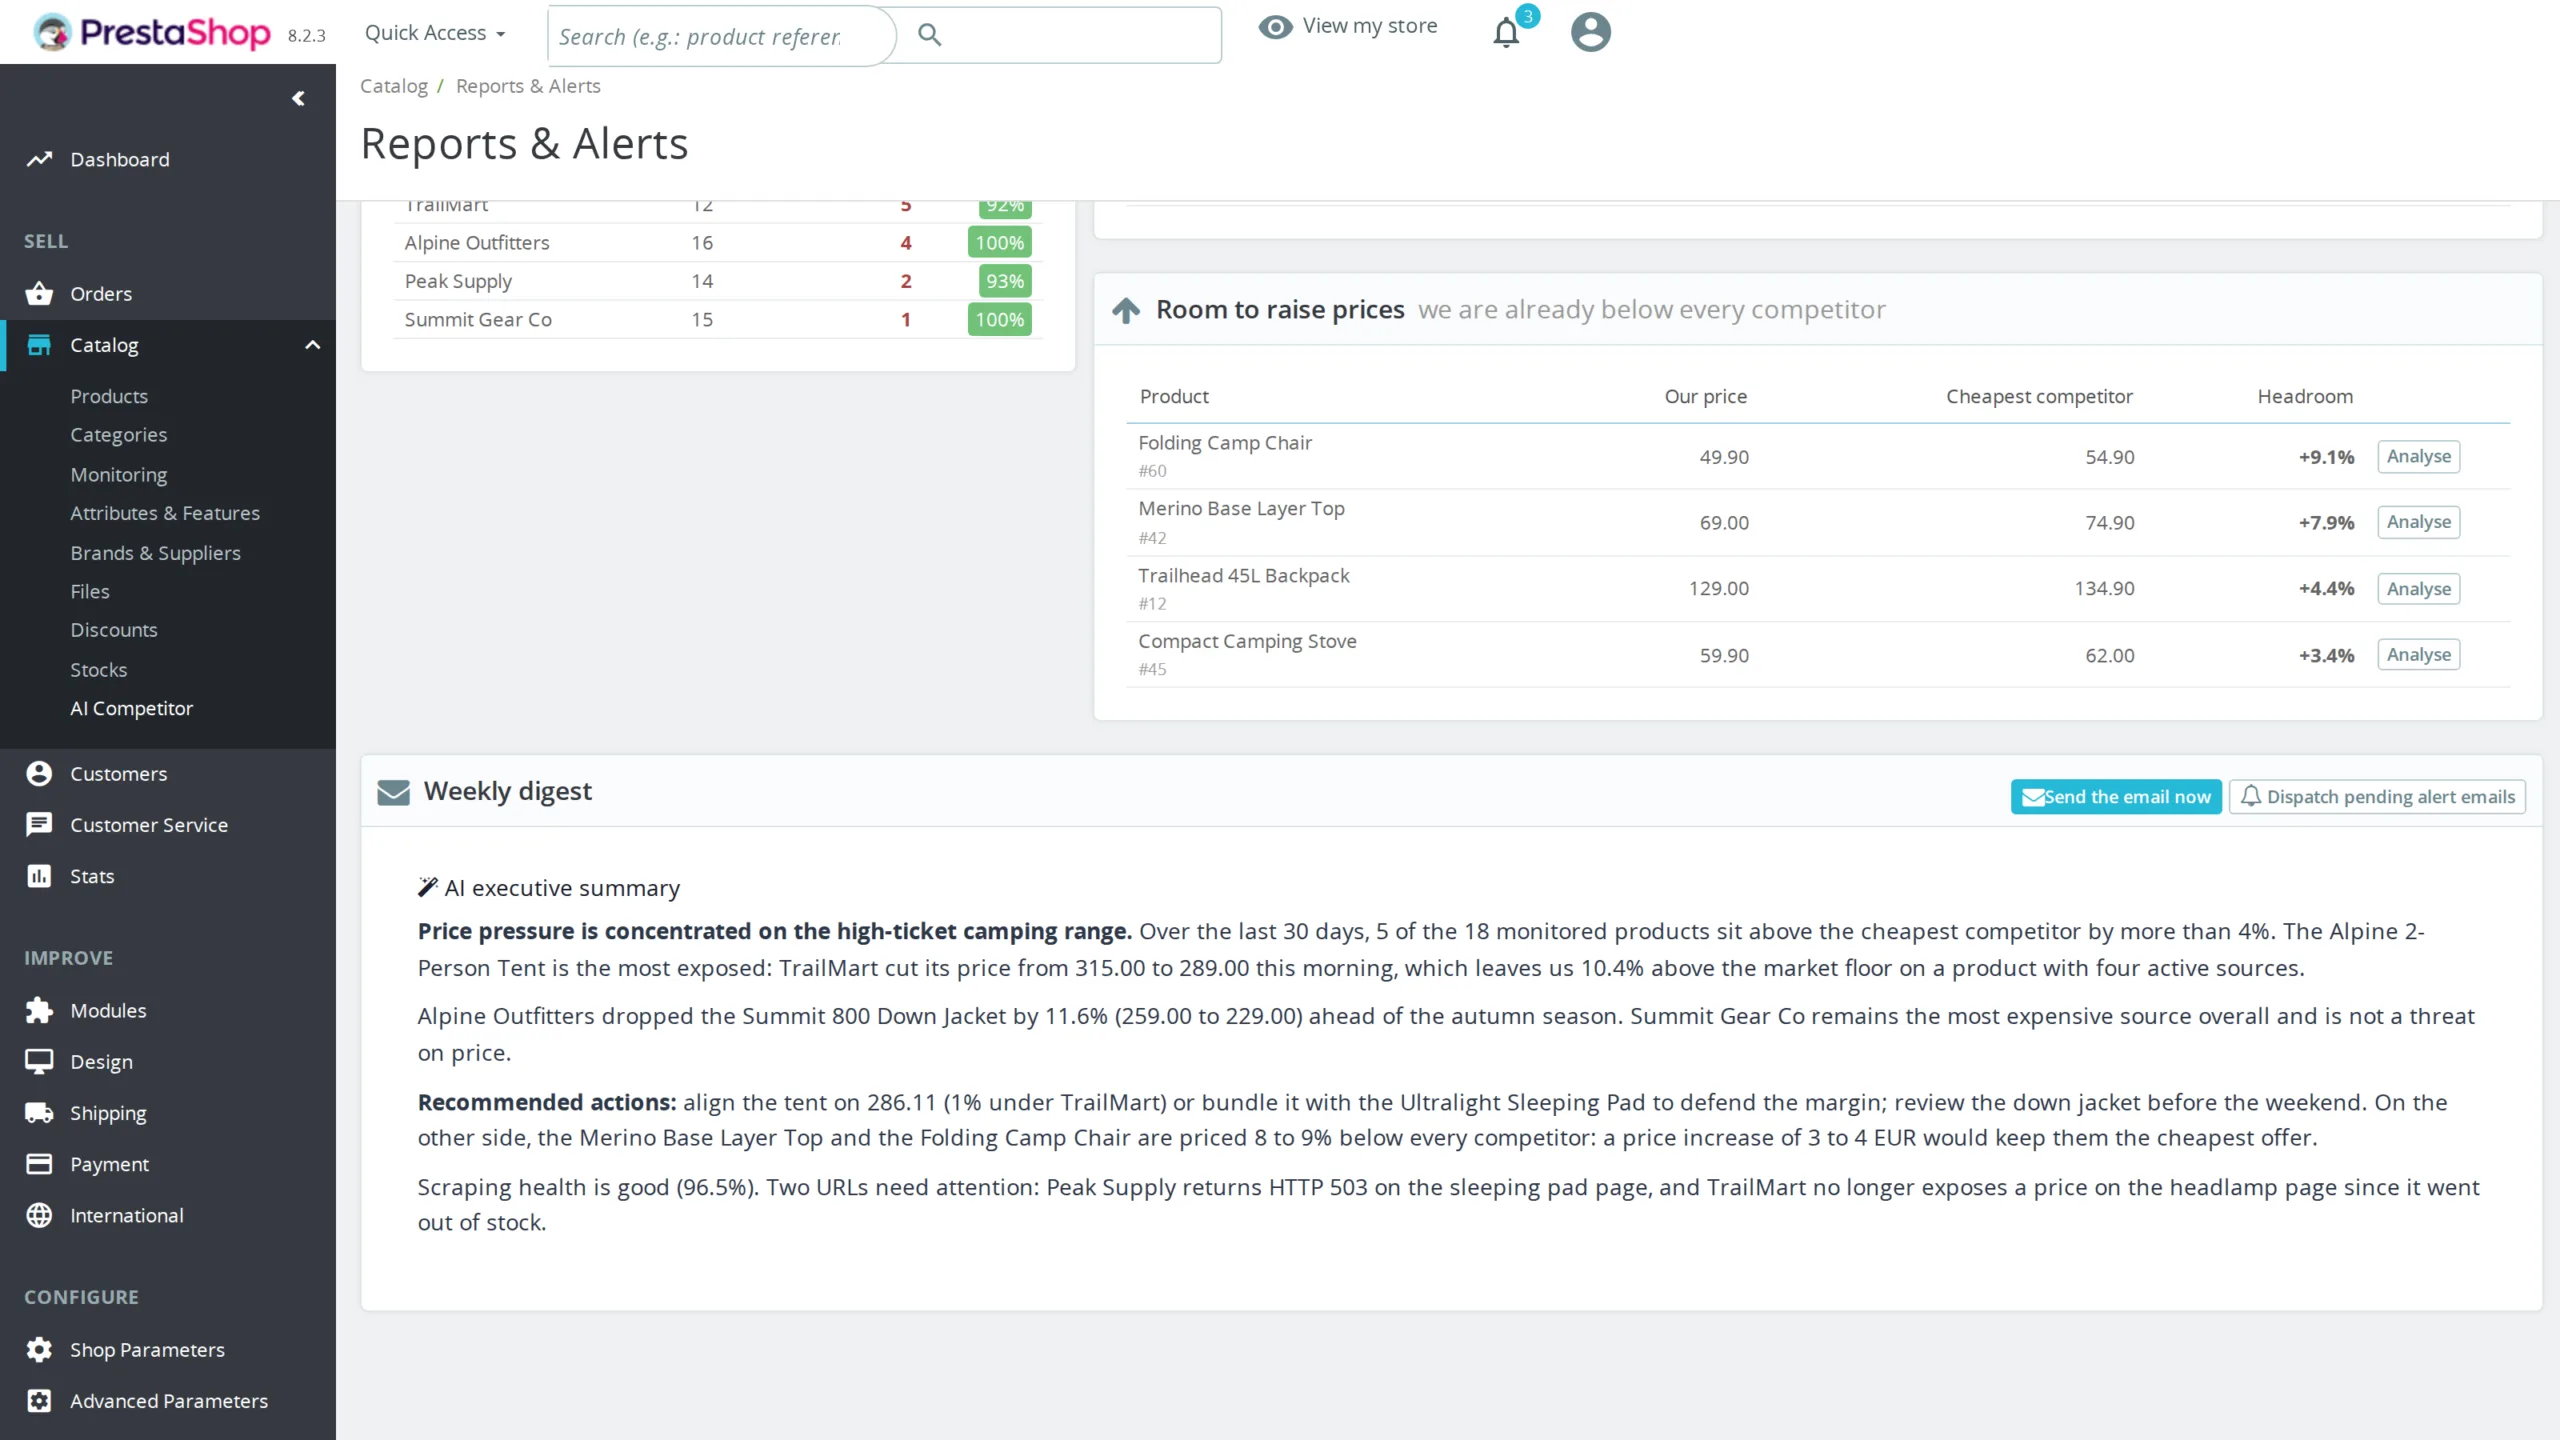
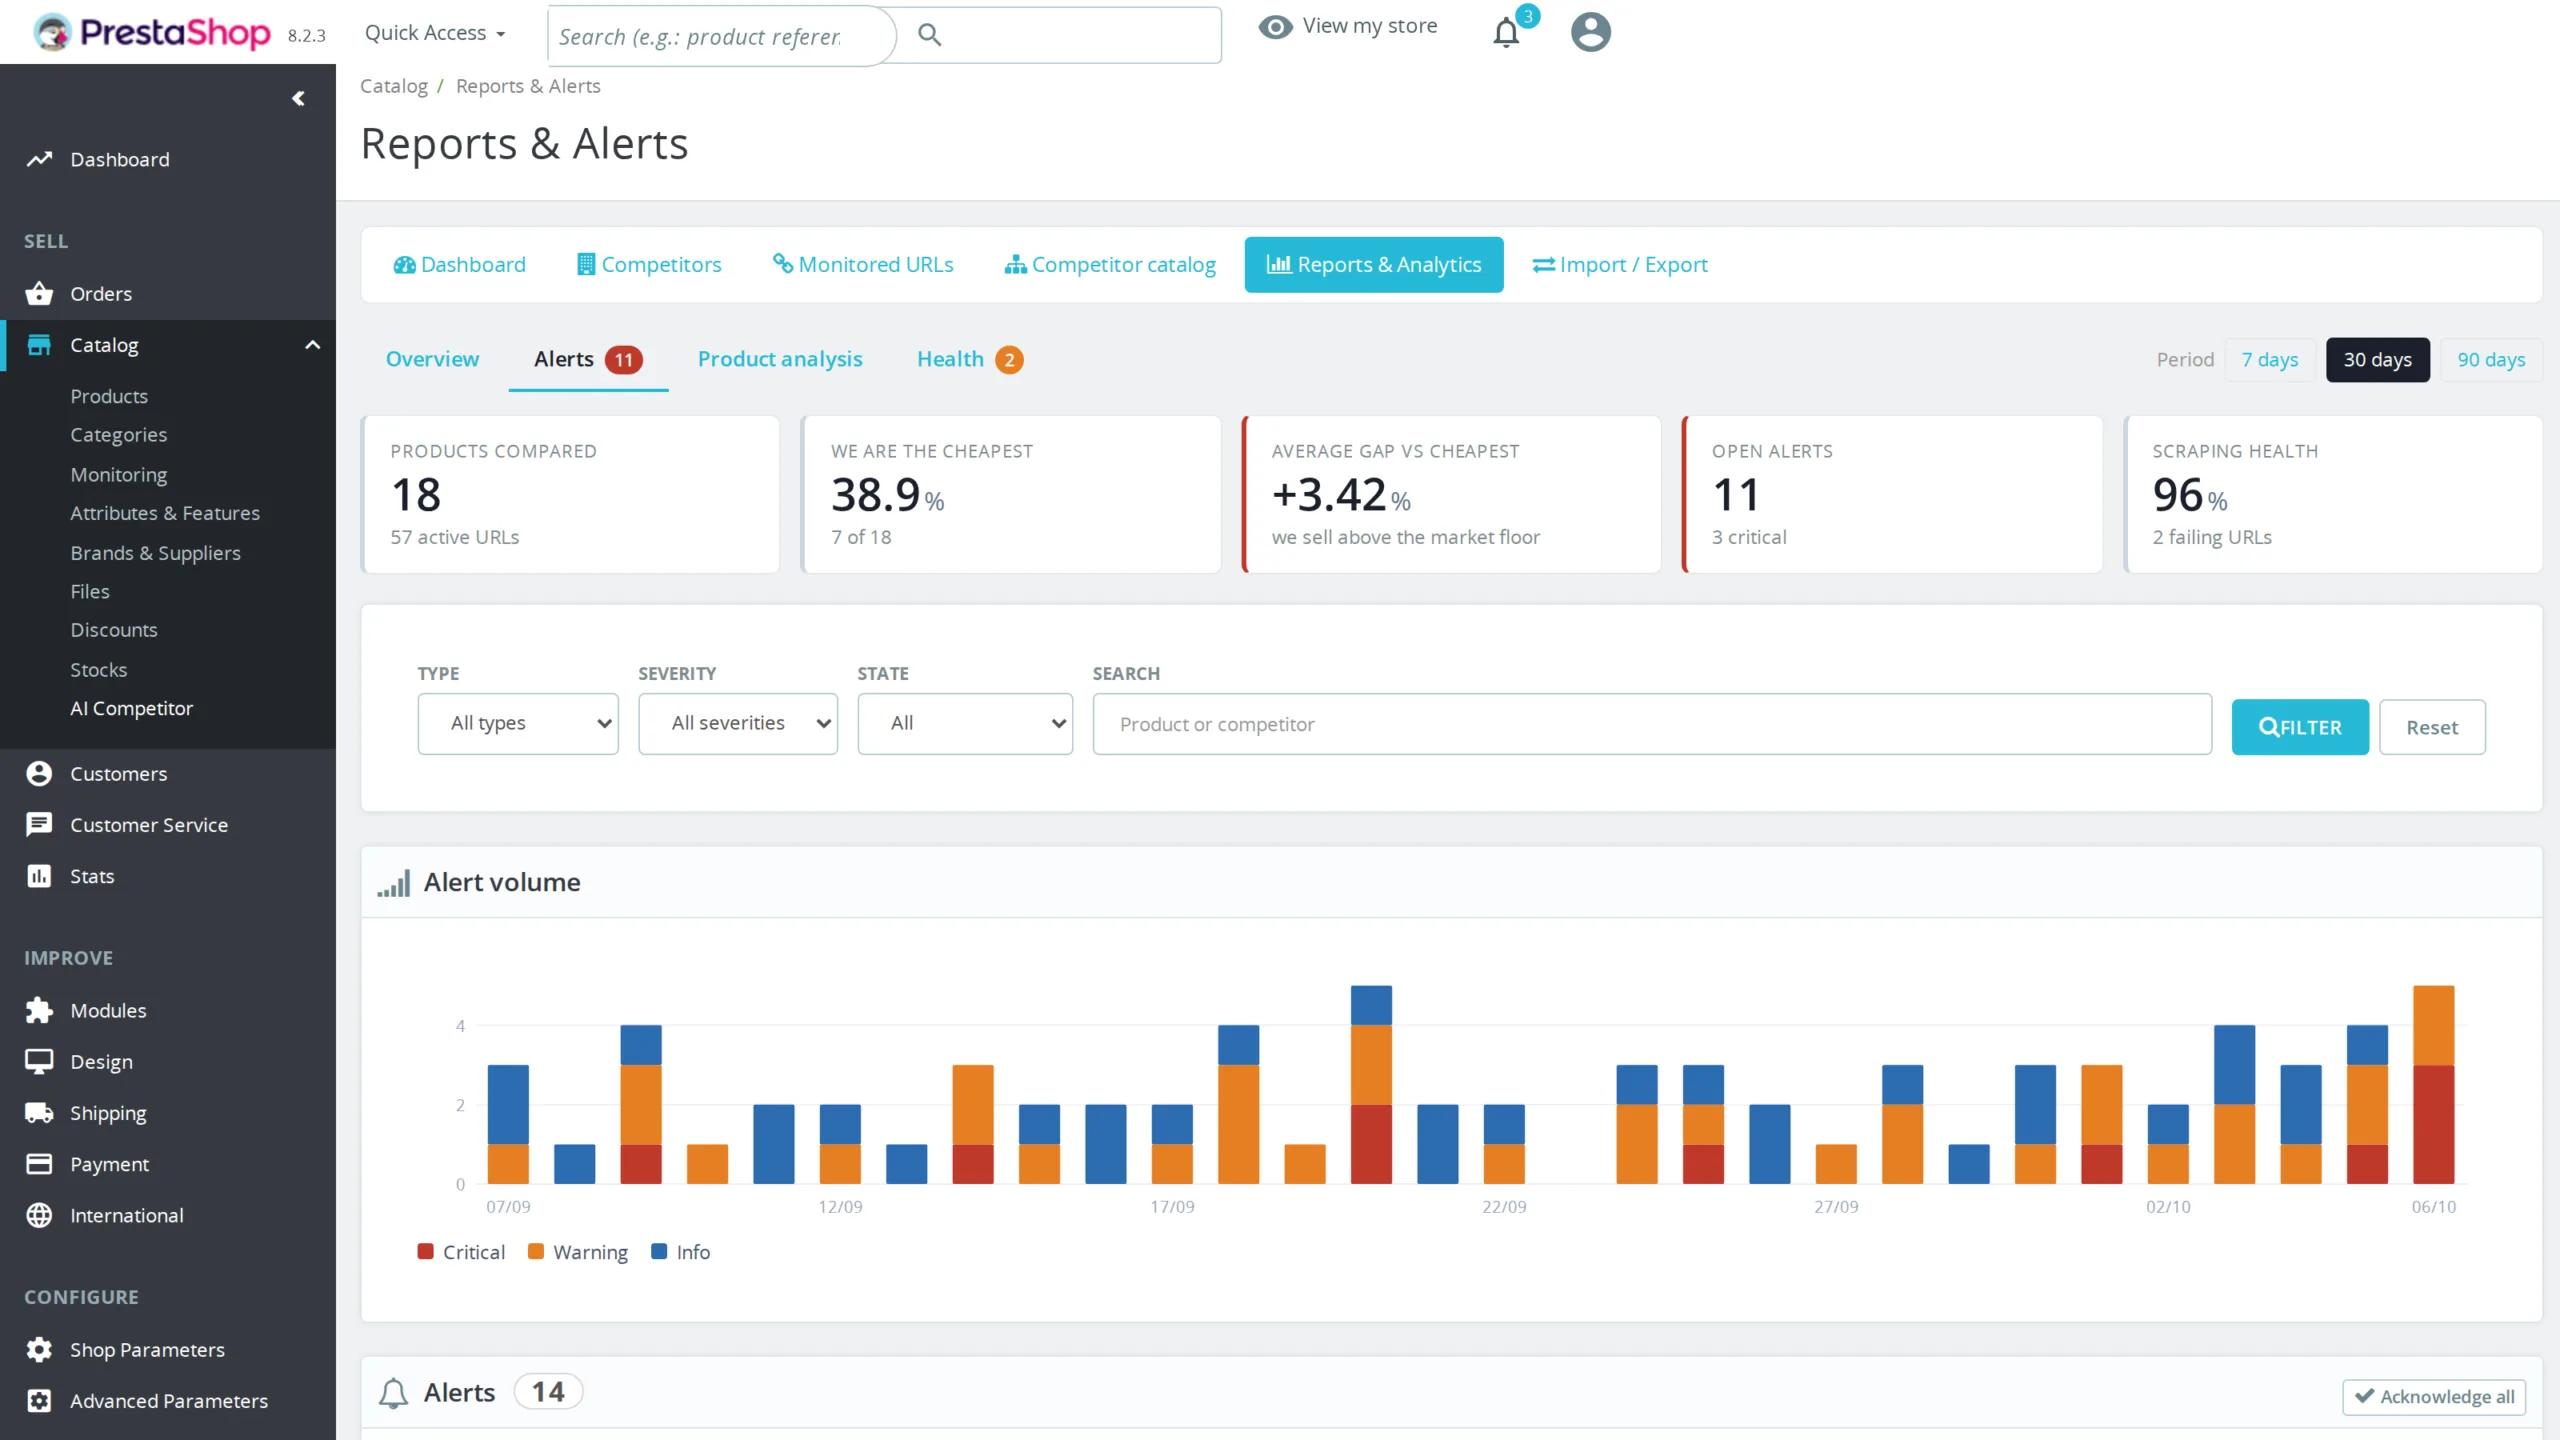
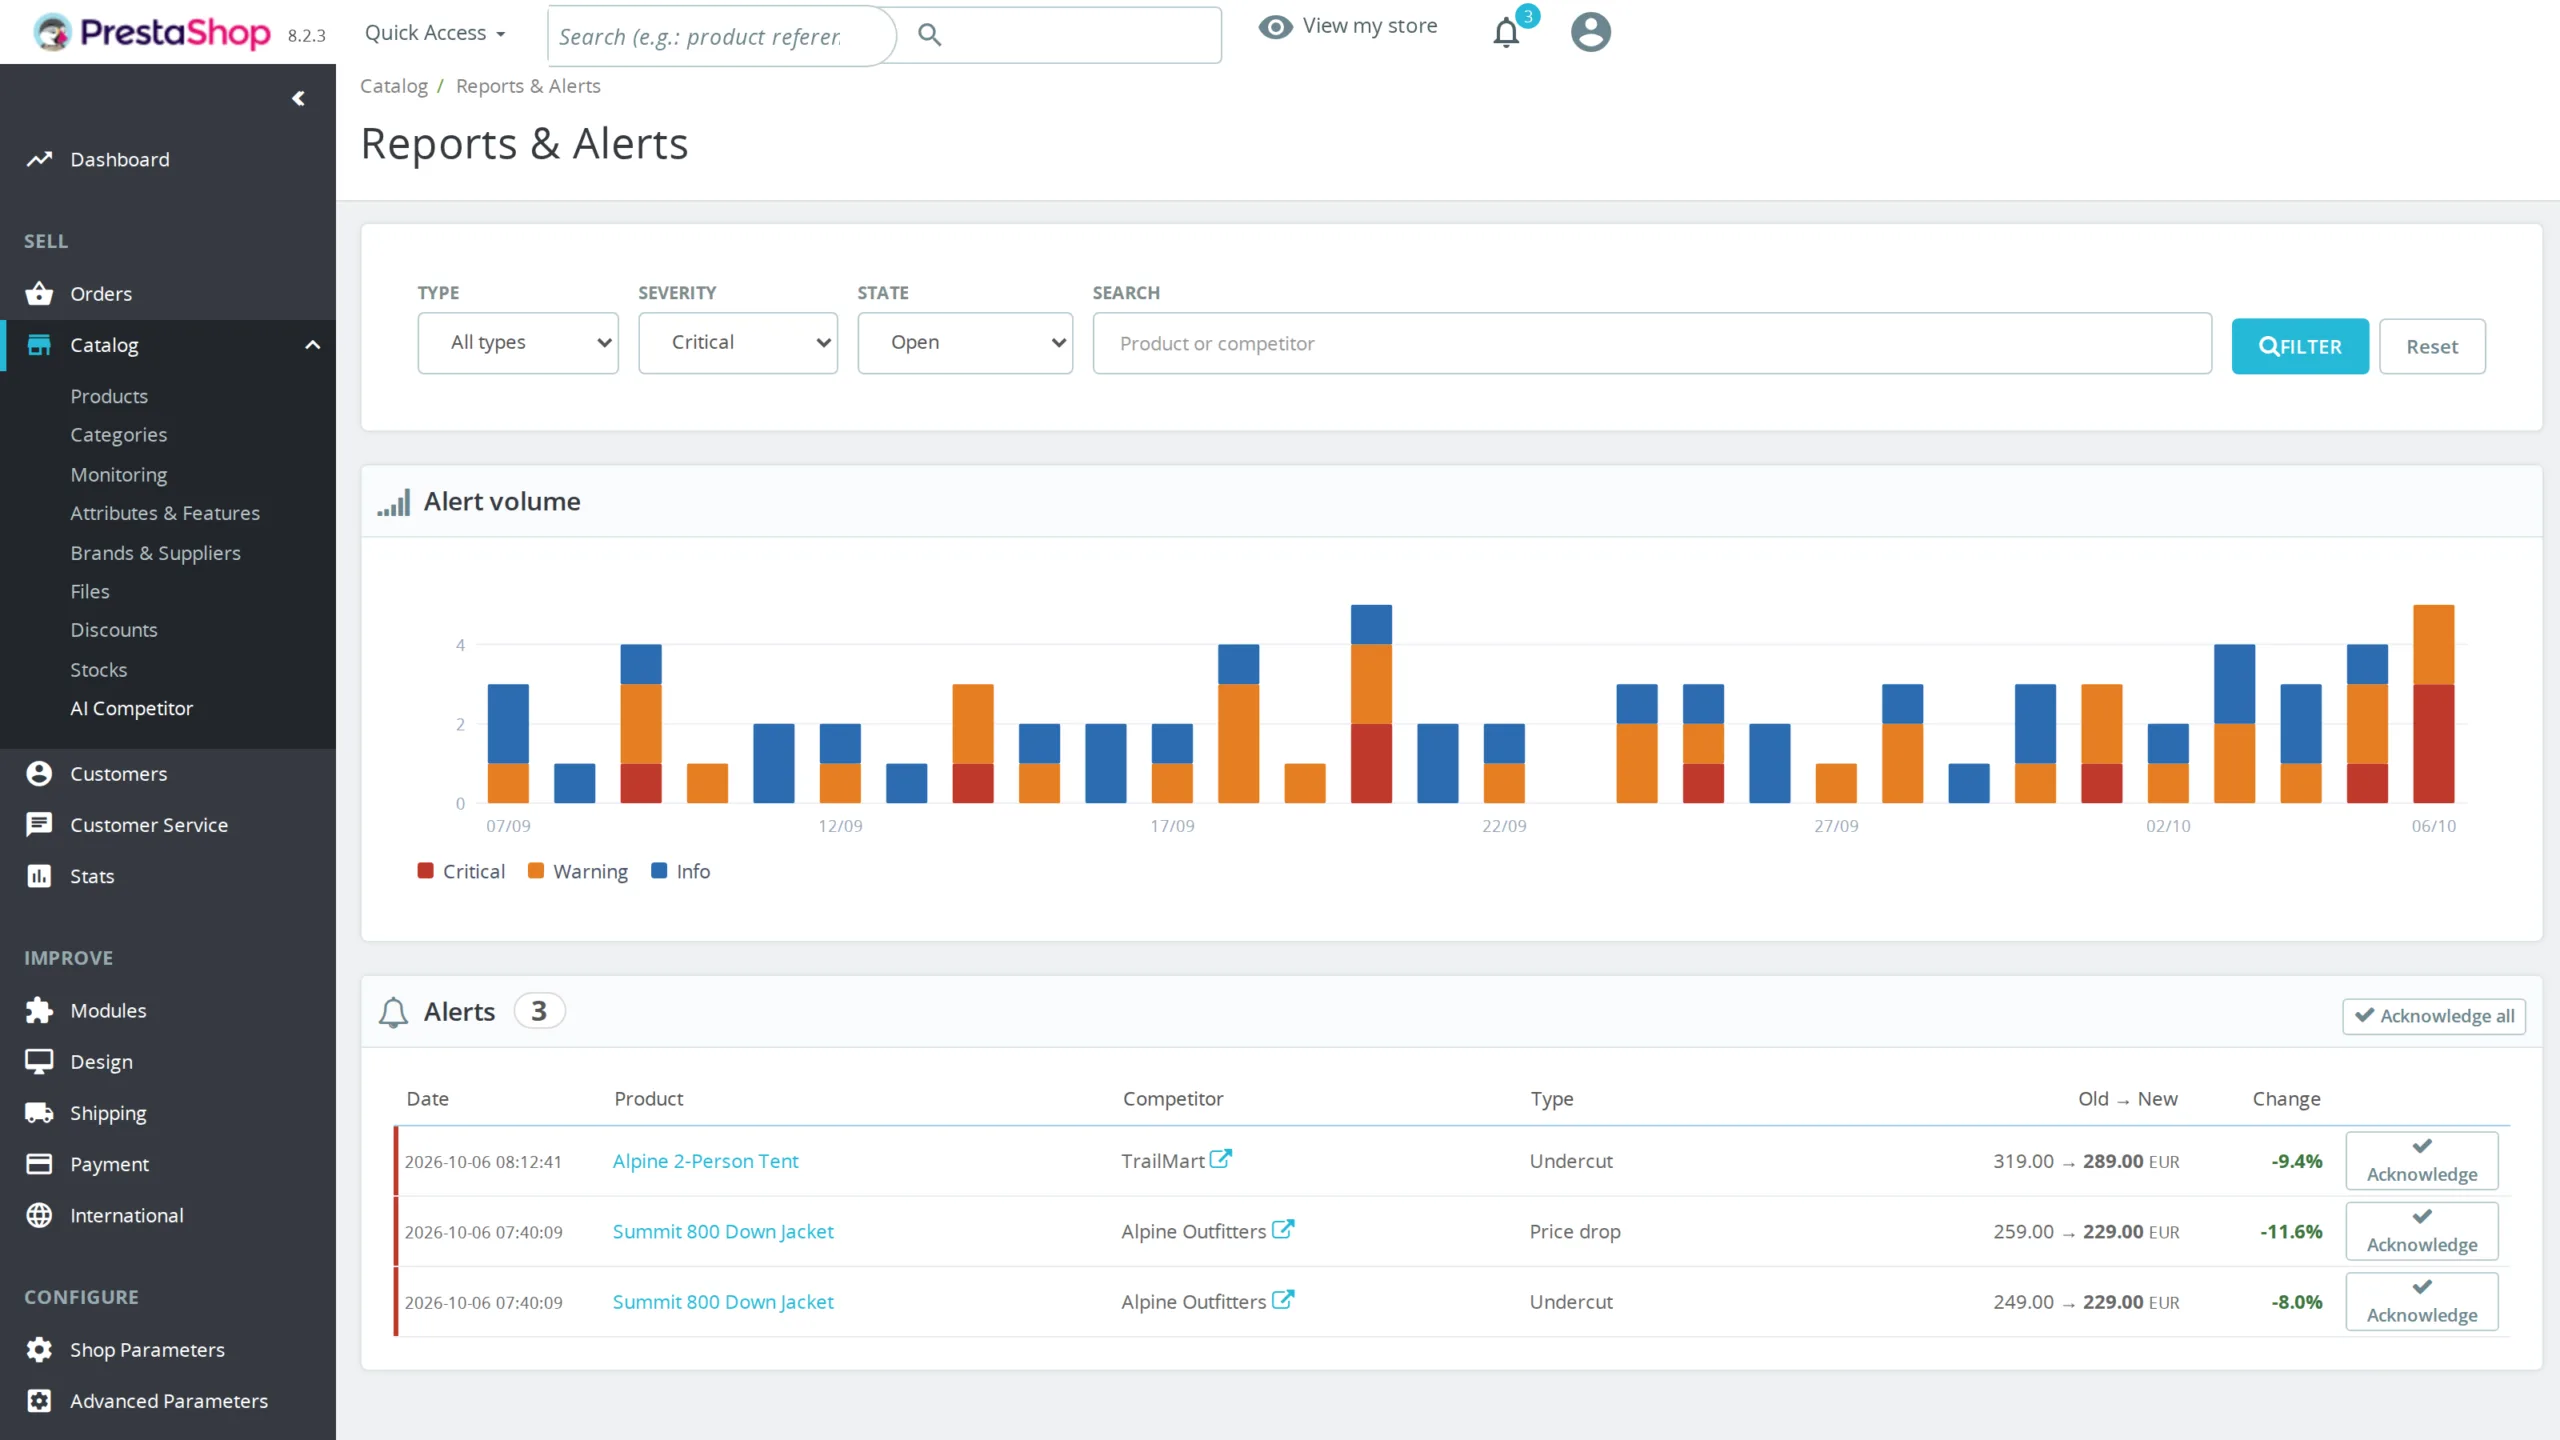
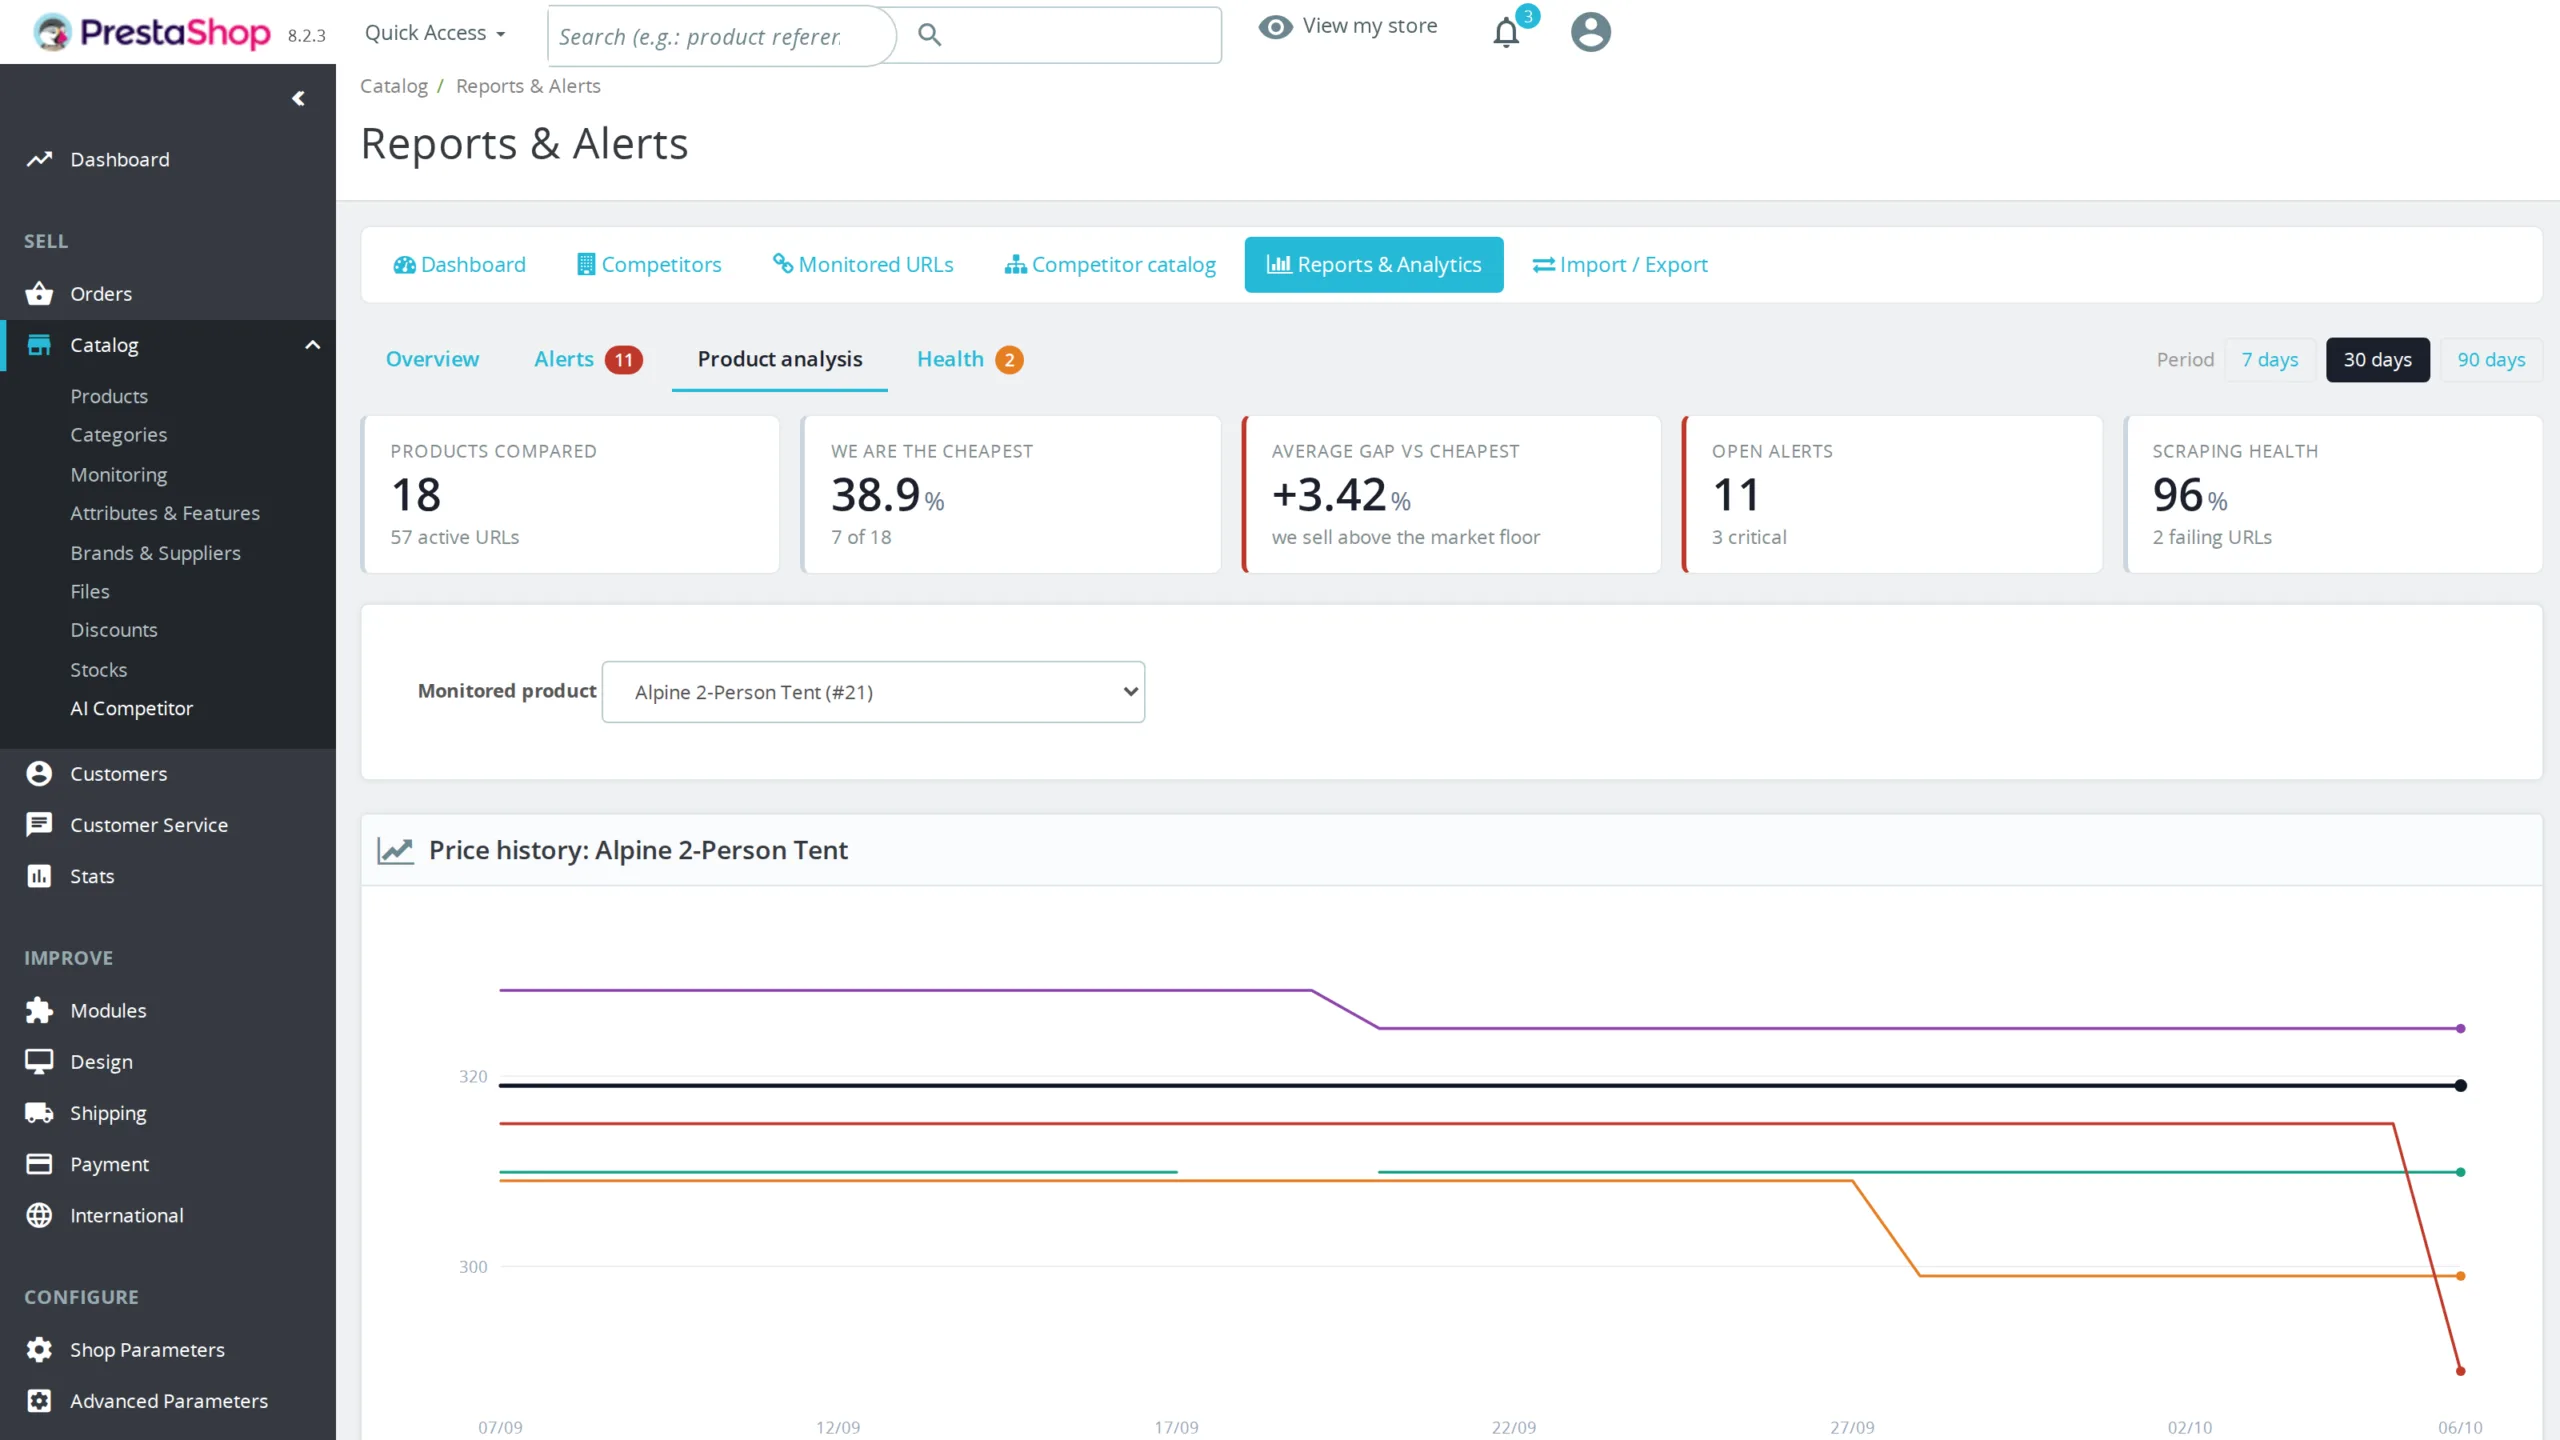
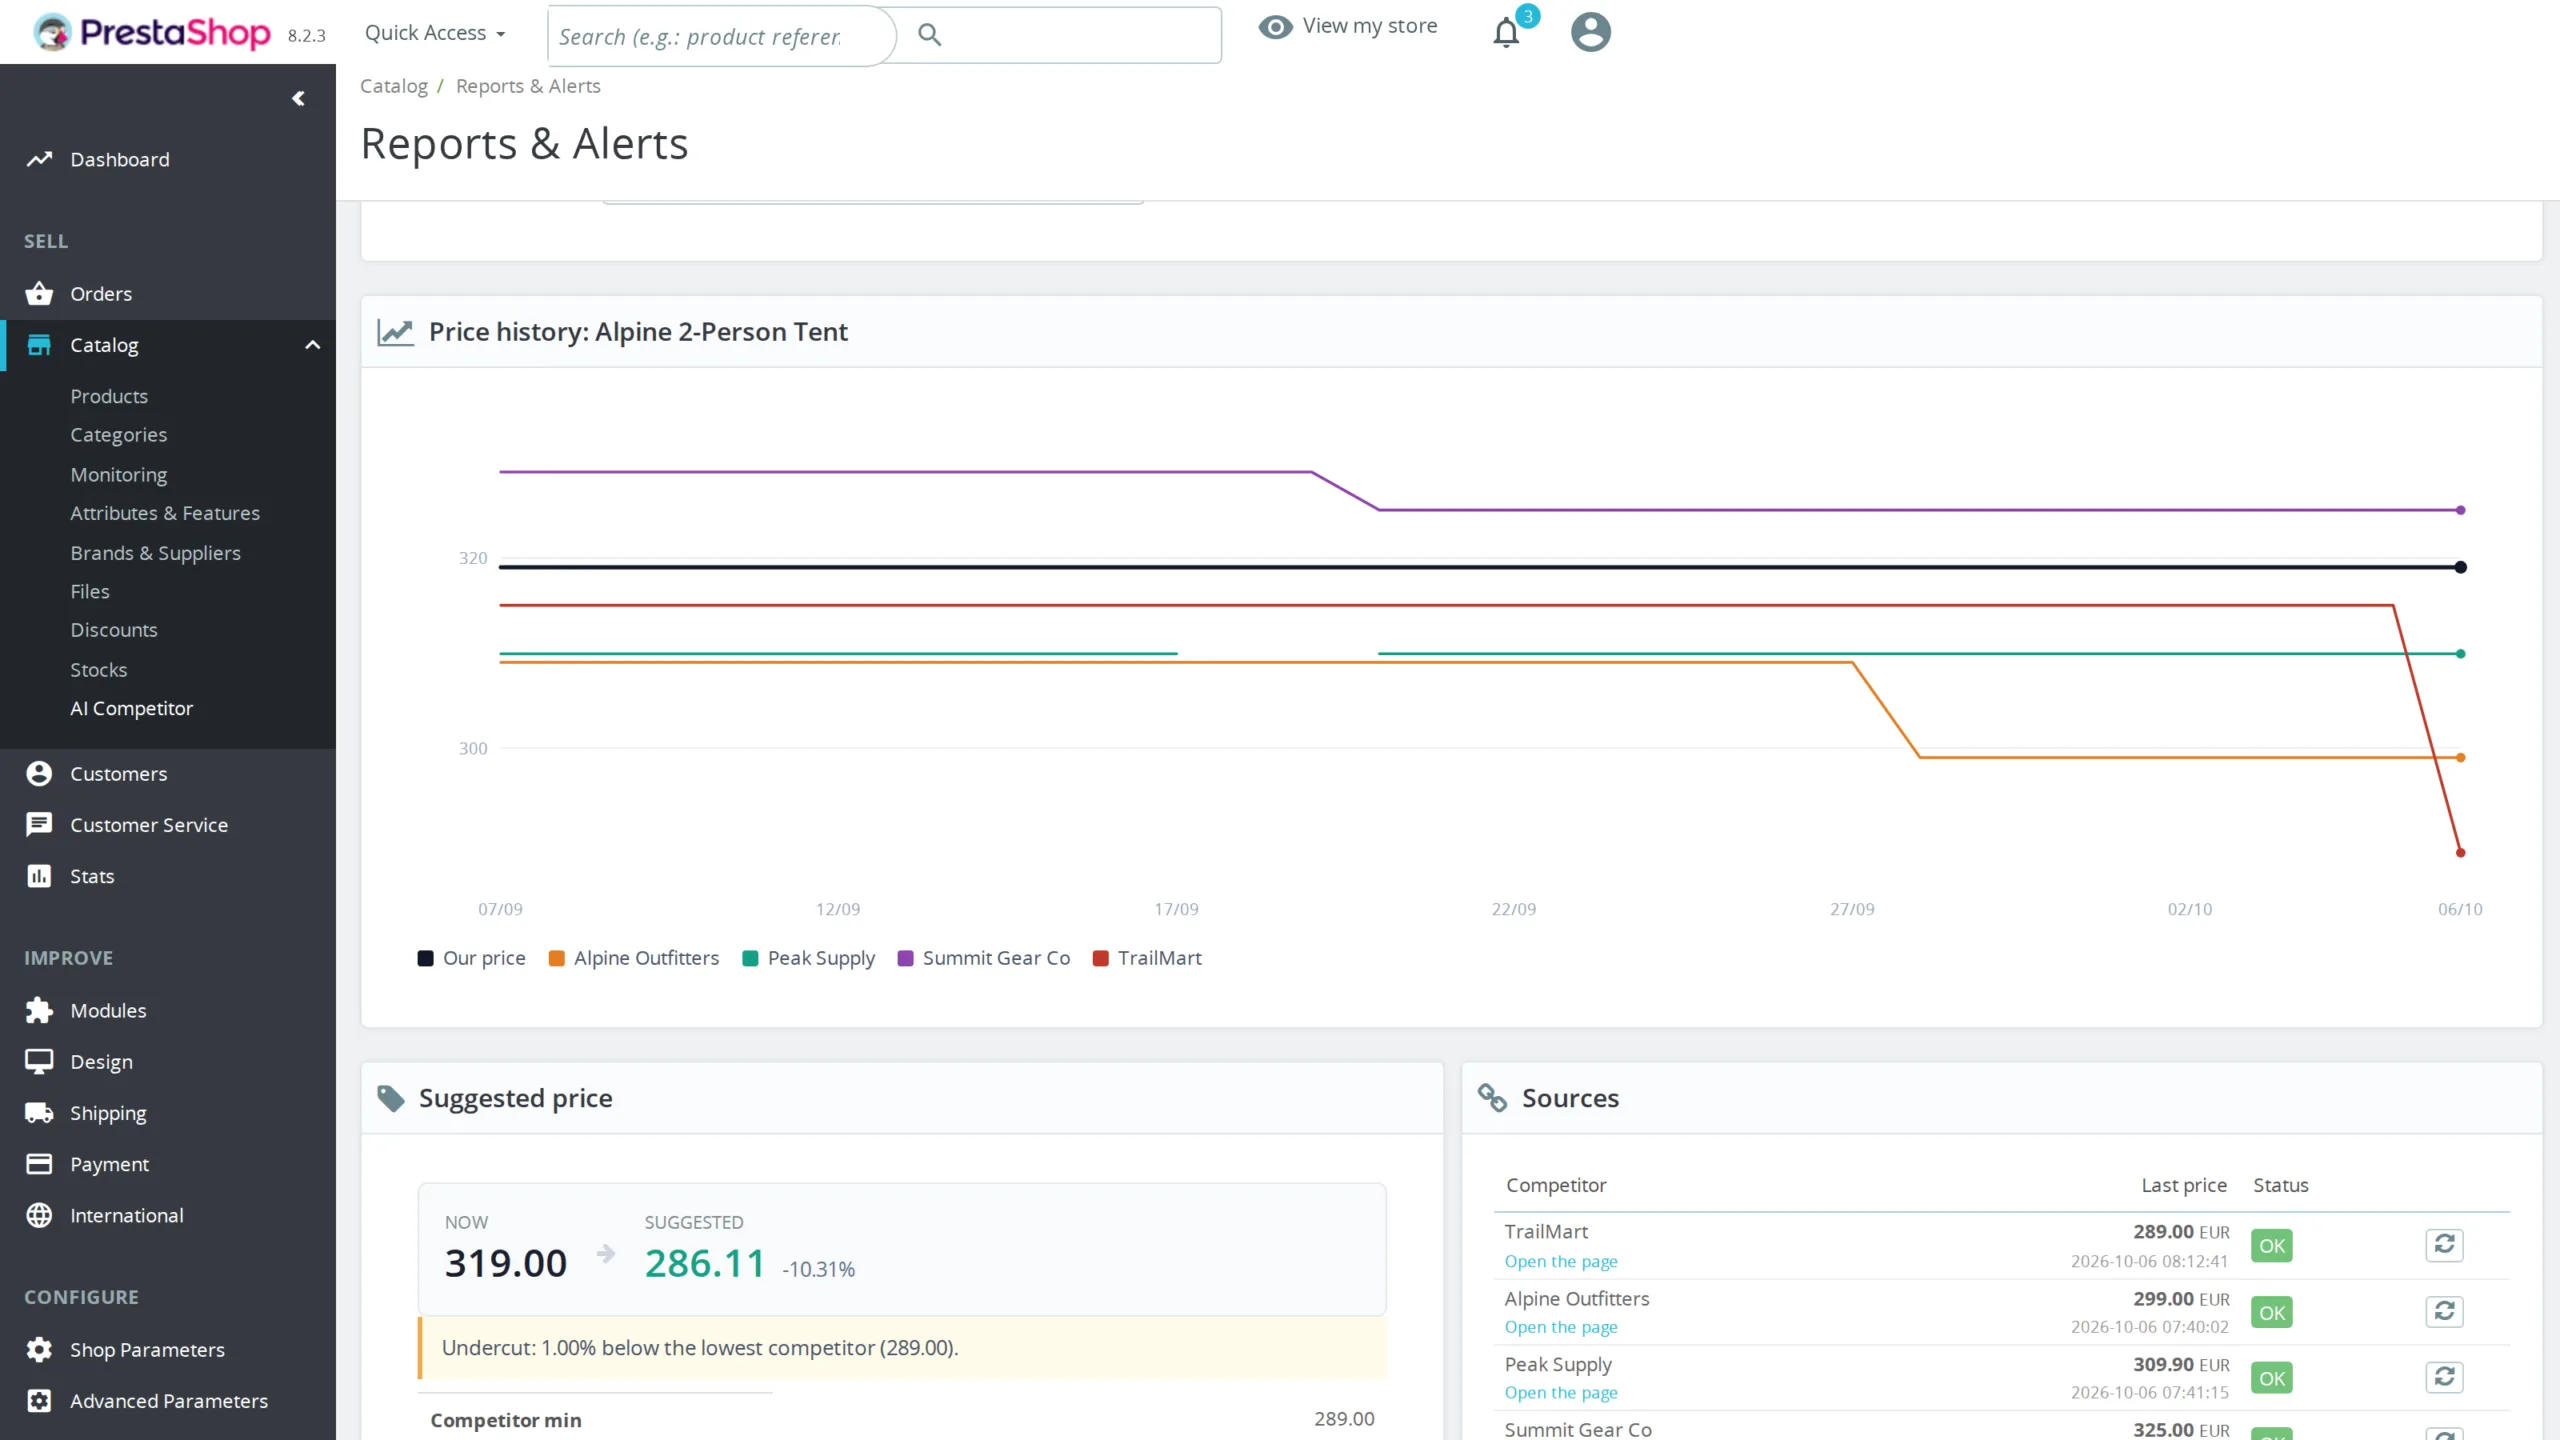
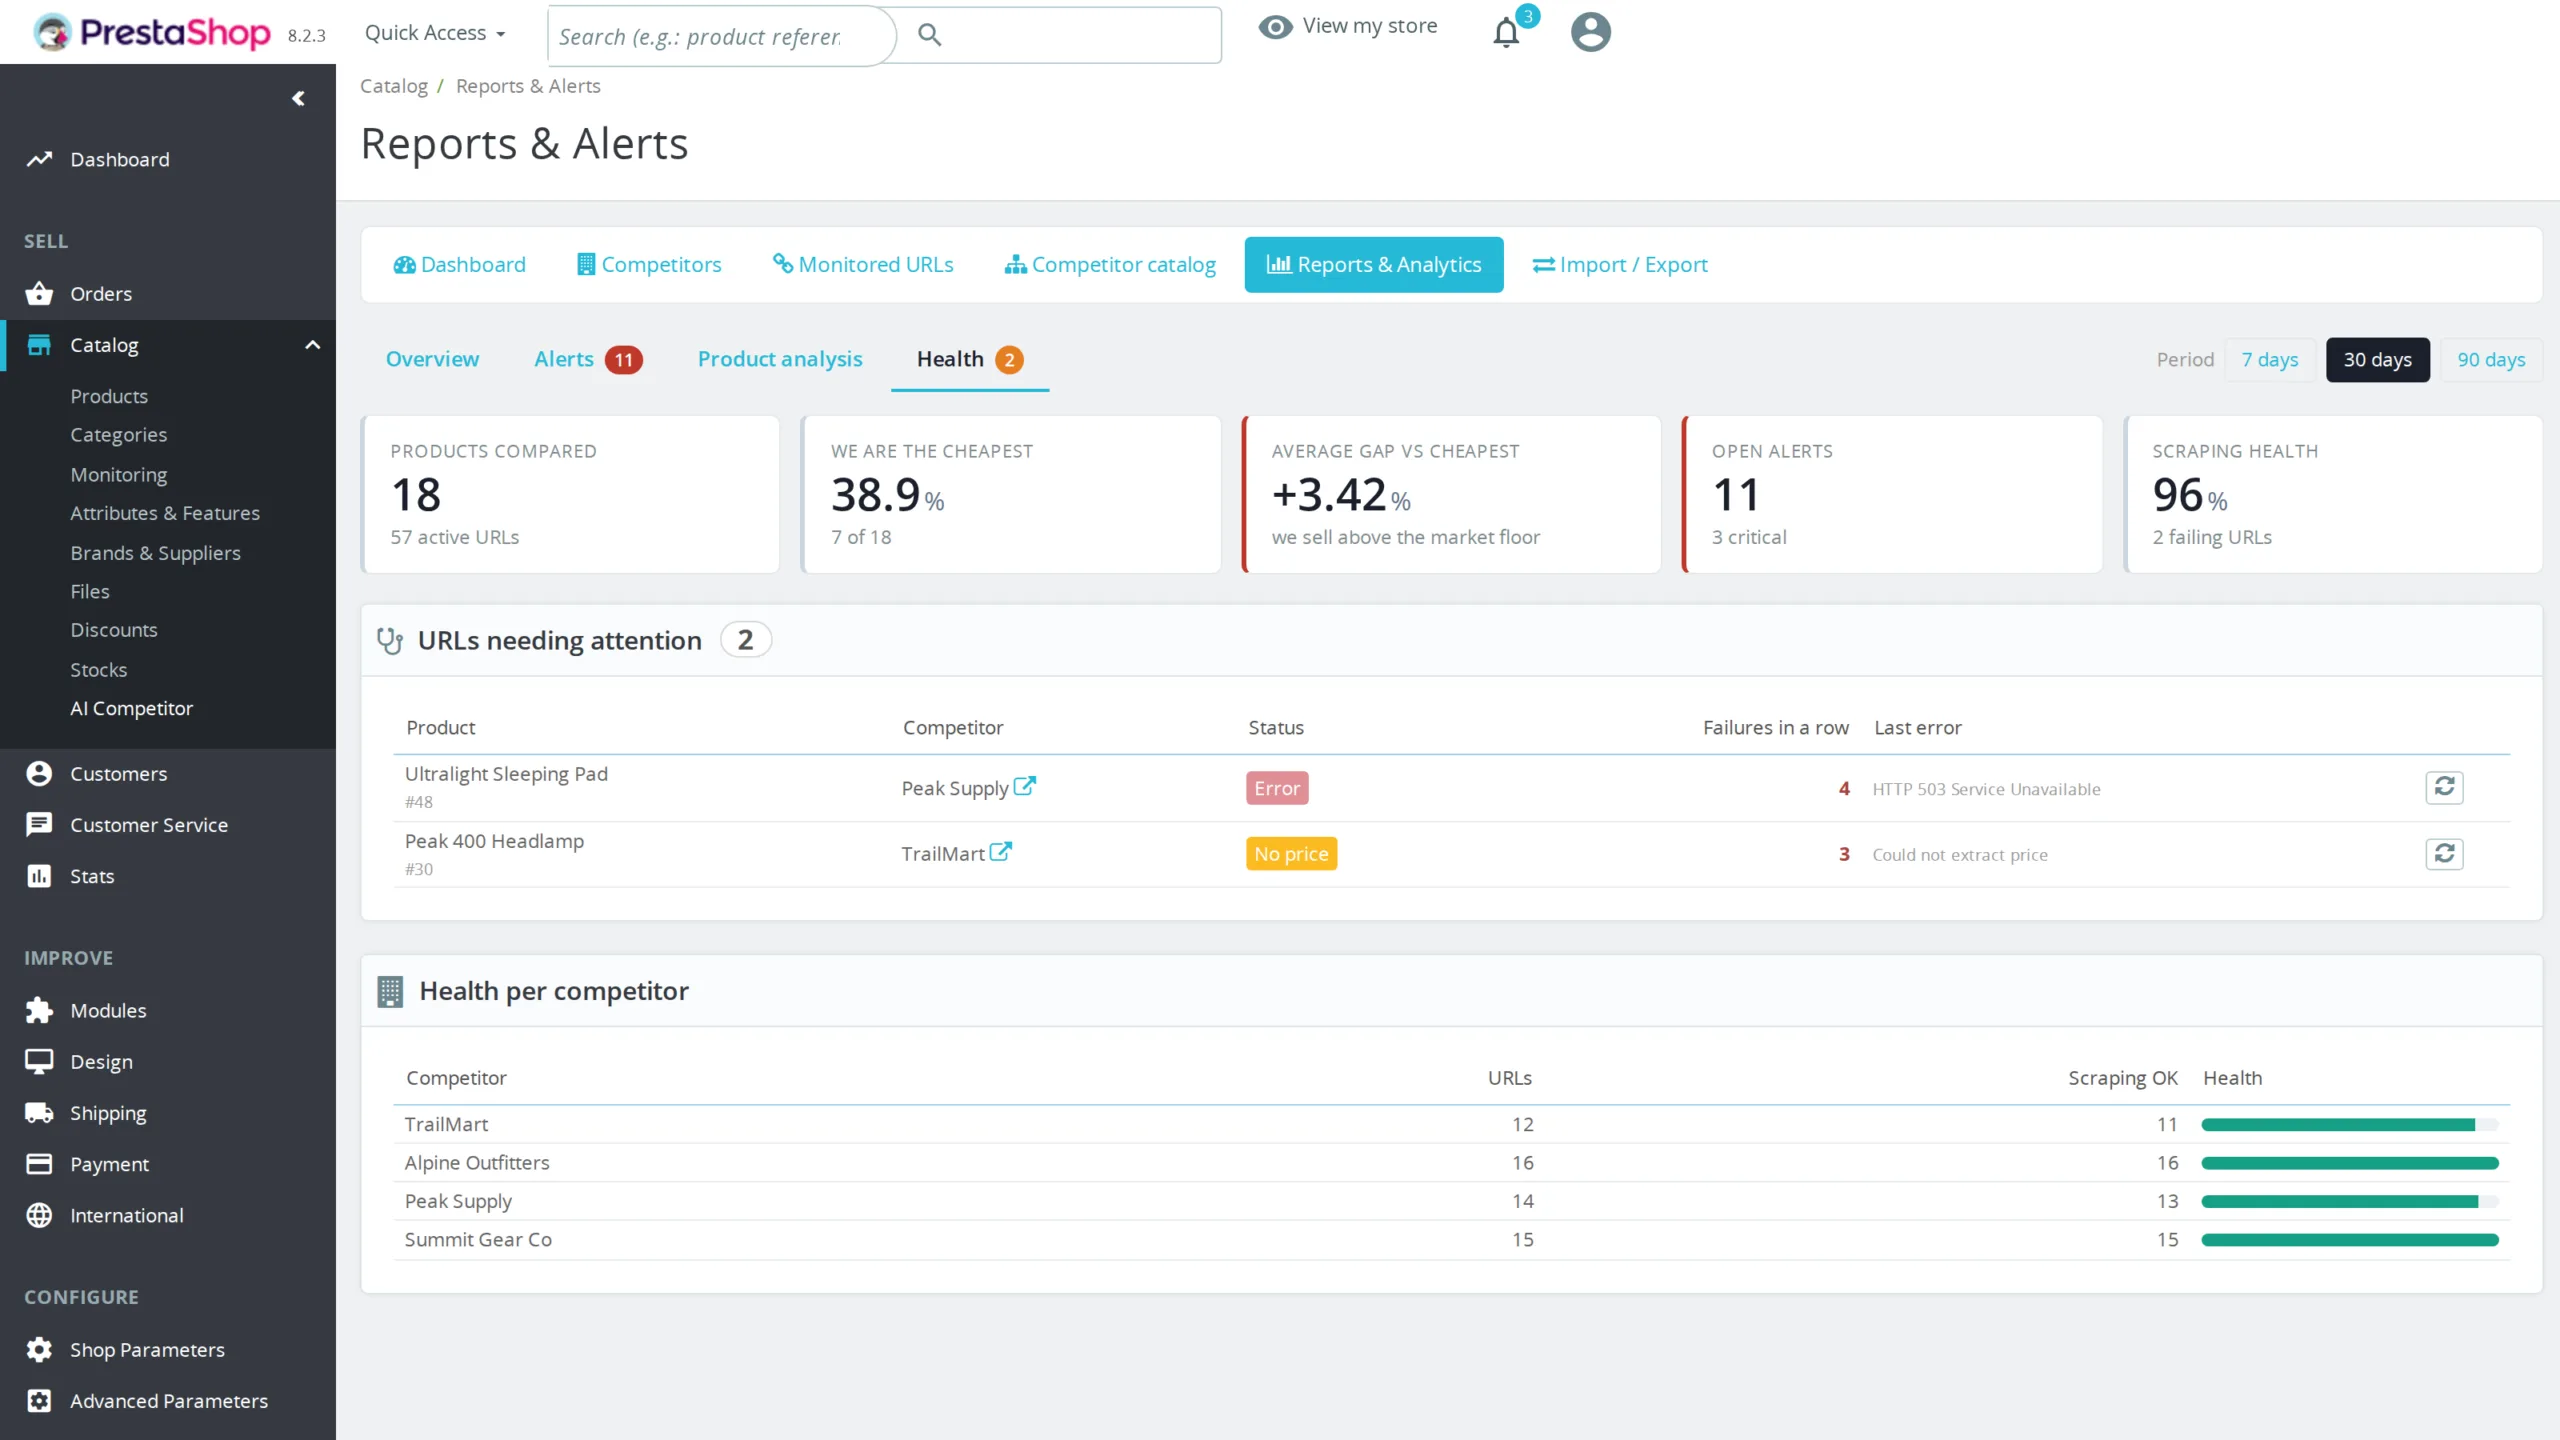
O ecrã de relatórios cabe em quatro separadores atrás de uma faixa de indicadores permanente. A visão geral dá a sua posição no mercado: proporção de produtos em que é o mais barato, proporção em que é o mais caro, diferença média face ao preço mínimo, e a lista de produtos ordenados por diferença, tanto onde perde no preço como onde tem margem para subir. O separador de alertas filtra por tipo, gravidade, estado e texto livre, com confirmação sem recarregar a página. O separador de análise de produto traça o seu preço face ao de cada concorrente no período escolhido. O separador de saúde lista os URLs que falham, com o seu último erro e um botão para repetir. Cada leitura conserva ainda o seu próprio preço do momento, o que torna reconstituível o histórico das diferenças.
Alertas úteis, nunca ruidosos
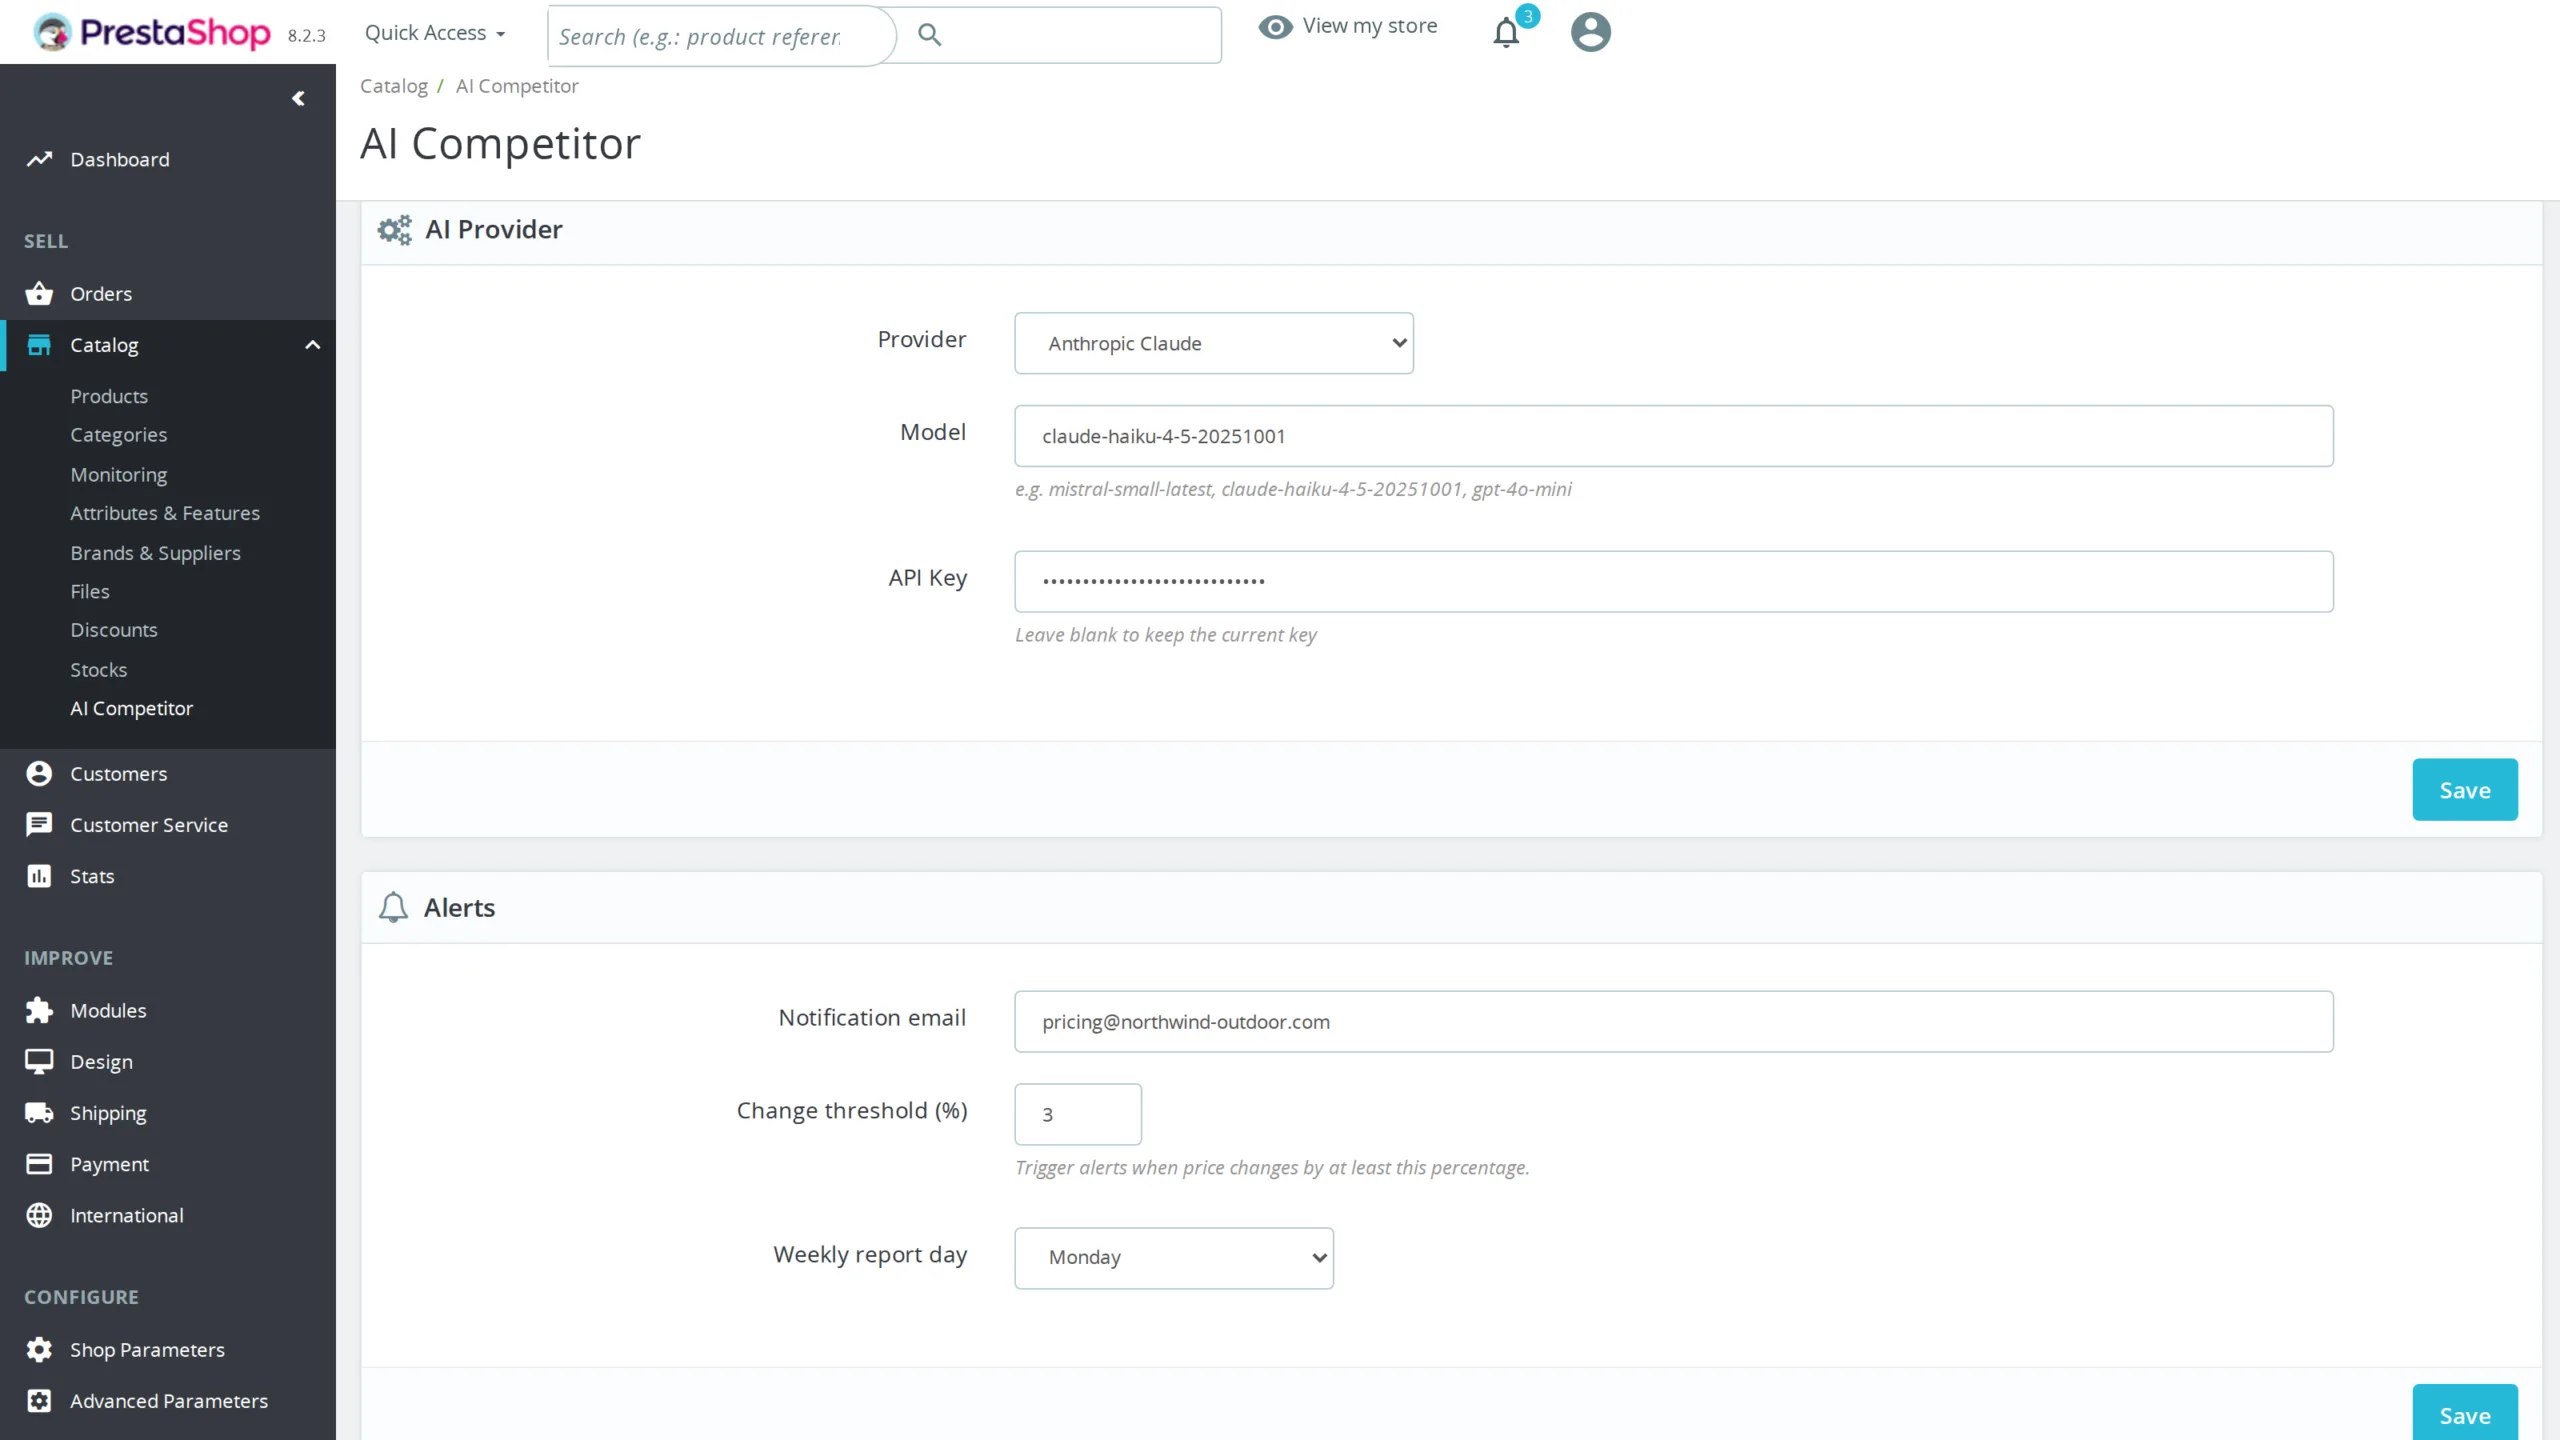
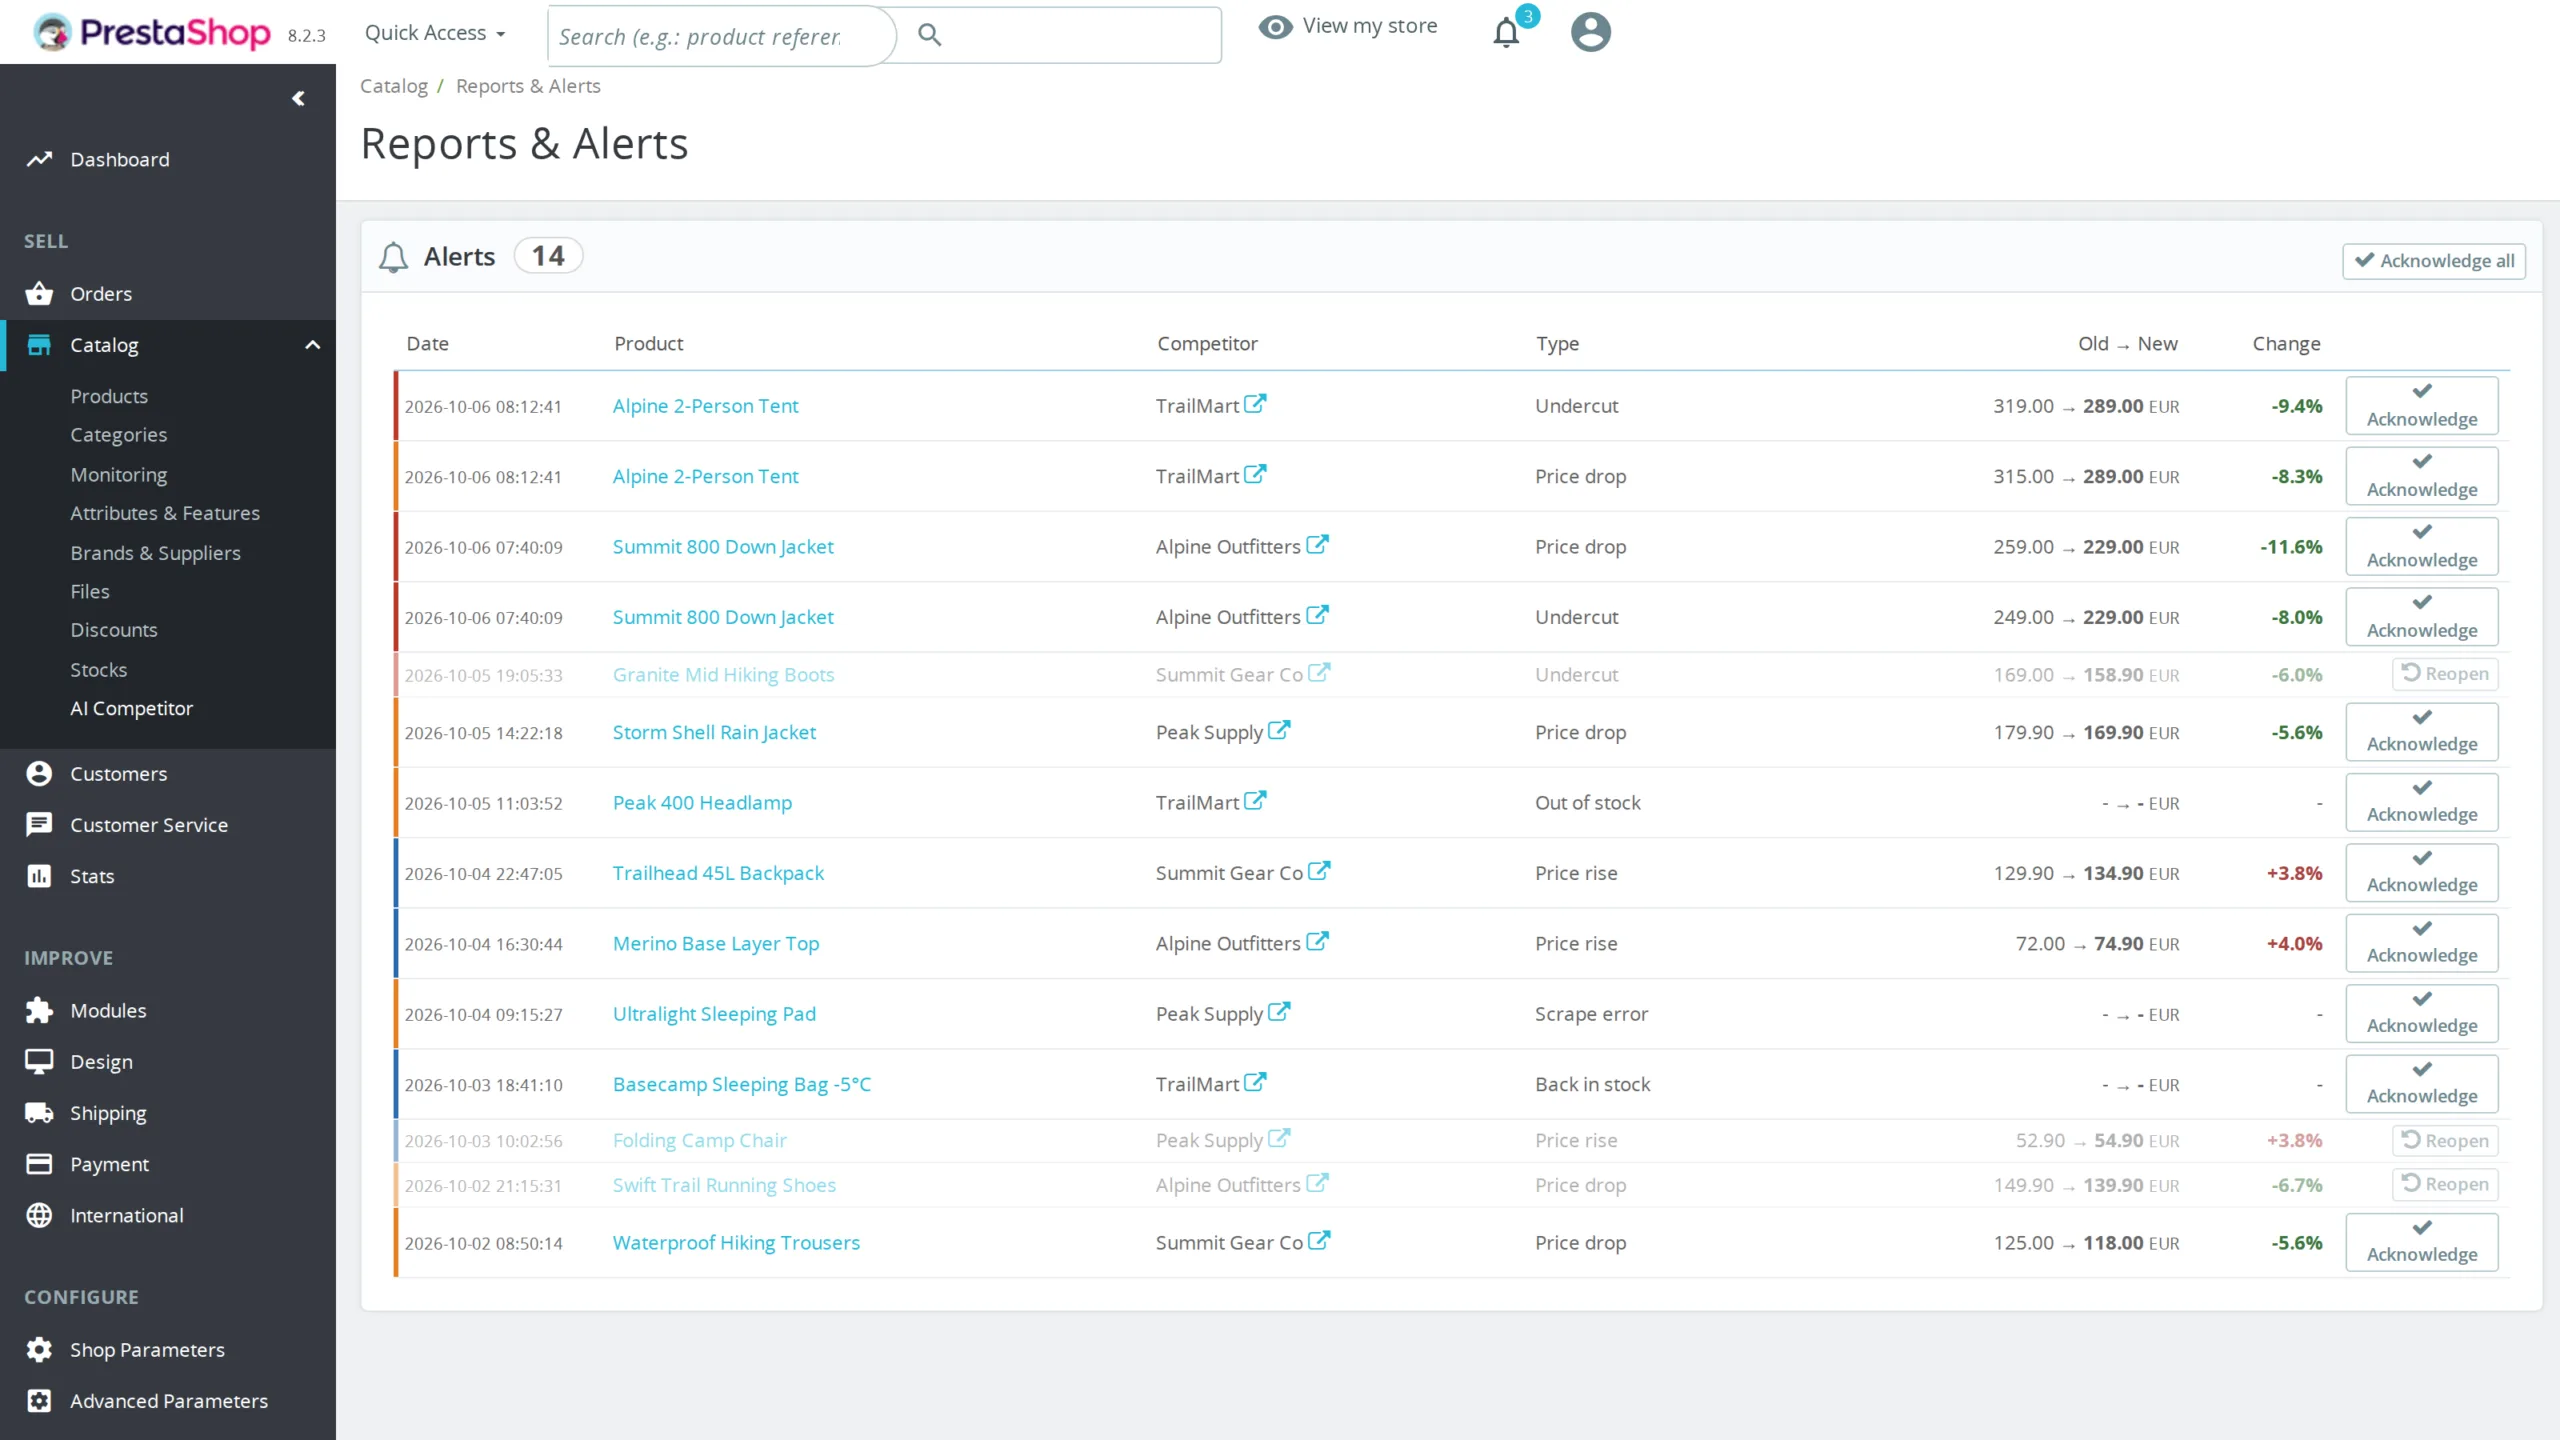
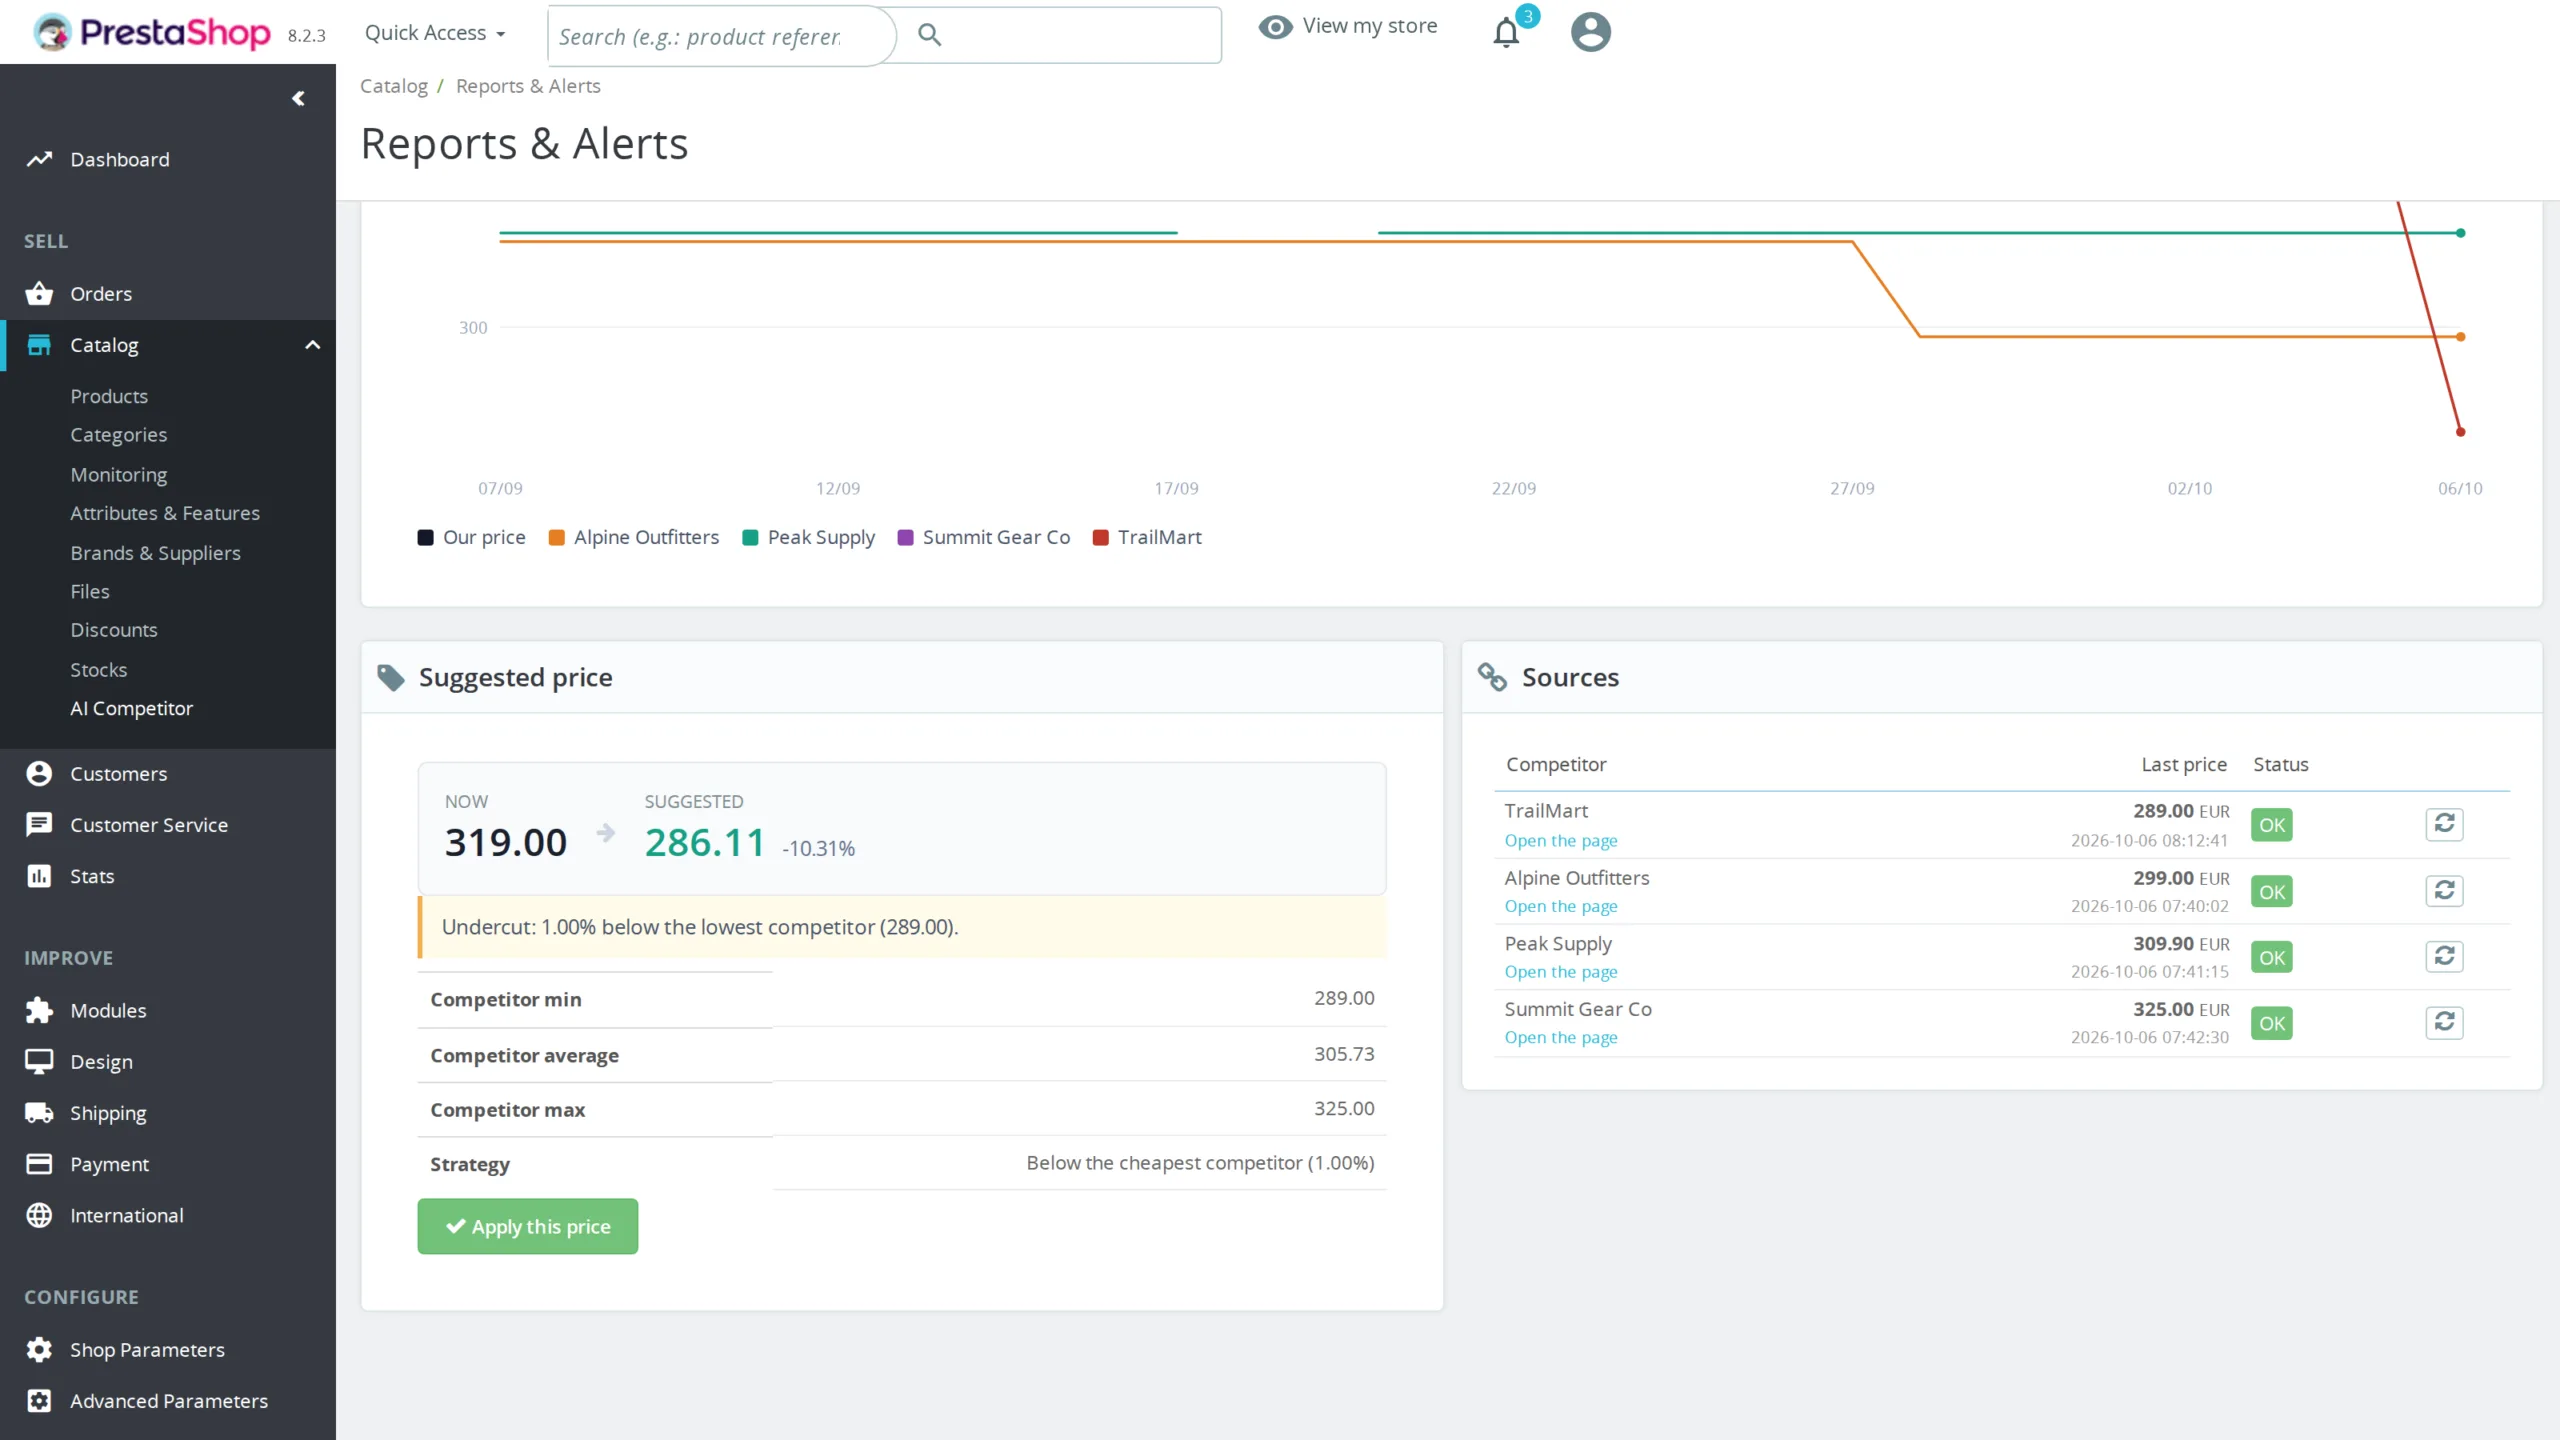
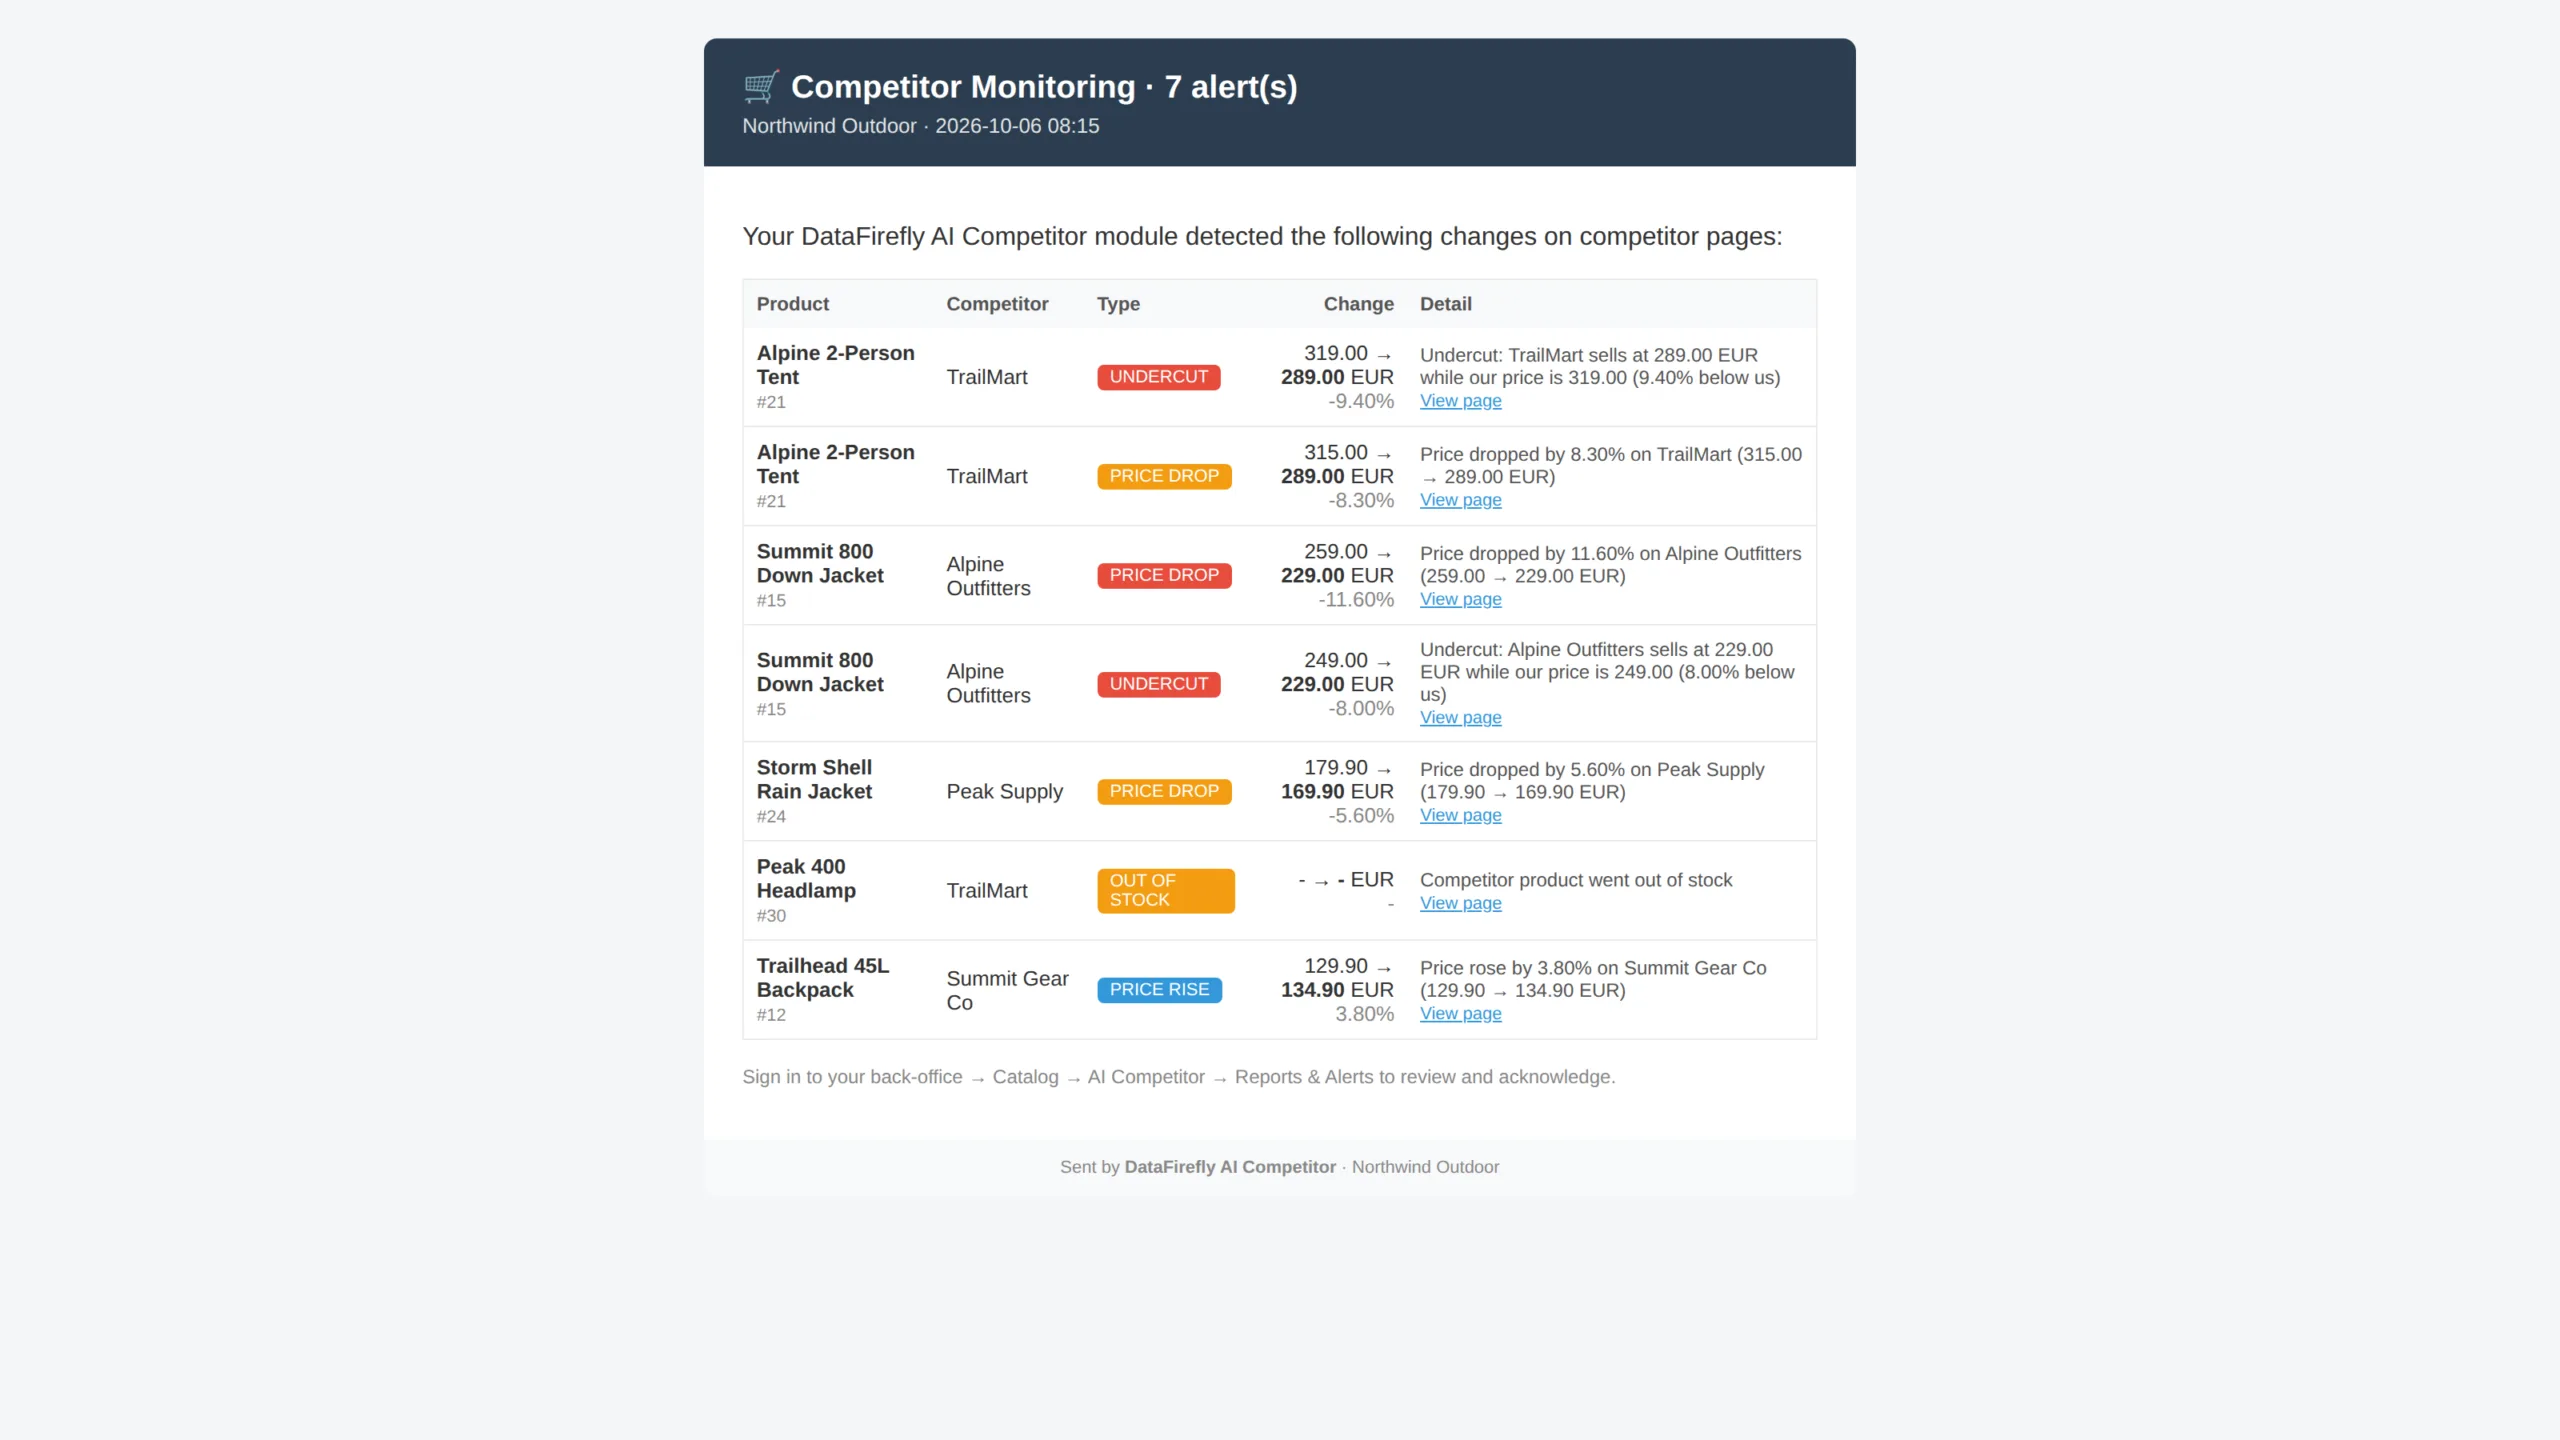
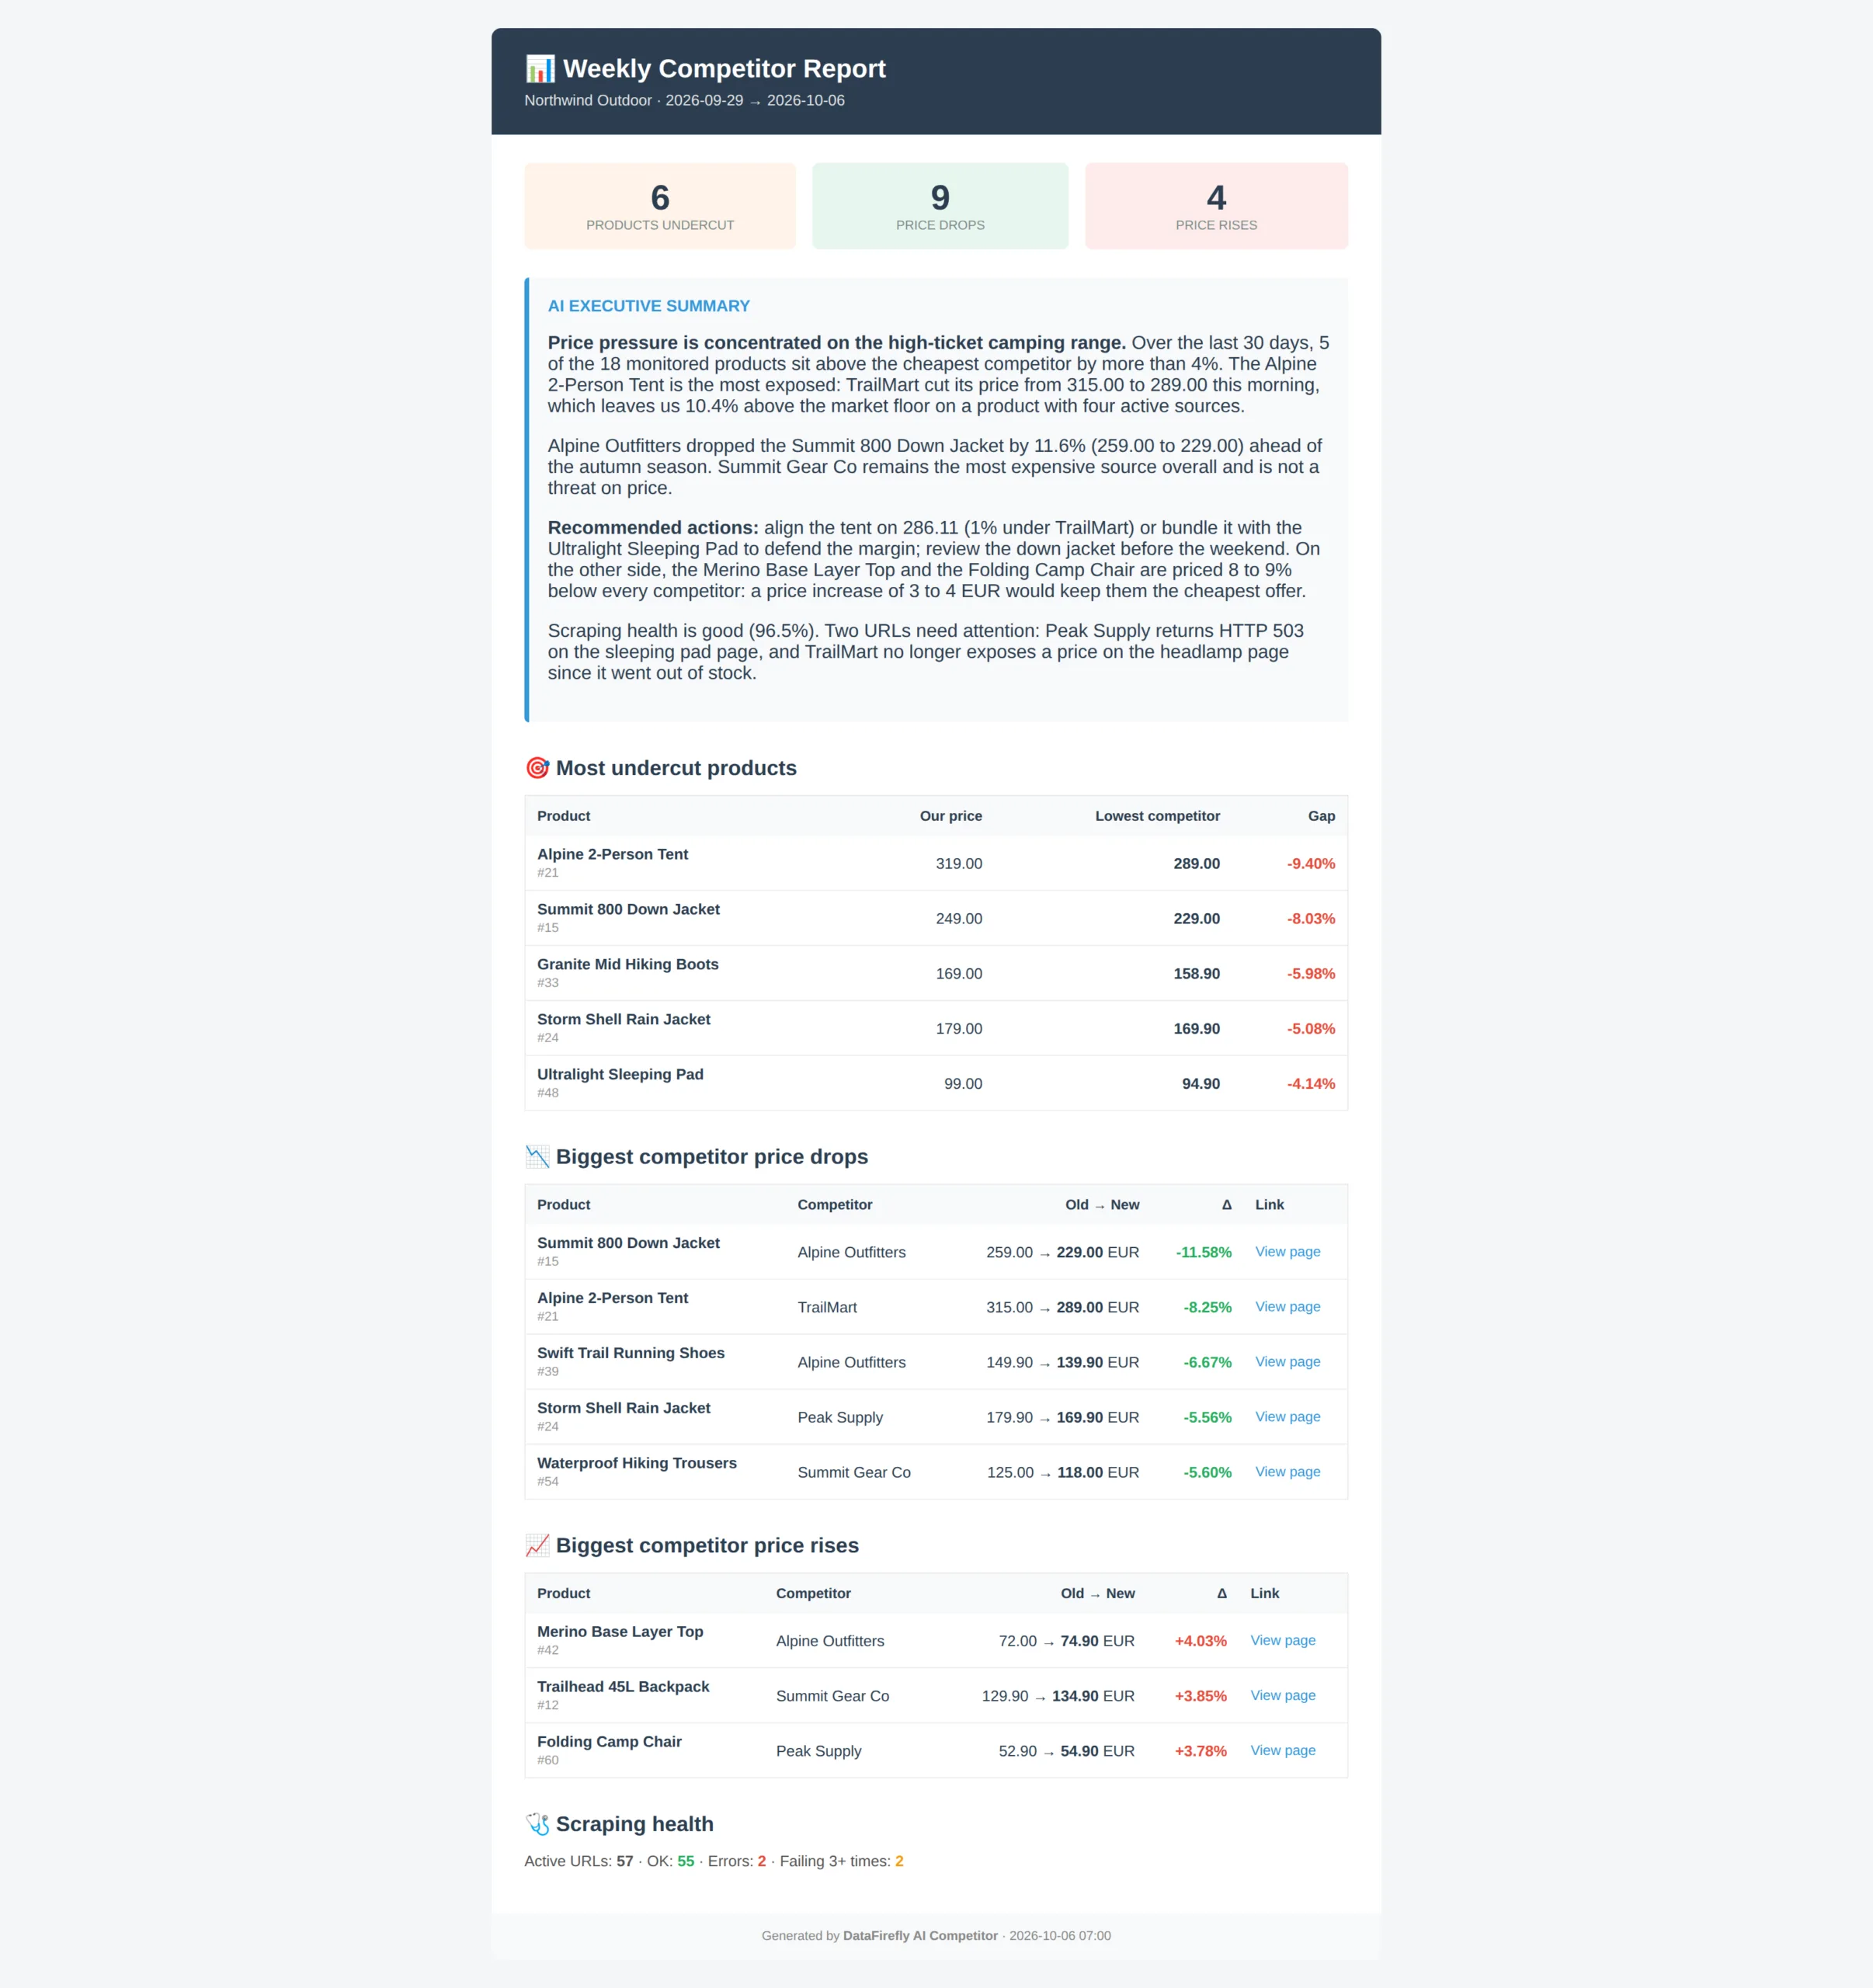
O limiar de ativação é configurável, 3 por cento por omissão. São geridos cinco tipos de alerta: descida de preço, subida, rutura de stock, regresso a stock, e undercut quando um concorrente desce abaixo do seu preço. Cada alerta é graduado pela gravidade. Uma variação de 1 por cento é anotada como info, uma descida de 15 por cento ou um undercut são qualificados como critical. Os erros de scraping só geram alerta ao fim de três falhas consecutivas, o que elimina o ruído das indisponibilidades passageiras. Todas as semanas, no dia que escolher, um relatório HTML resume o período e a IA redige a síntese executiva.
A sugestão de ajuste, sempre sob controlo humano
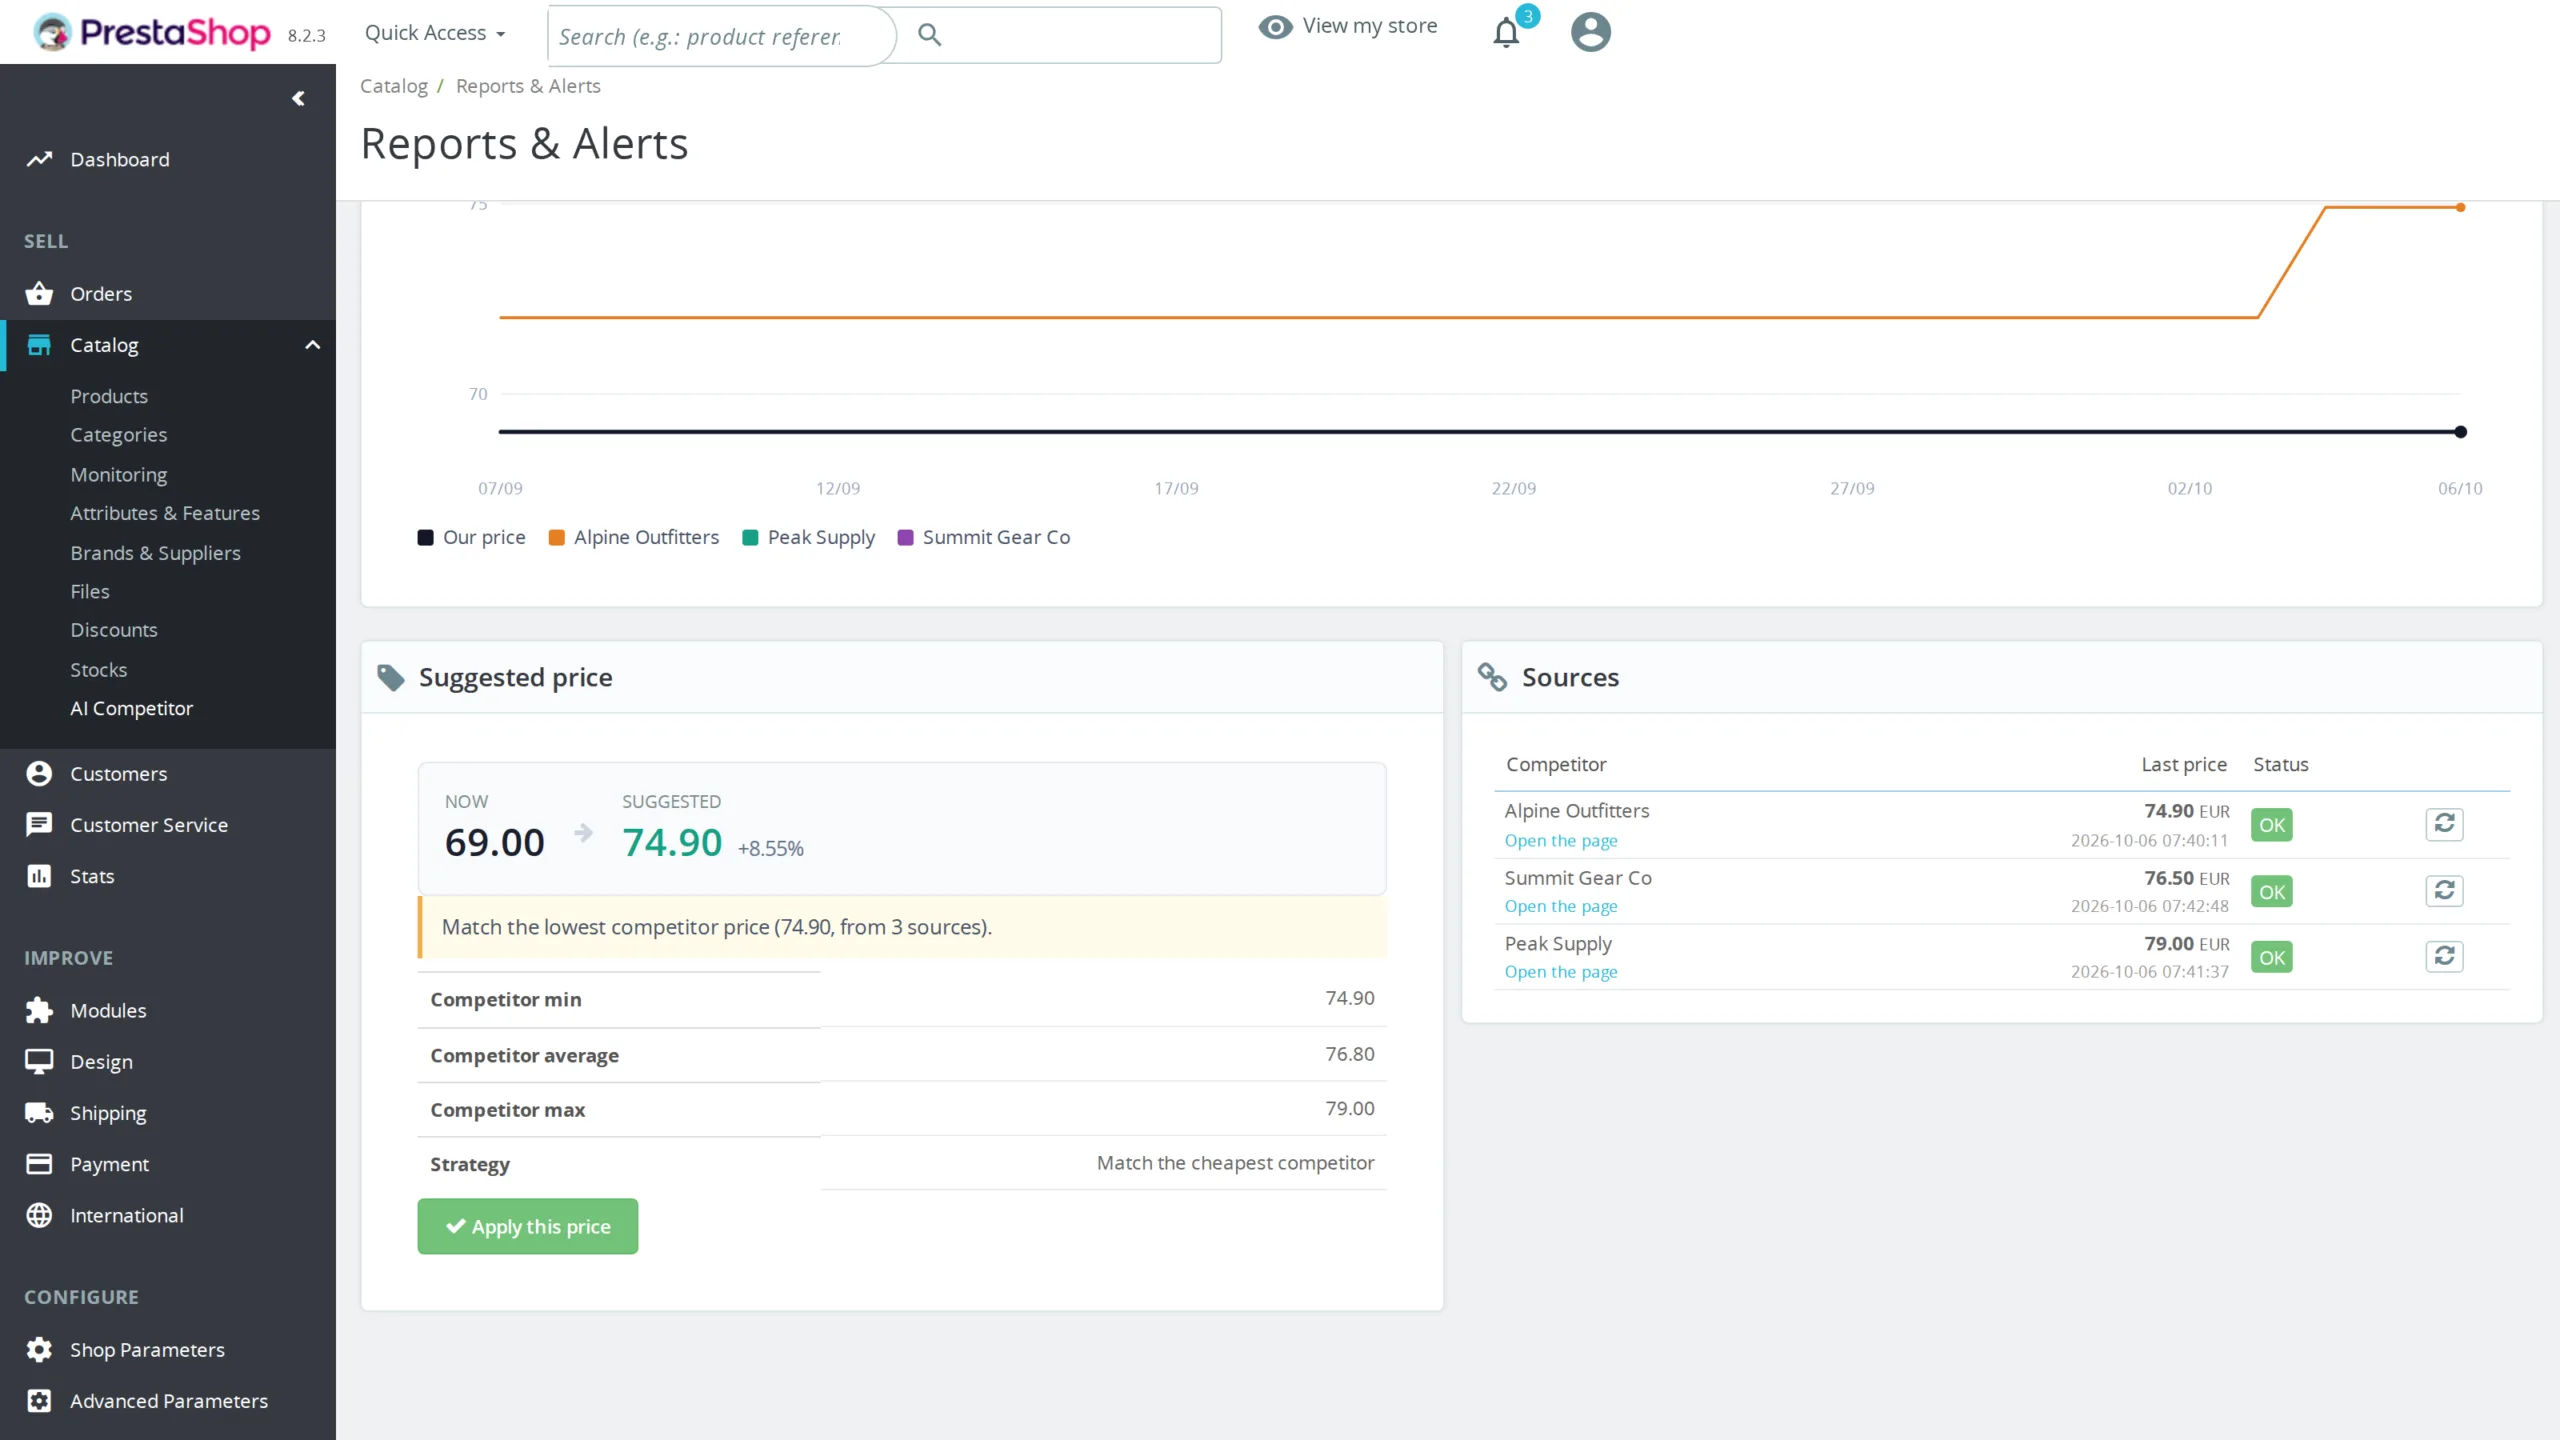
Para cada produto monitorizado o módulo calcula uma sugestão de preço segundo a estratégia configurada: igualar ao concorrente mais baixo, undercut de X por cento abaixo, ou posicionamento premium a X por cento acima. A sugestão é sempre apresentada a uma pessoa, com o preço atual e o proposto lado a lado. Um botão aplica o preço ao produto PrestaShop. Nenhum ajuste automático: sem espirais de descida em espelho com concorrentes equipados com o mesmo tipo de ferramenta, sem deriva descontrolada. A decisão comercial fica consigo.
Rastrear sem se tornar um incómodo
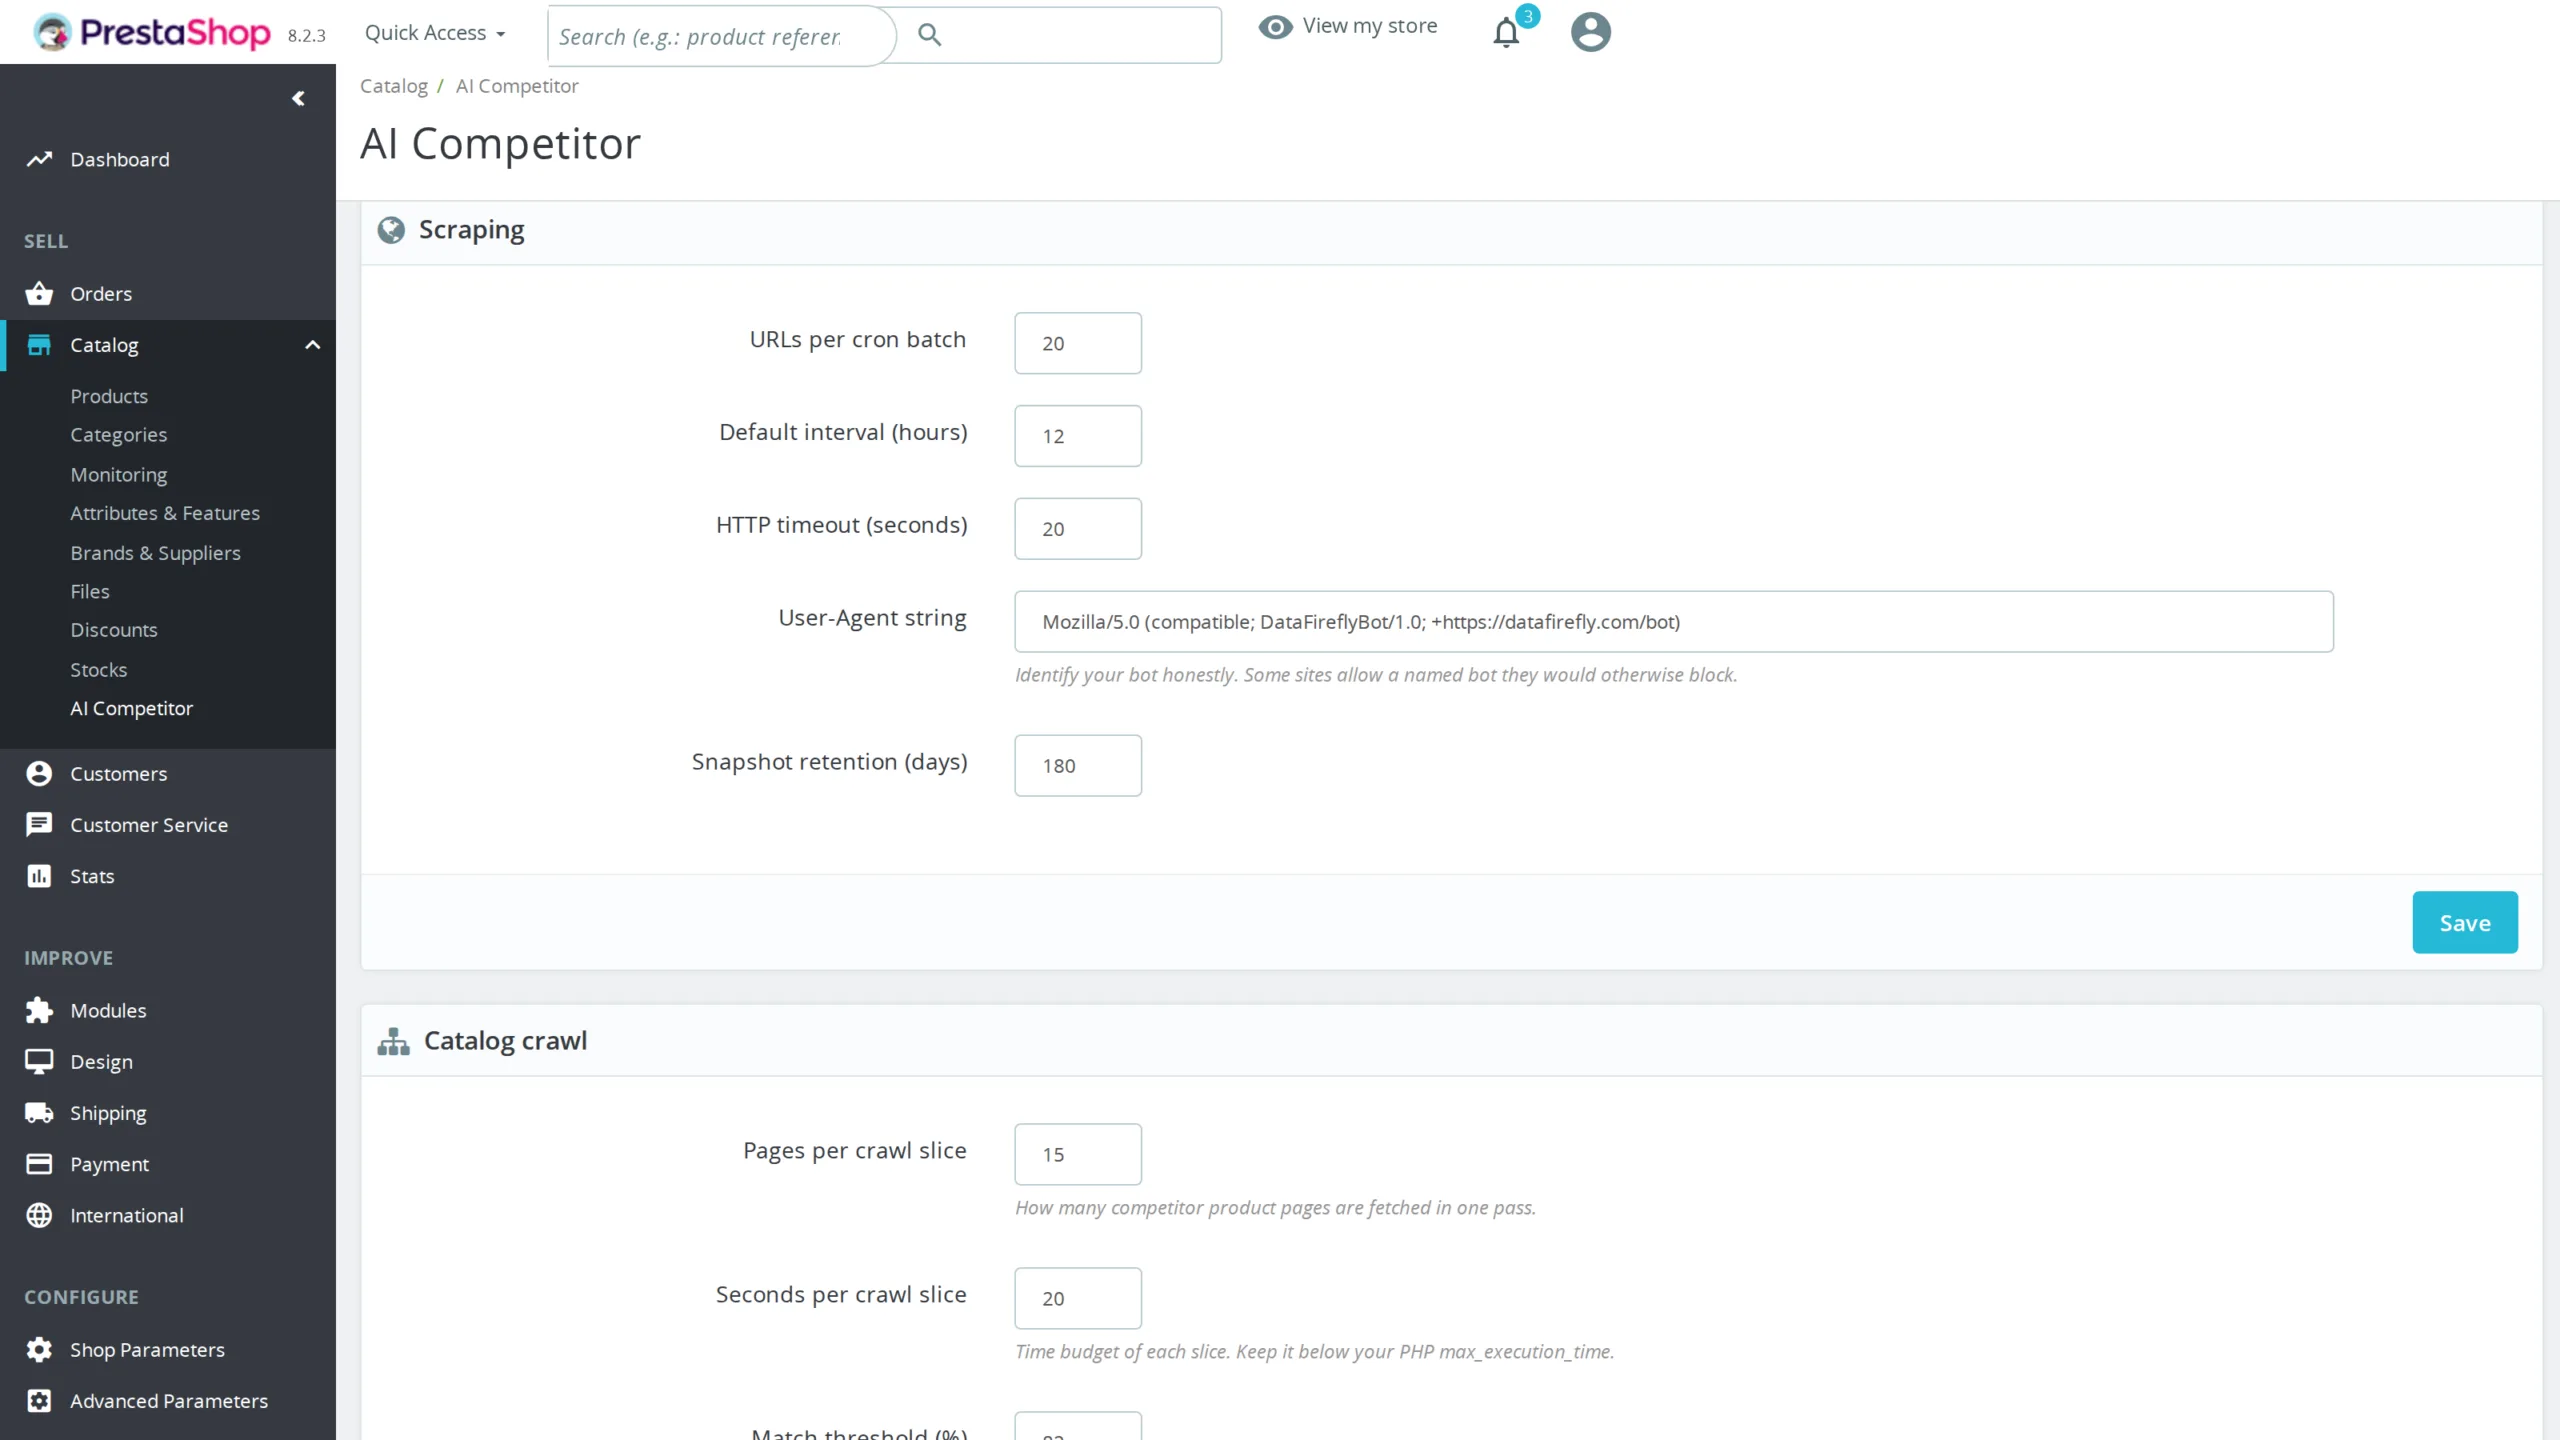
Ler os preços públicos de um concorrente é prática comercial corrente, e o módulo foi construído para o fazer corretamente. O robots.txt do site visado é respeitado por omissão, tanto na descoberta como na leitura das fichas, com a regra de precedência da norma entre Allow e Disallow. Um Crawl-delay publicado é respeitado, e entre dois pedidos aplica-se um atraso por concorrente, definido por omissão em um pedido por segundo. Um teto de produtos limita o volume de cada rastreio. O User-Agent identifica o robot pelo nome em vez de se fazer passar por um navegador. Estas definições podem ser desativadas concorrente a concorrente, mas a avaliação das condições de utilização do site visado cabe-lhe a si.
Instalação e exploração simples
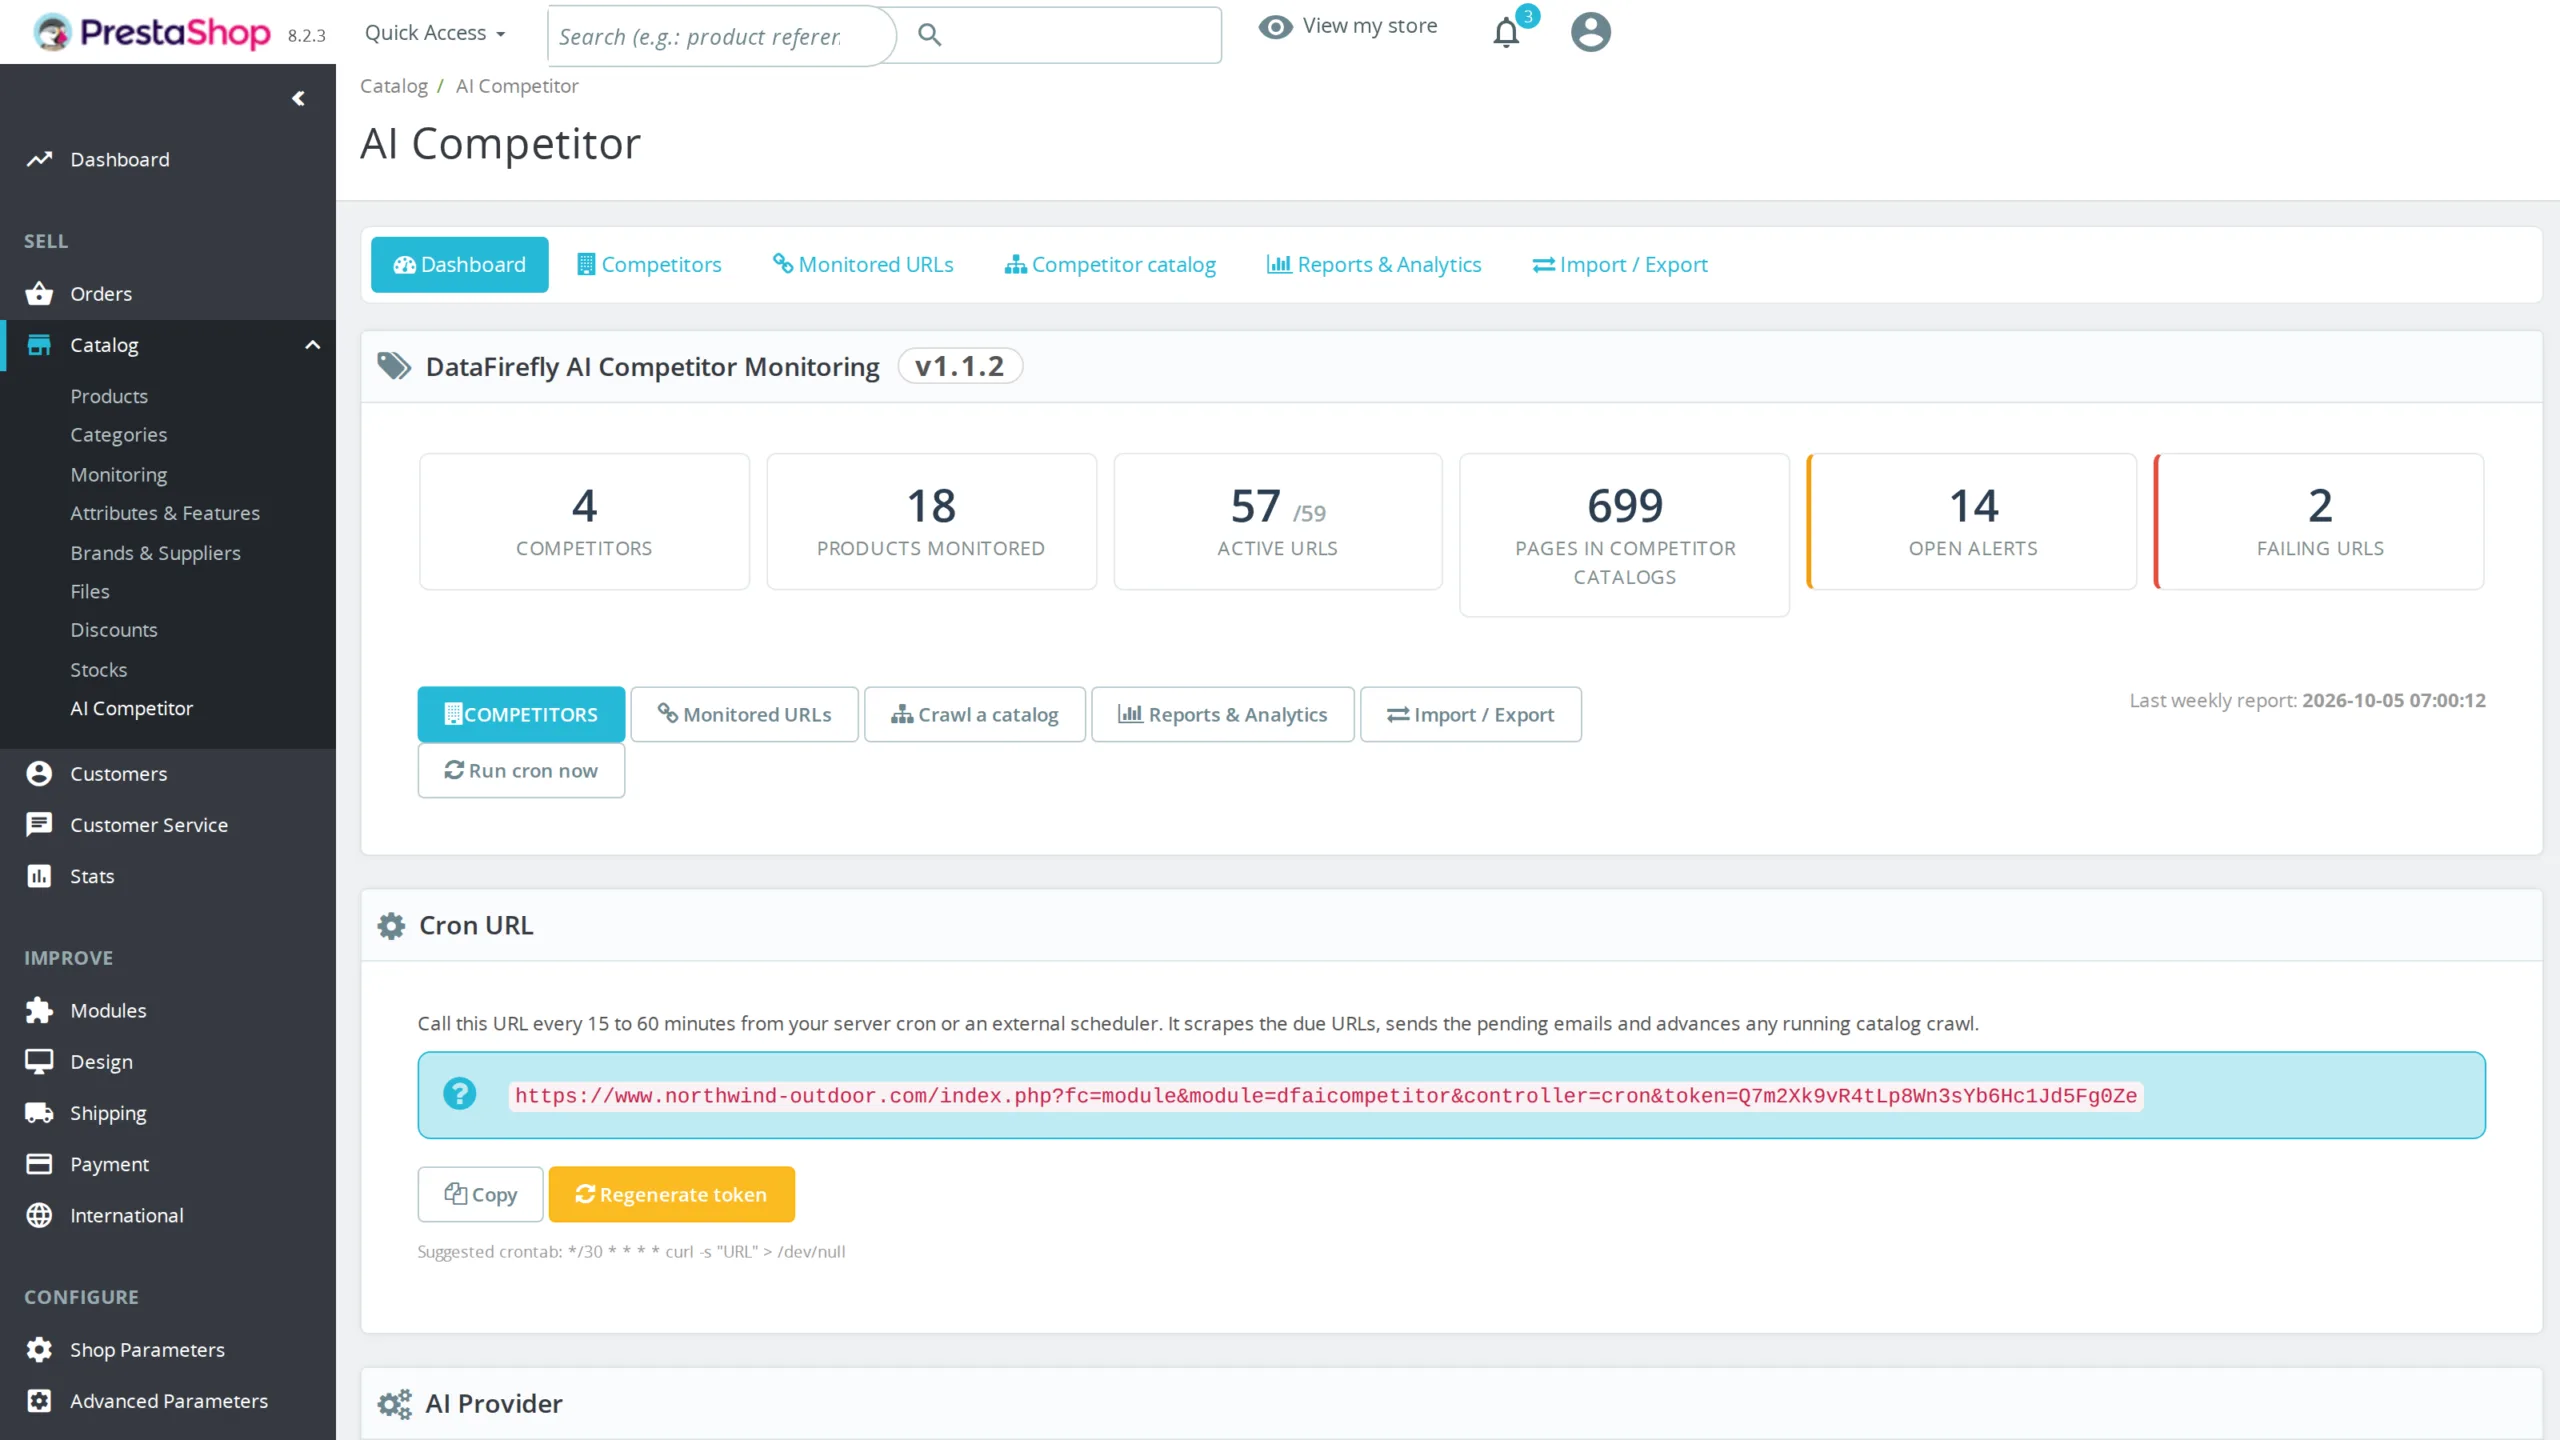
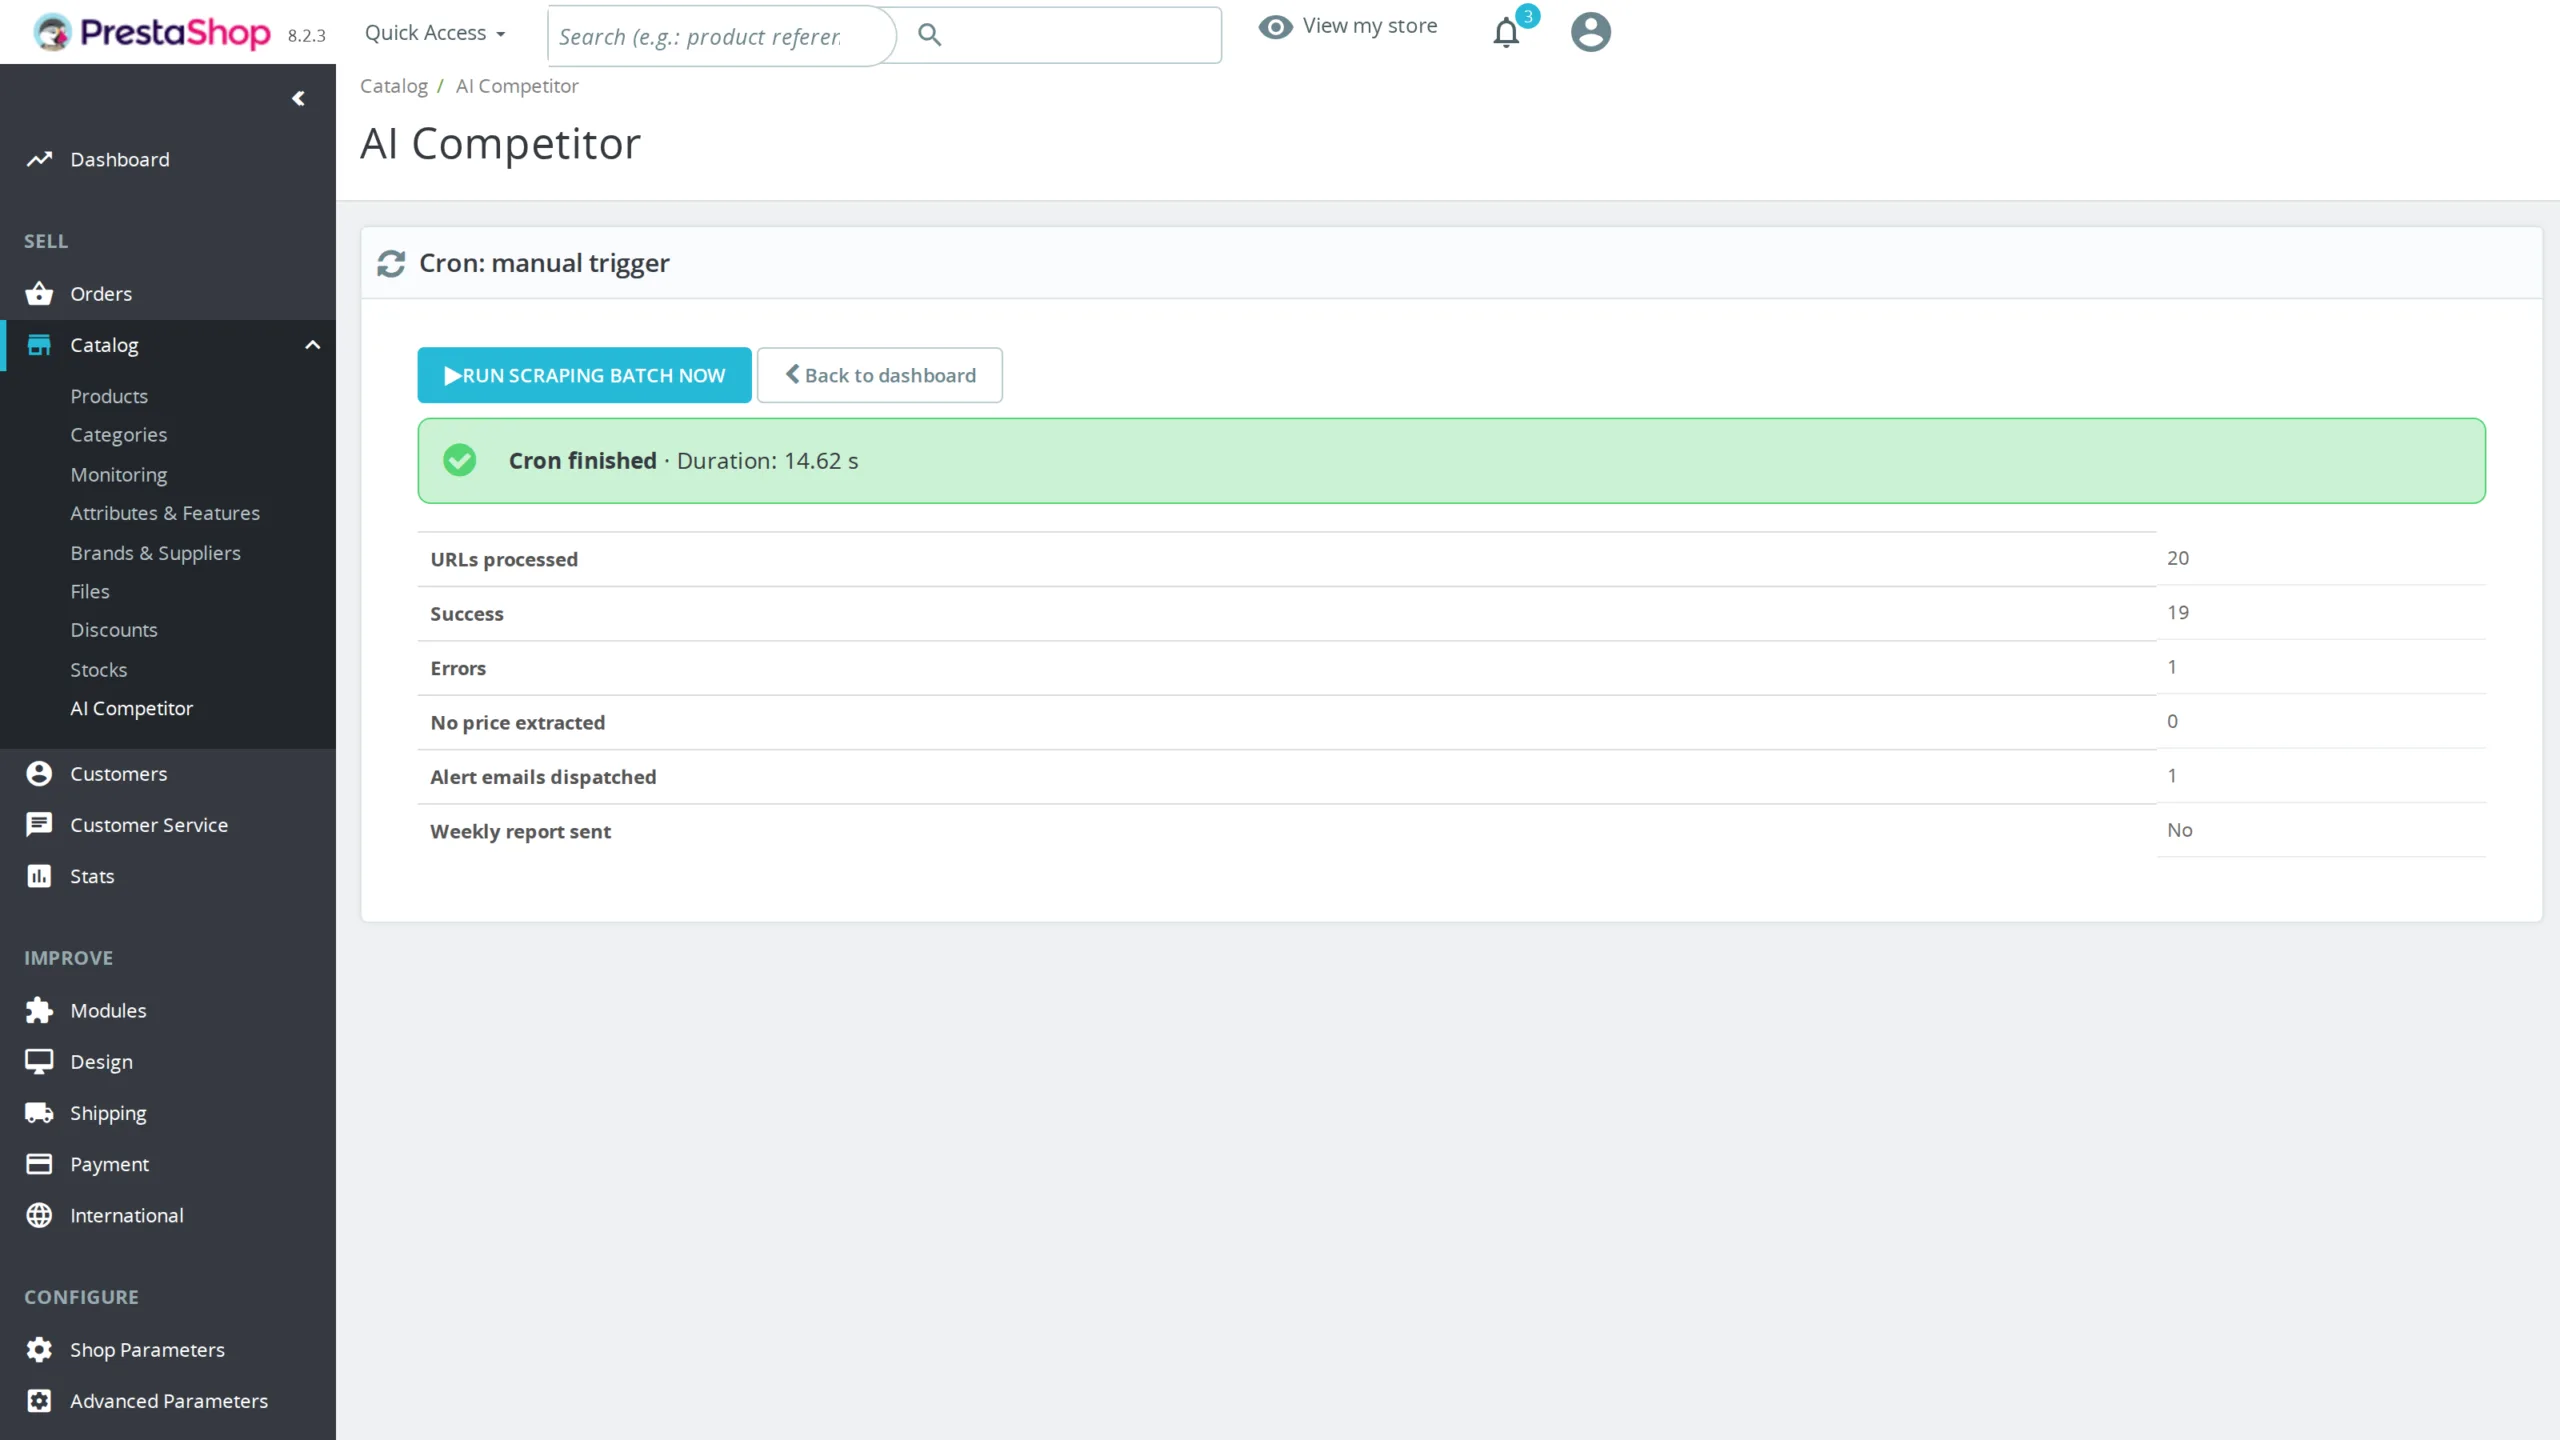
Instalação pelo carregador de módulos padrão do PrestaShop. Cinco minutos de configuração: fornecedor de IA, chave API, email de notificação, dia do relatório semanal, estratégia de ajuste. O módulo fornece o seu próprio URL de cron protegido por token, regenerável a partir do painel. Cron sugerido a cada 30 minutos: a passagem lê os URLs vencidos, envia os emails pendentes, faz avançar um rastreio em curso e limpa o histórico expirado. Sem dependências Composer, sem qualquer serviço externo imposto para além do fornecedor de IA que escolher.
Compatibilidade PrestaShop 8 e 9 garantida
O módulo usa unicamente APIs estáveis entre versões: ObjectModel para as entidades, ModuleAdminController com HelperList e HelperForm para o back office, ModuleFrontController para o endpoint cron. A tradução passa pela instância do módulo e não pelo método removido do AdminController no PrestaShop 9, e as ligações AJAX são construídas com os parâmetros no quarto argumento de getAdminLink, como o PrestaShop 9 espera. Nenhuma injeção invasiva no separador de produto Symfony. Não precisa de esperar por uma atualização quando migrar.
Ainda não existem avaliações.