
Tout ce que vous voudriez savoir avant d'installer.
Un regard détaillé sur le fonctionnement de AI Competitor — Veille tarifaire concurrents avec IA, pourquoi nous l'avons conçu ainsi, et la réflexion derrière les fonctionnalités ci-dessus.
§ 01
Pourquoi surveiller les prix concurrents en continu
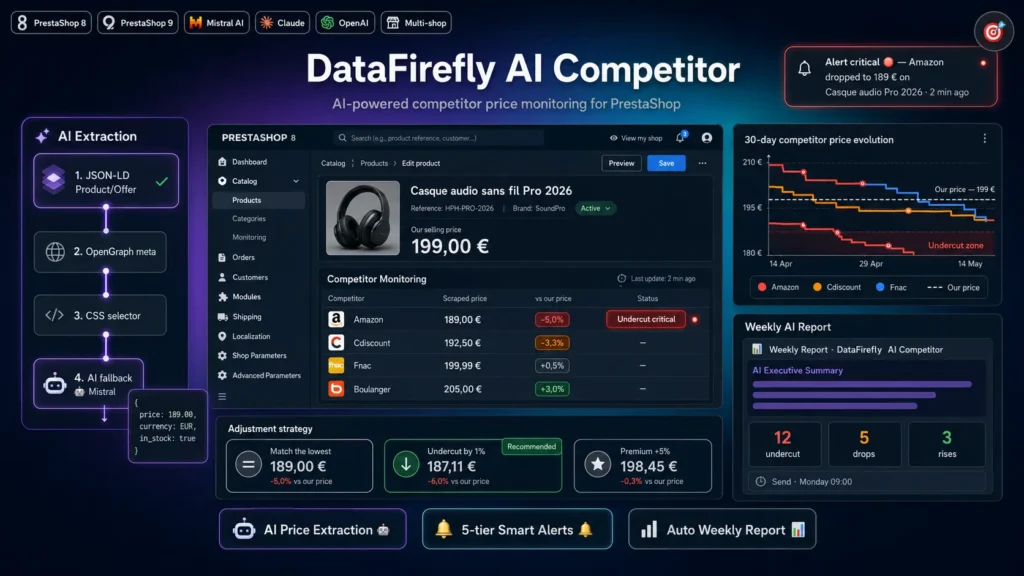
Sur le e-commerce français, deux acheteurs sur trois comparent les prix avant d'acheter. Une variation de 3 pourcent chez un concurrent direct peut faire basculer une décision d'achat. Sans veille automatisée, vous découvrez ces écarts trop tard, après avoir perdu la vente. AI Competitor surveille vos concurrents en arrière-plan, à la fréquence que vous choisissez, et vous prévient seulement quand c'est pertinent.
§ 02
Récupérer le catalogue complet d'un concurrent
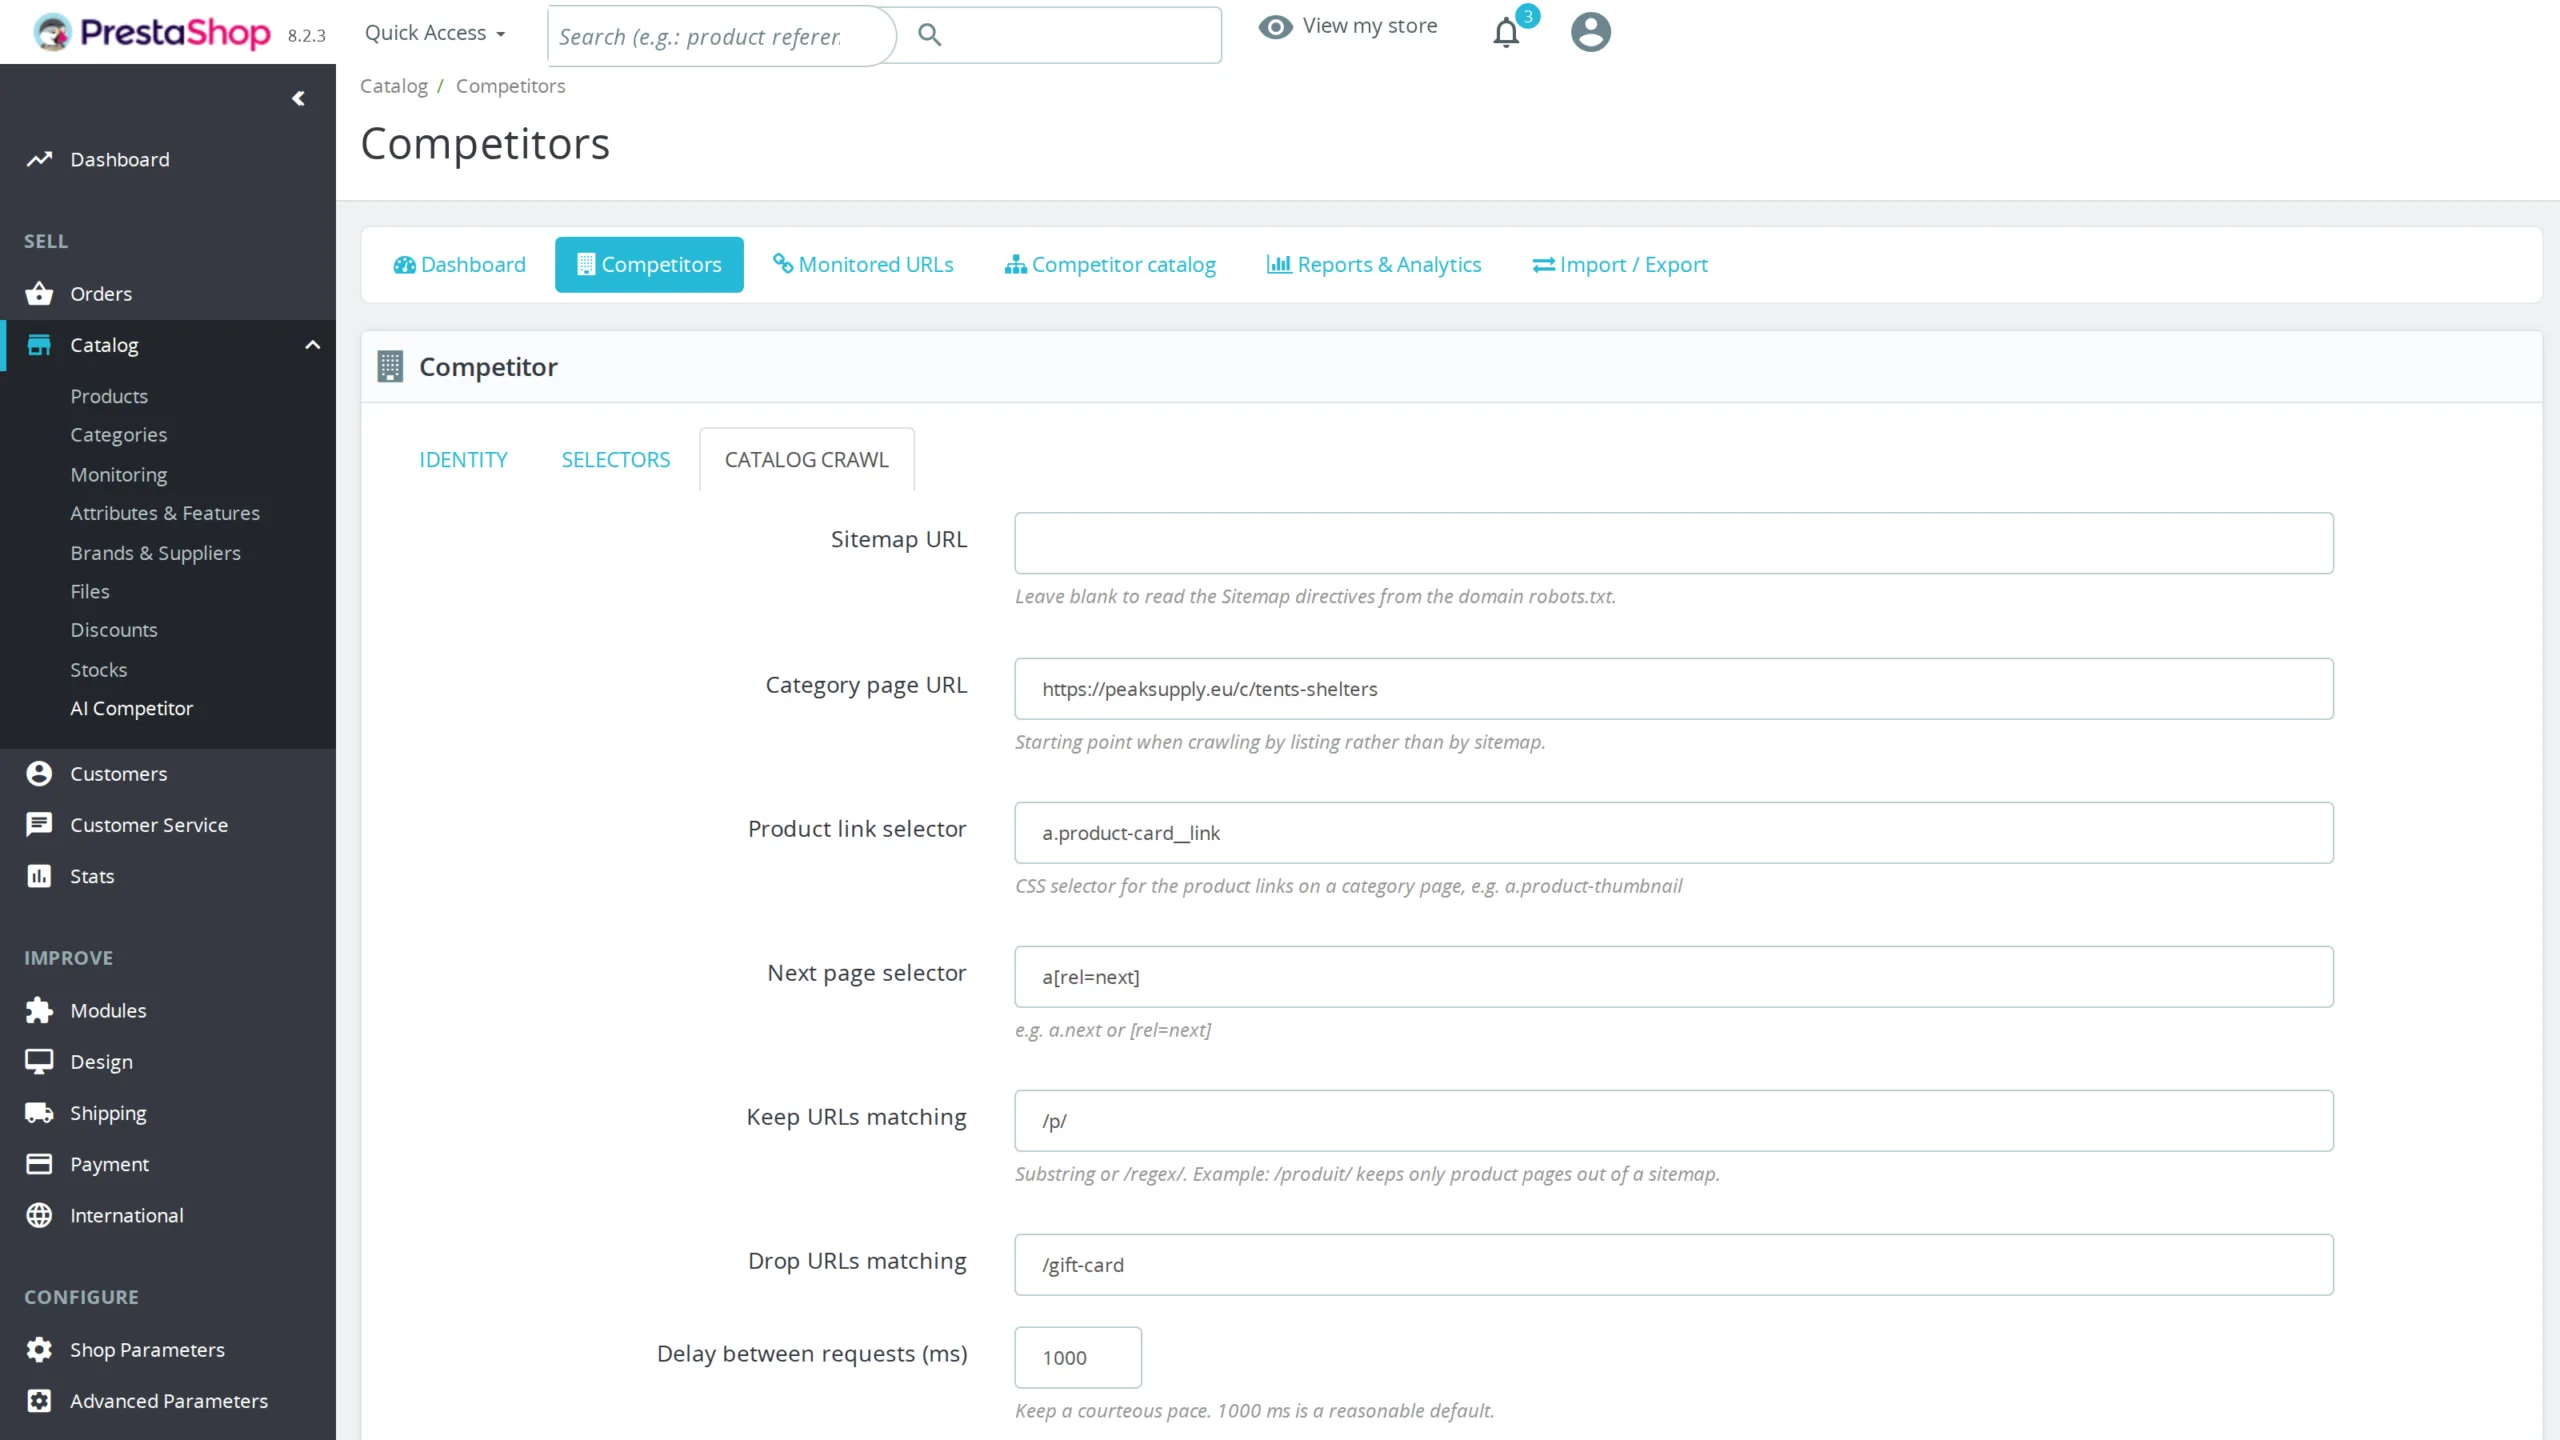
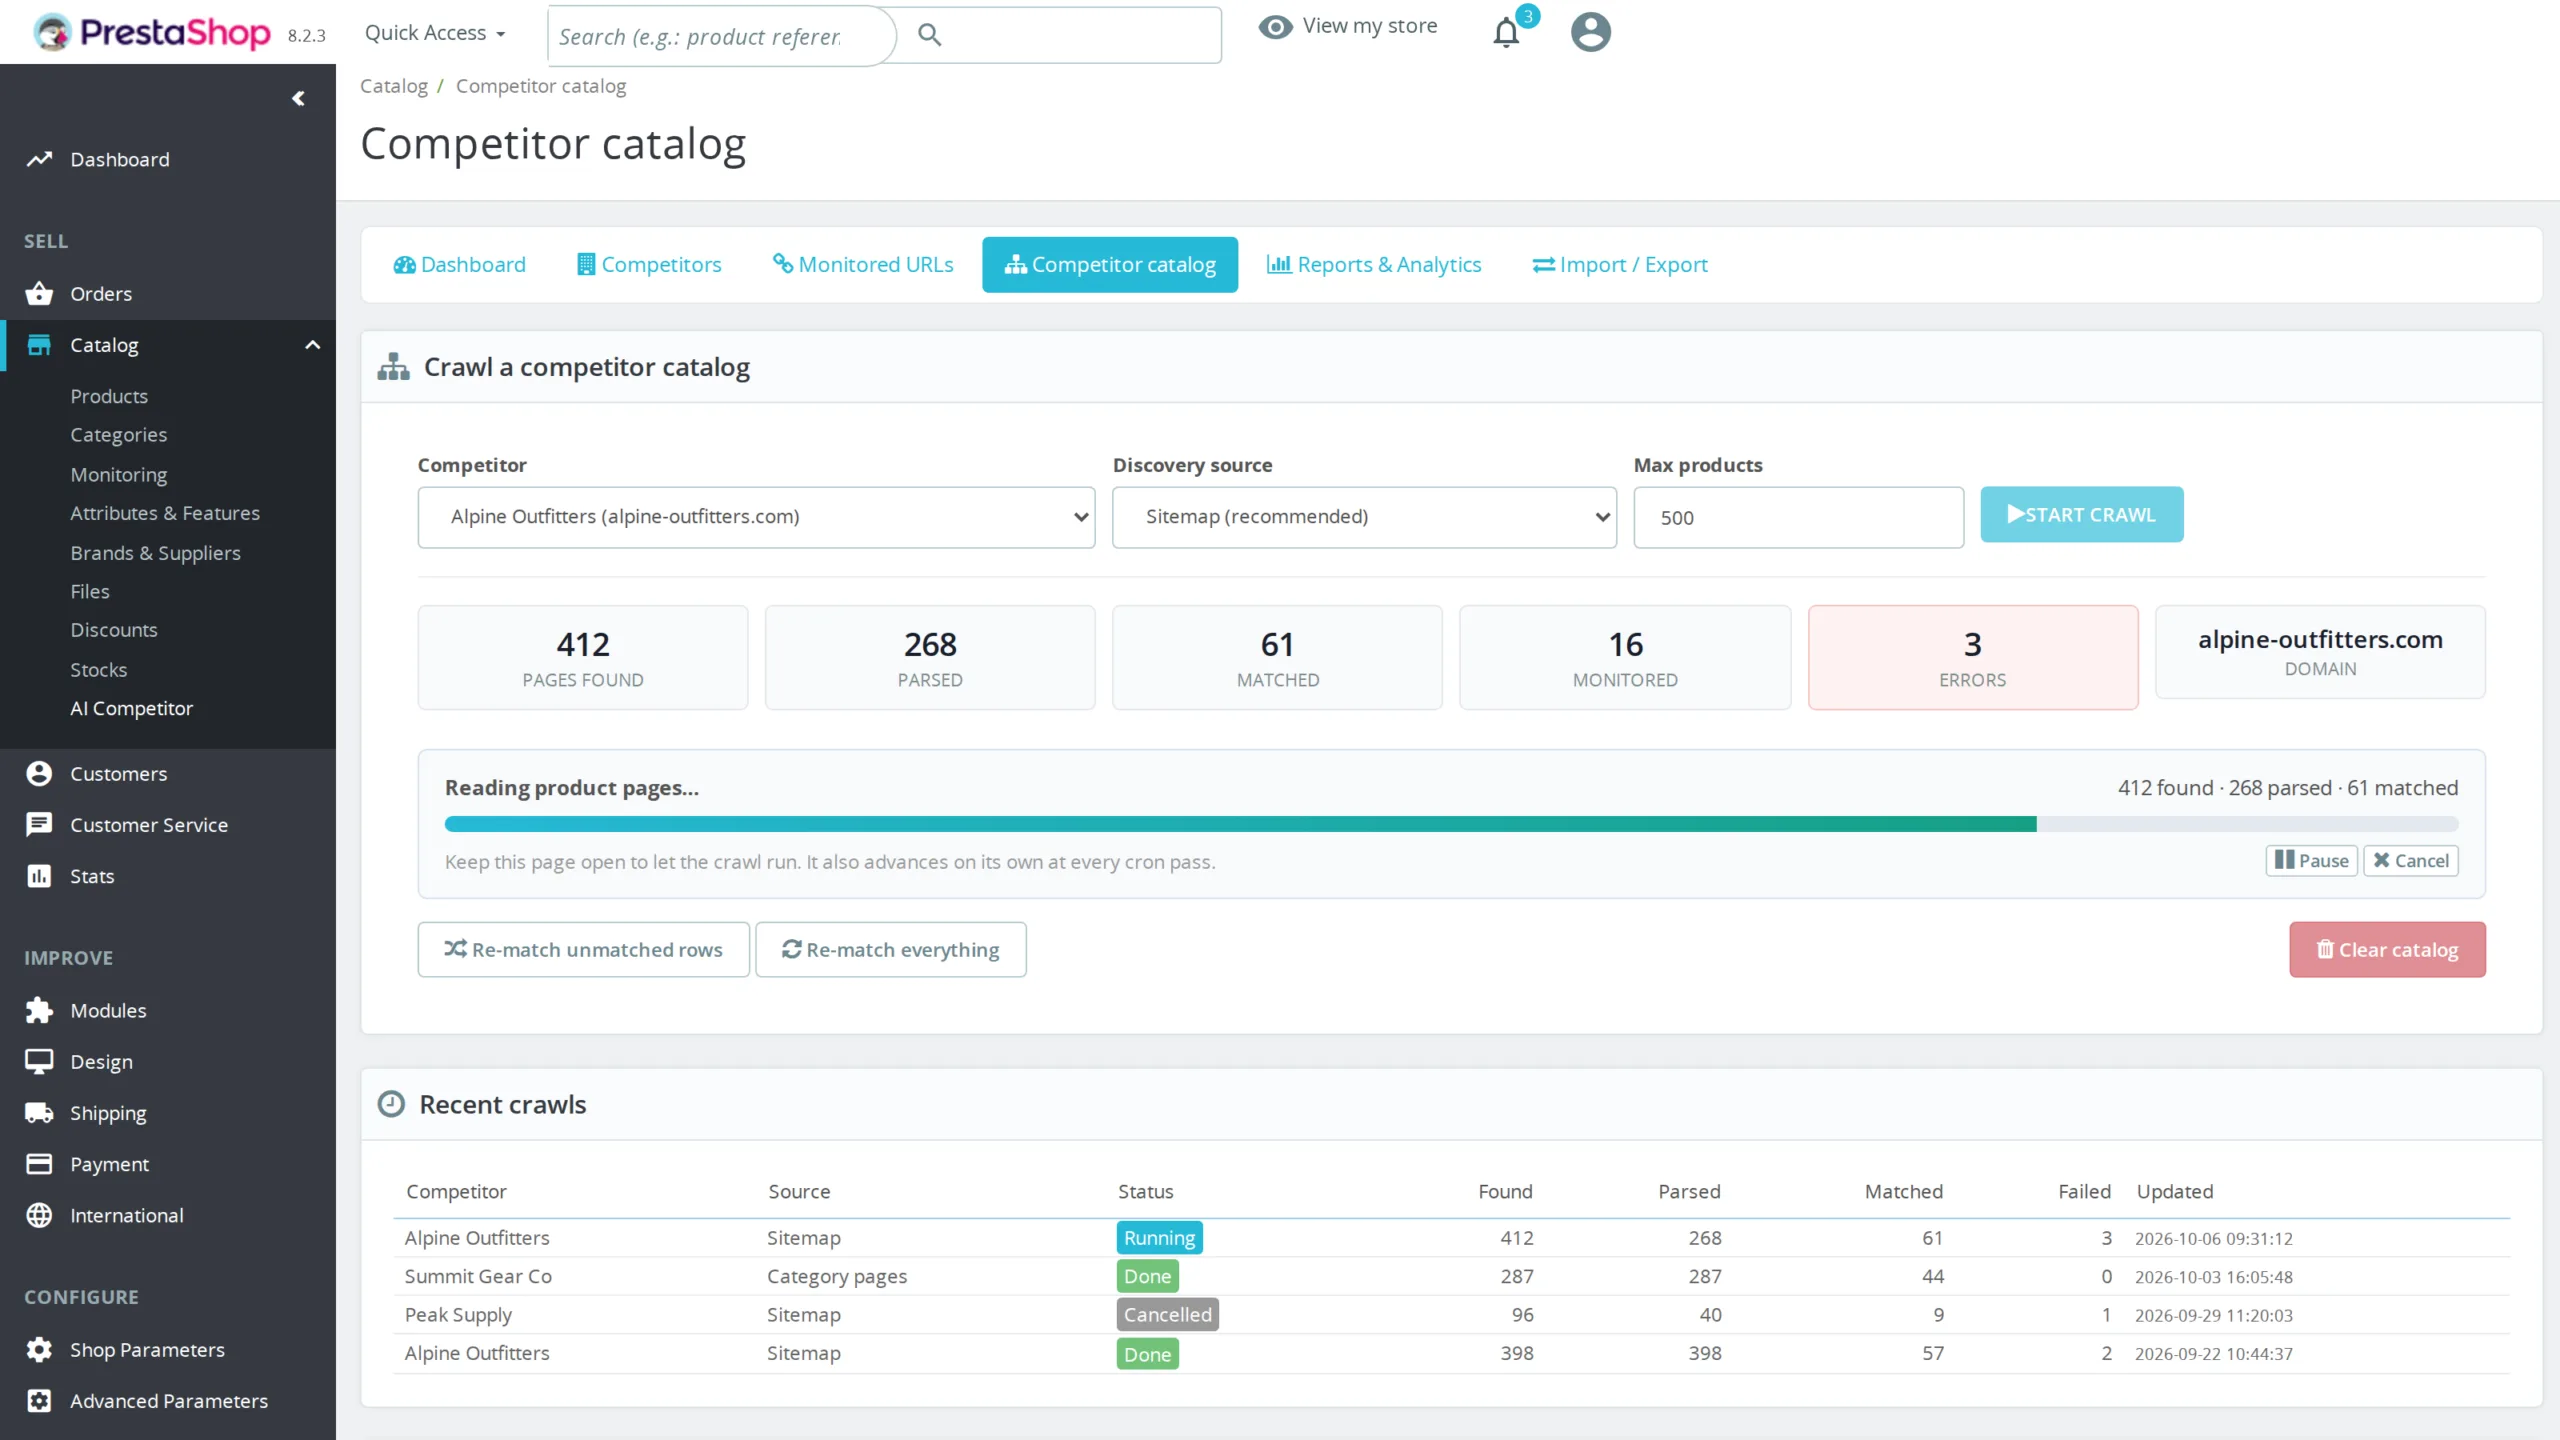
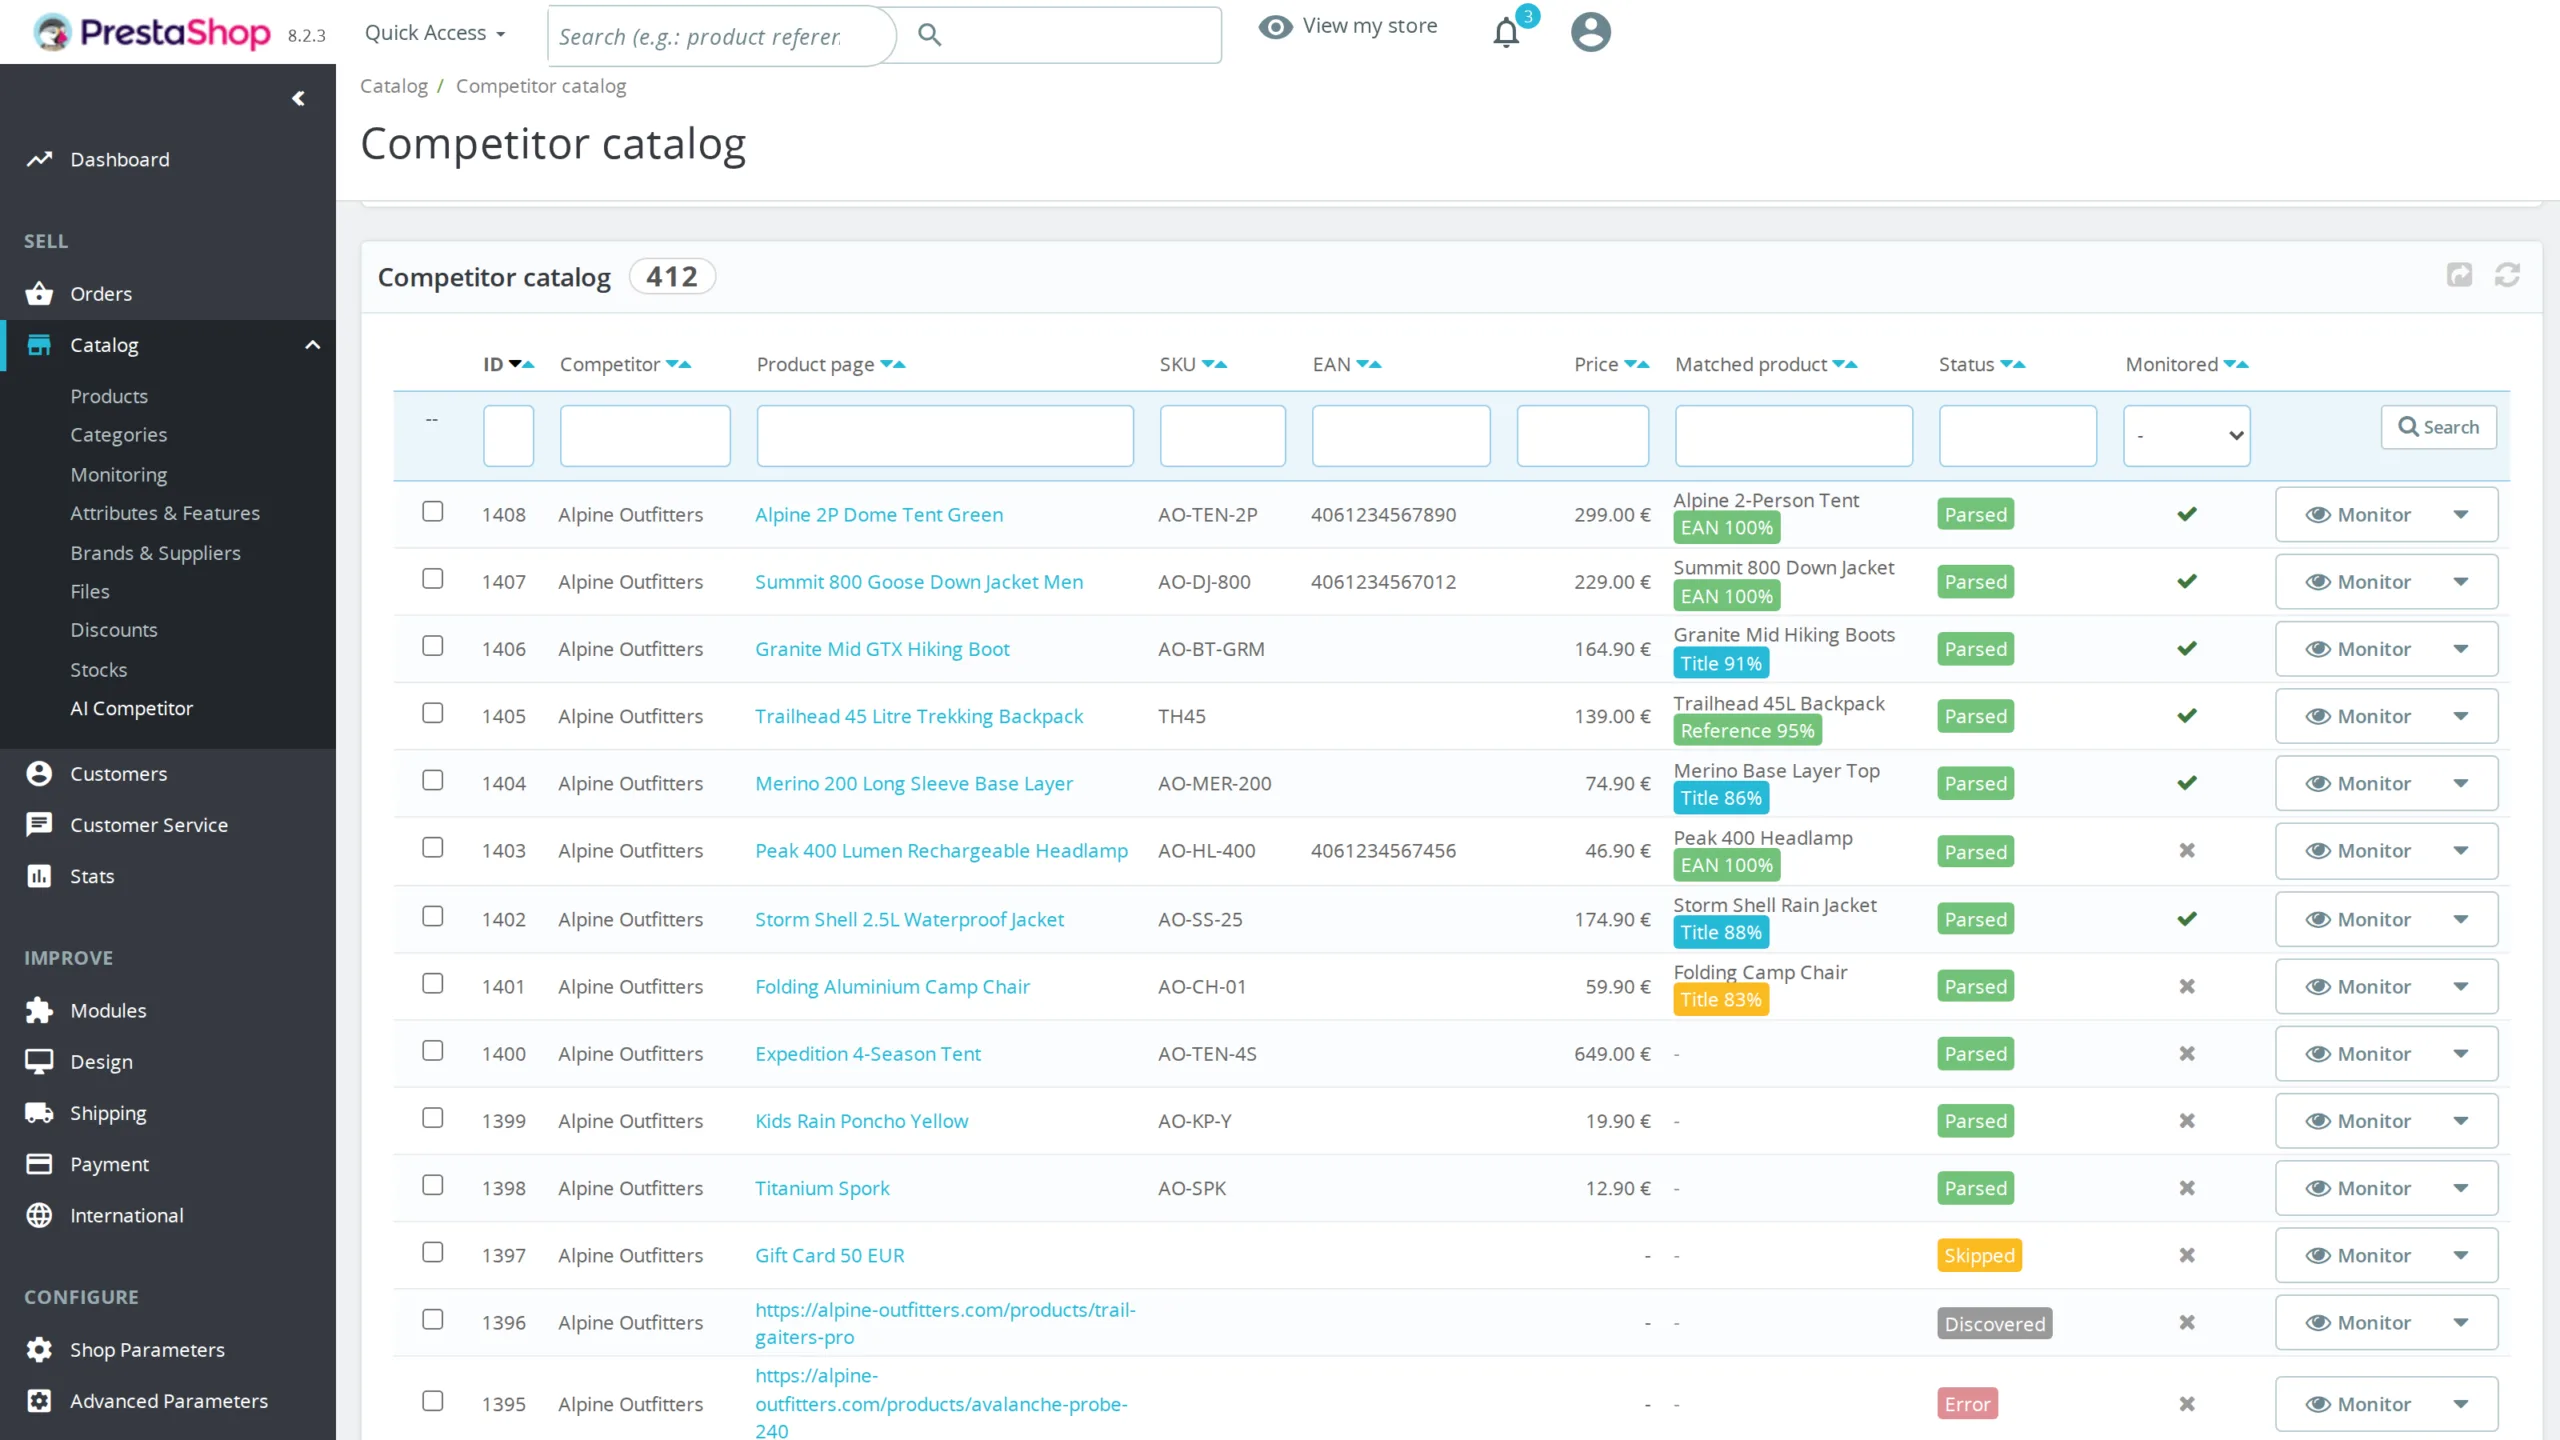
Saisir les URLs concurrentes une par une ne tient pas à l'échelle d'un catalogue réel. Le module construit lui-même la liste : vous indiquez un domaine, il lit le sitemap déclaré ou celui annoncé par le robots.txt, suit les index de sitemaps de façon récursive, et retient les adresses qui correspondent au motif de vos pages produit. Si le concurrent n'expose pas de sitemap exploitable, le crawl part d'une page catégorie, collecte les liens produit et suit la pagination. Chaque page découverte est ensuite ouverte pour en extraire titre, SKU, EAN, marque, prix, disponibilité et image.
§ 03
Le rapprochement avec votre catalogue
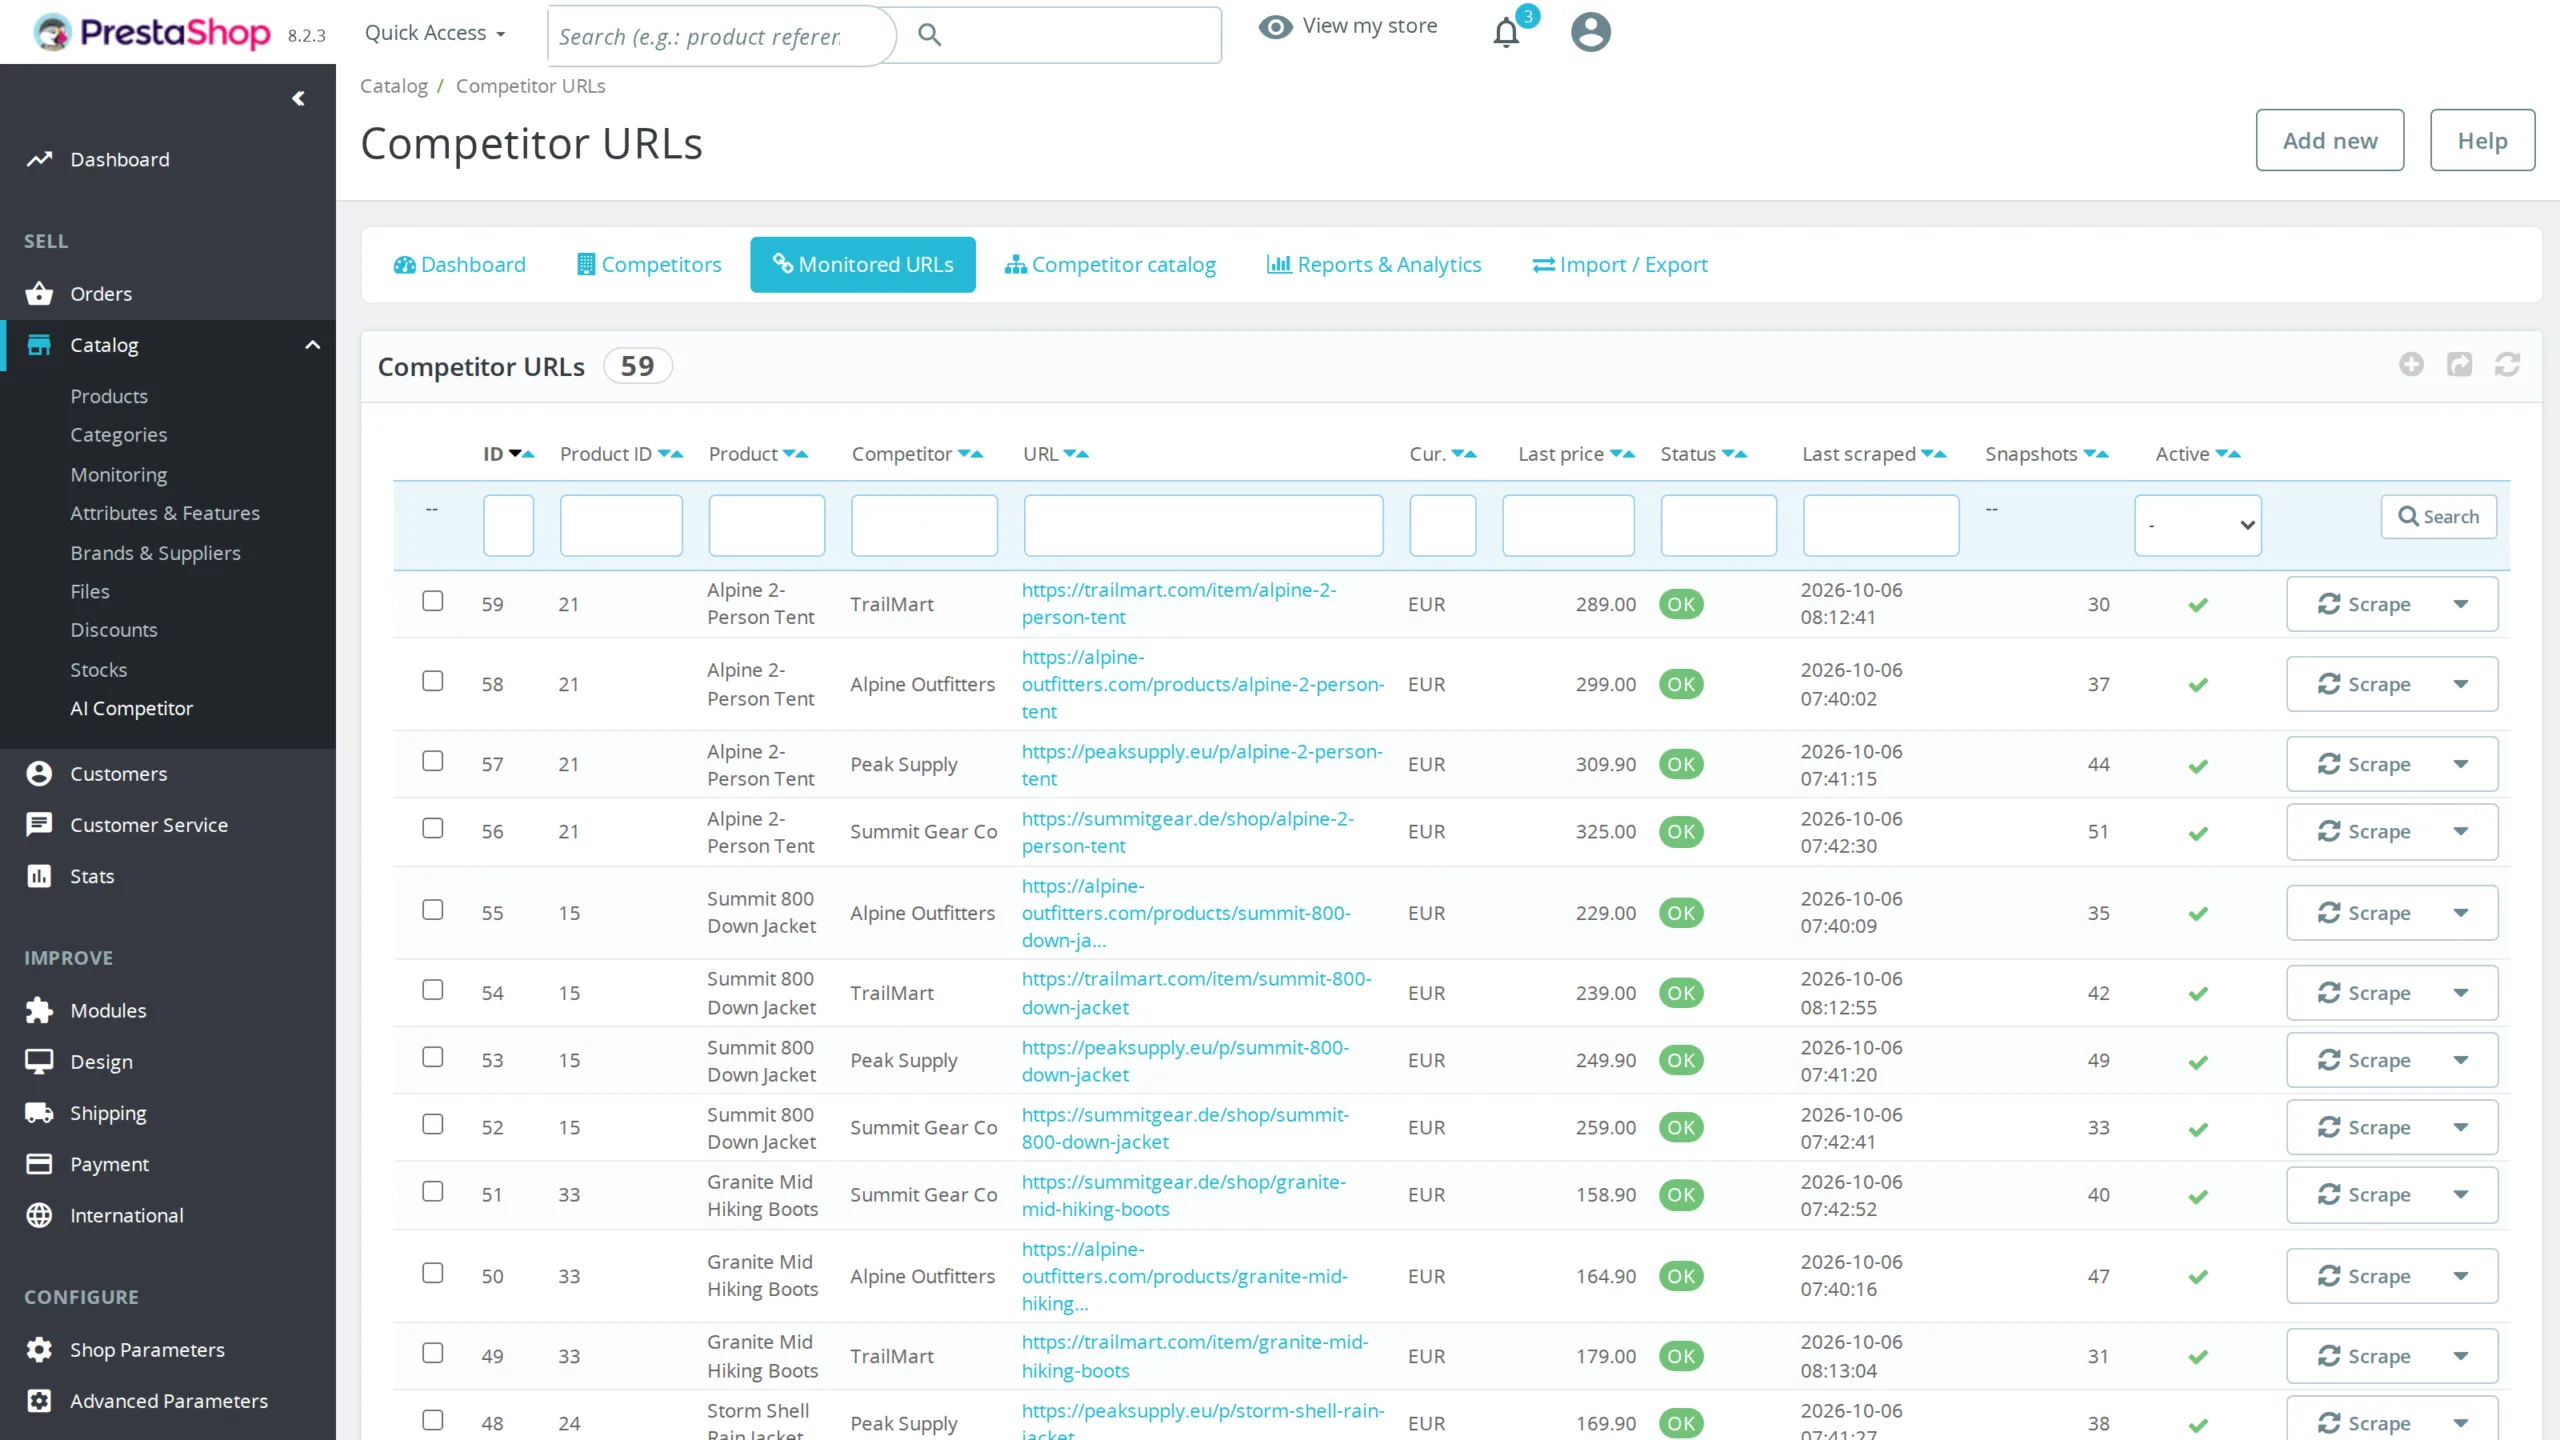
Une liste de pages concurrentes n'a de valeur que rapprochée de vos propres produits. Le module tente d'abord l'EAN13, sur le produit comme sur ses déclinaisons, ce qui donne une correspondance certaine. À défaut, il compare la référence, la référence fournisseur et le MPN. En dernier recours il évalue la similarité des titres, avec une pondération qui donne plus de poids aux numéros de modèle et aux marques qu'aux mots courants, et un seuil que vous réglez. Les correspondances douteuses restent visibles et se corrigent à la main avec une autocomplétion sur votre catalogue. Une page rapprochée devient une URL surveillée en un clic, ou en masse depuis la liste.
§ 04
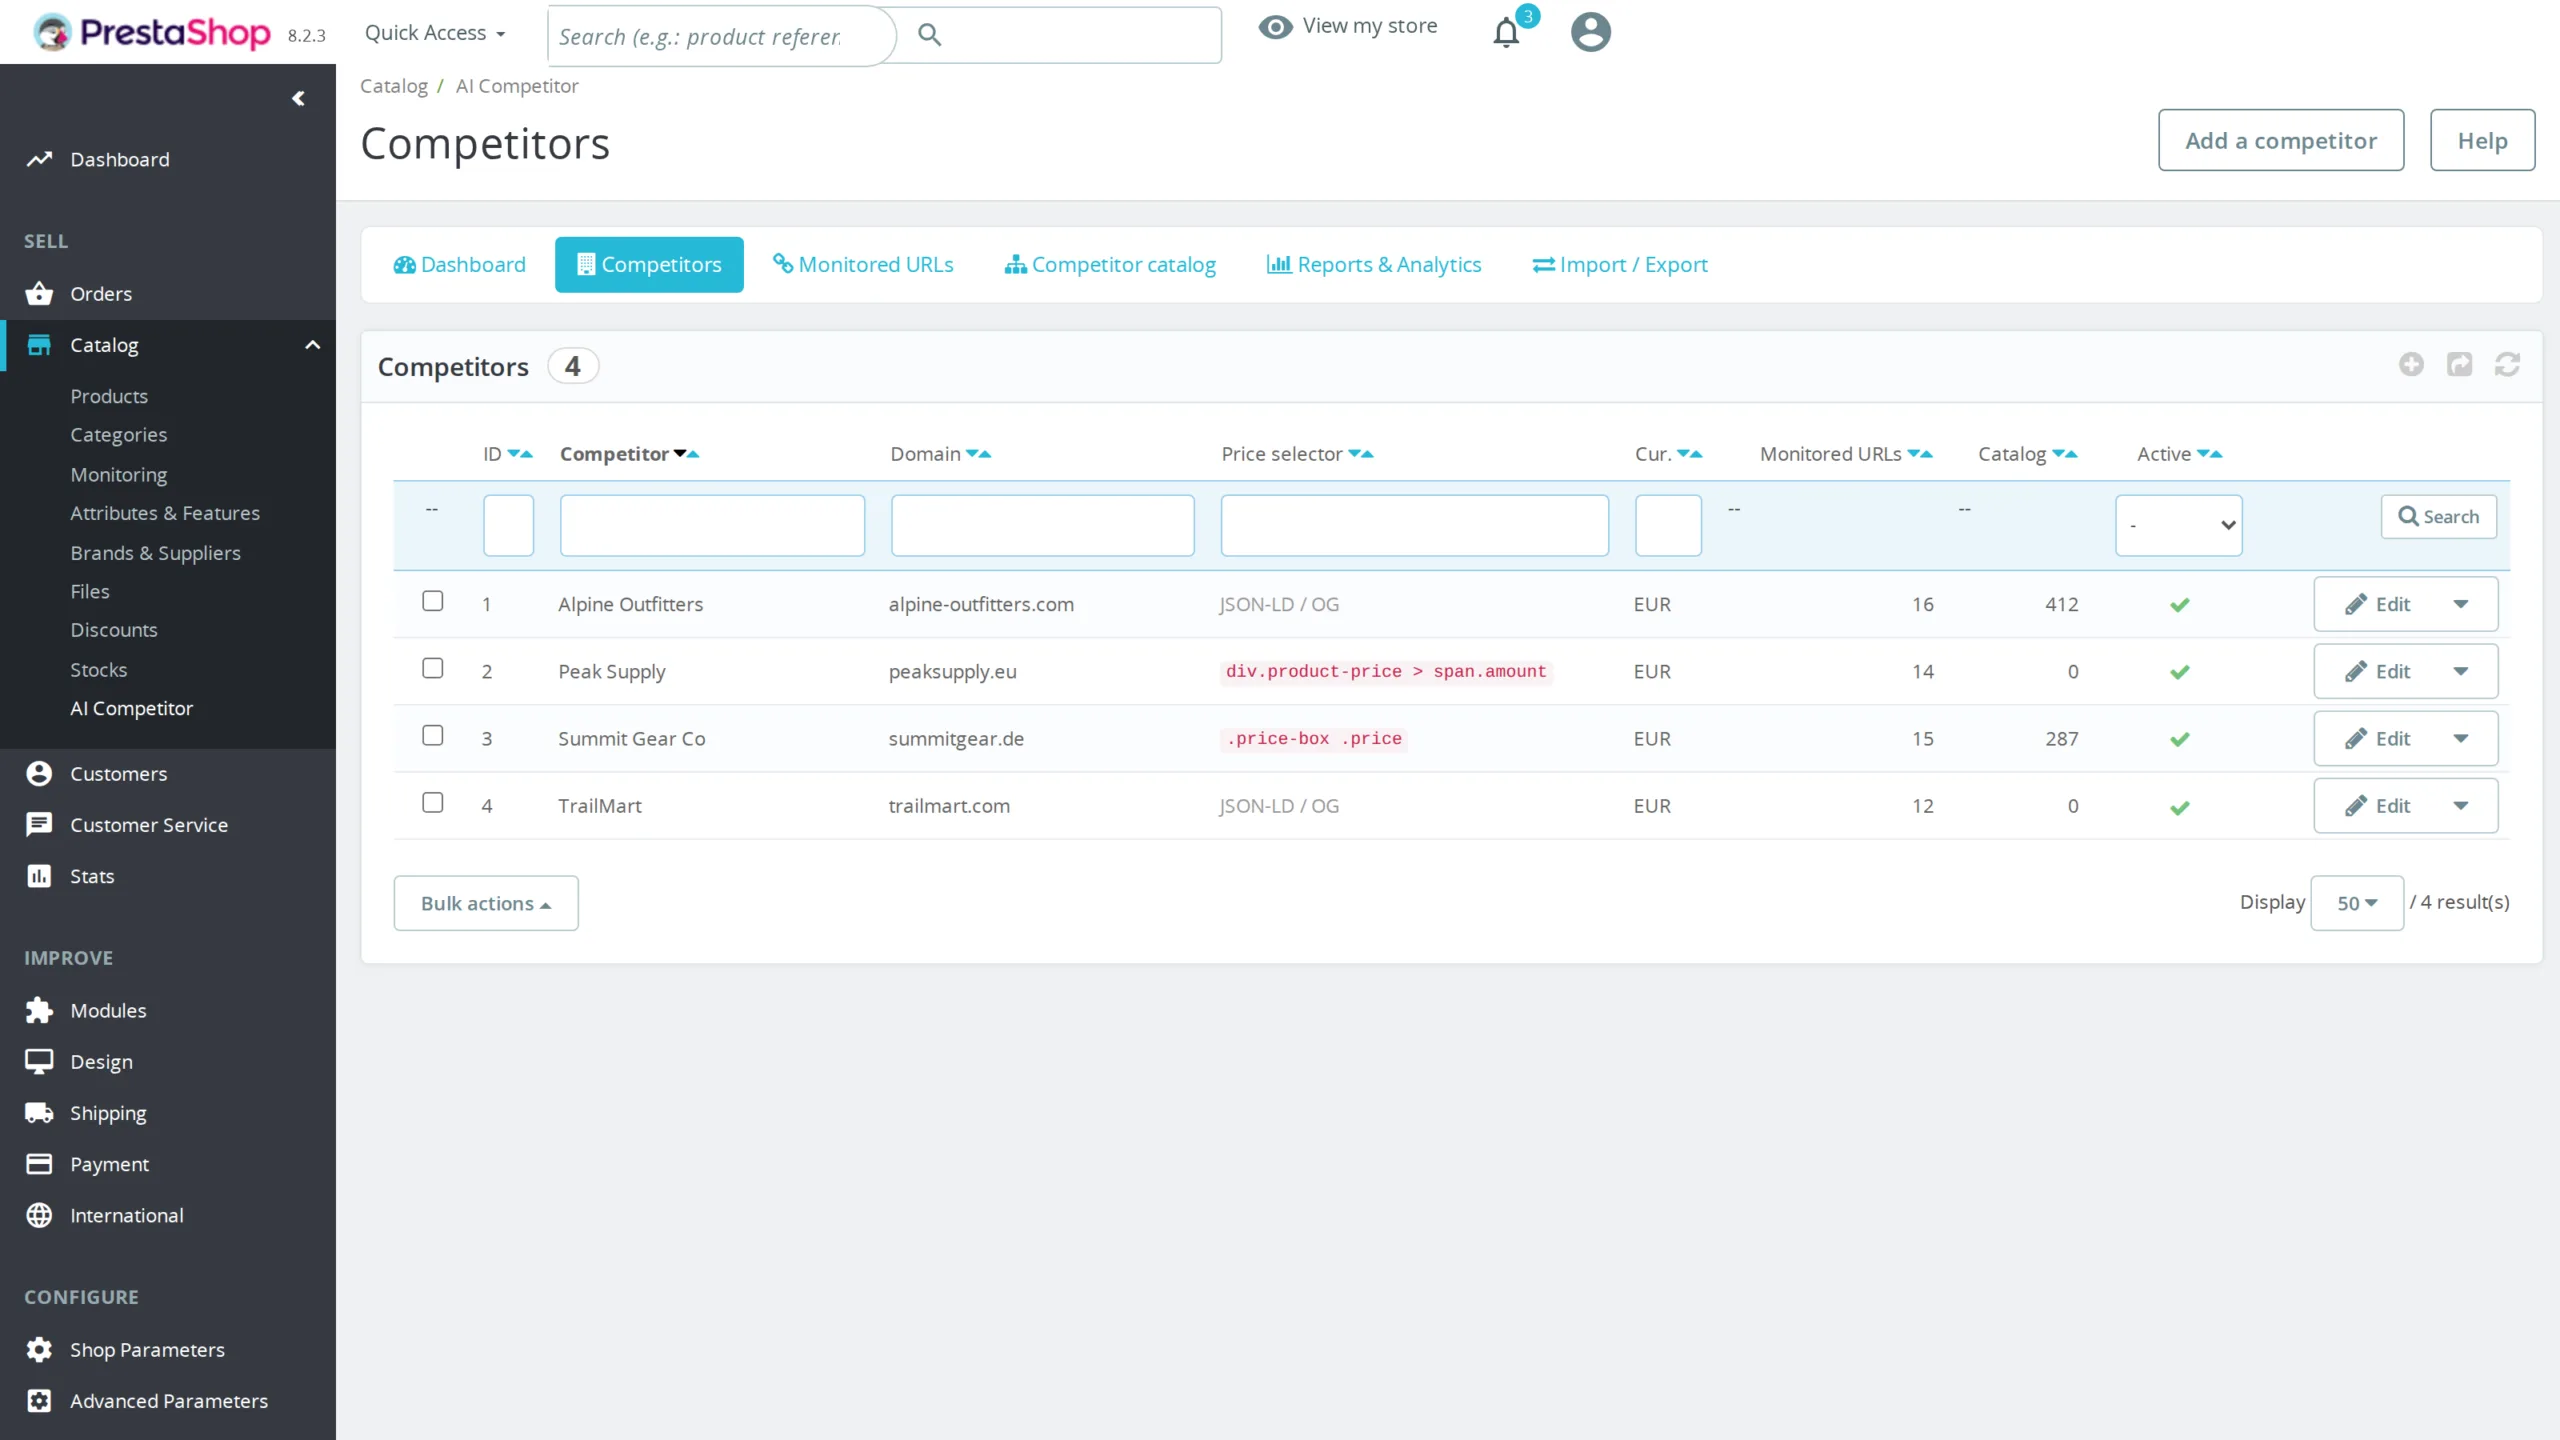
Un concurrent défini une fois, réutilisé partout
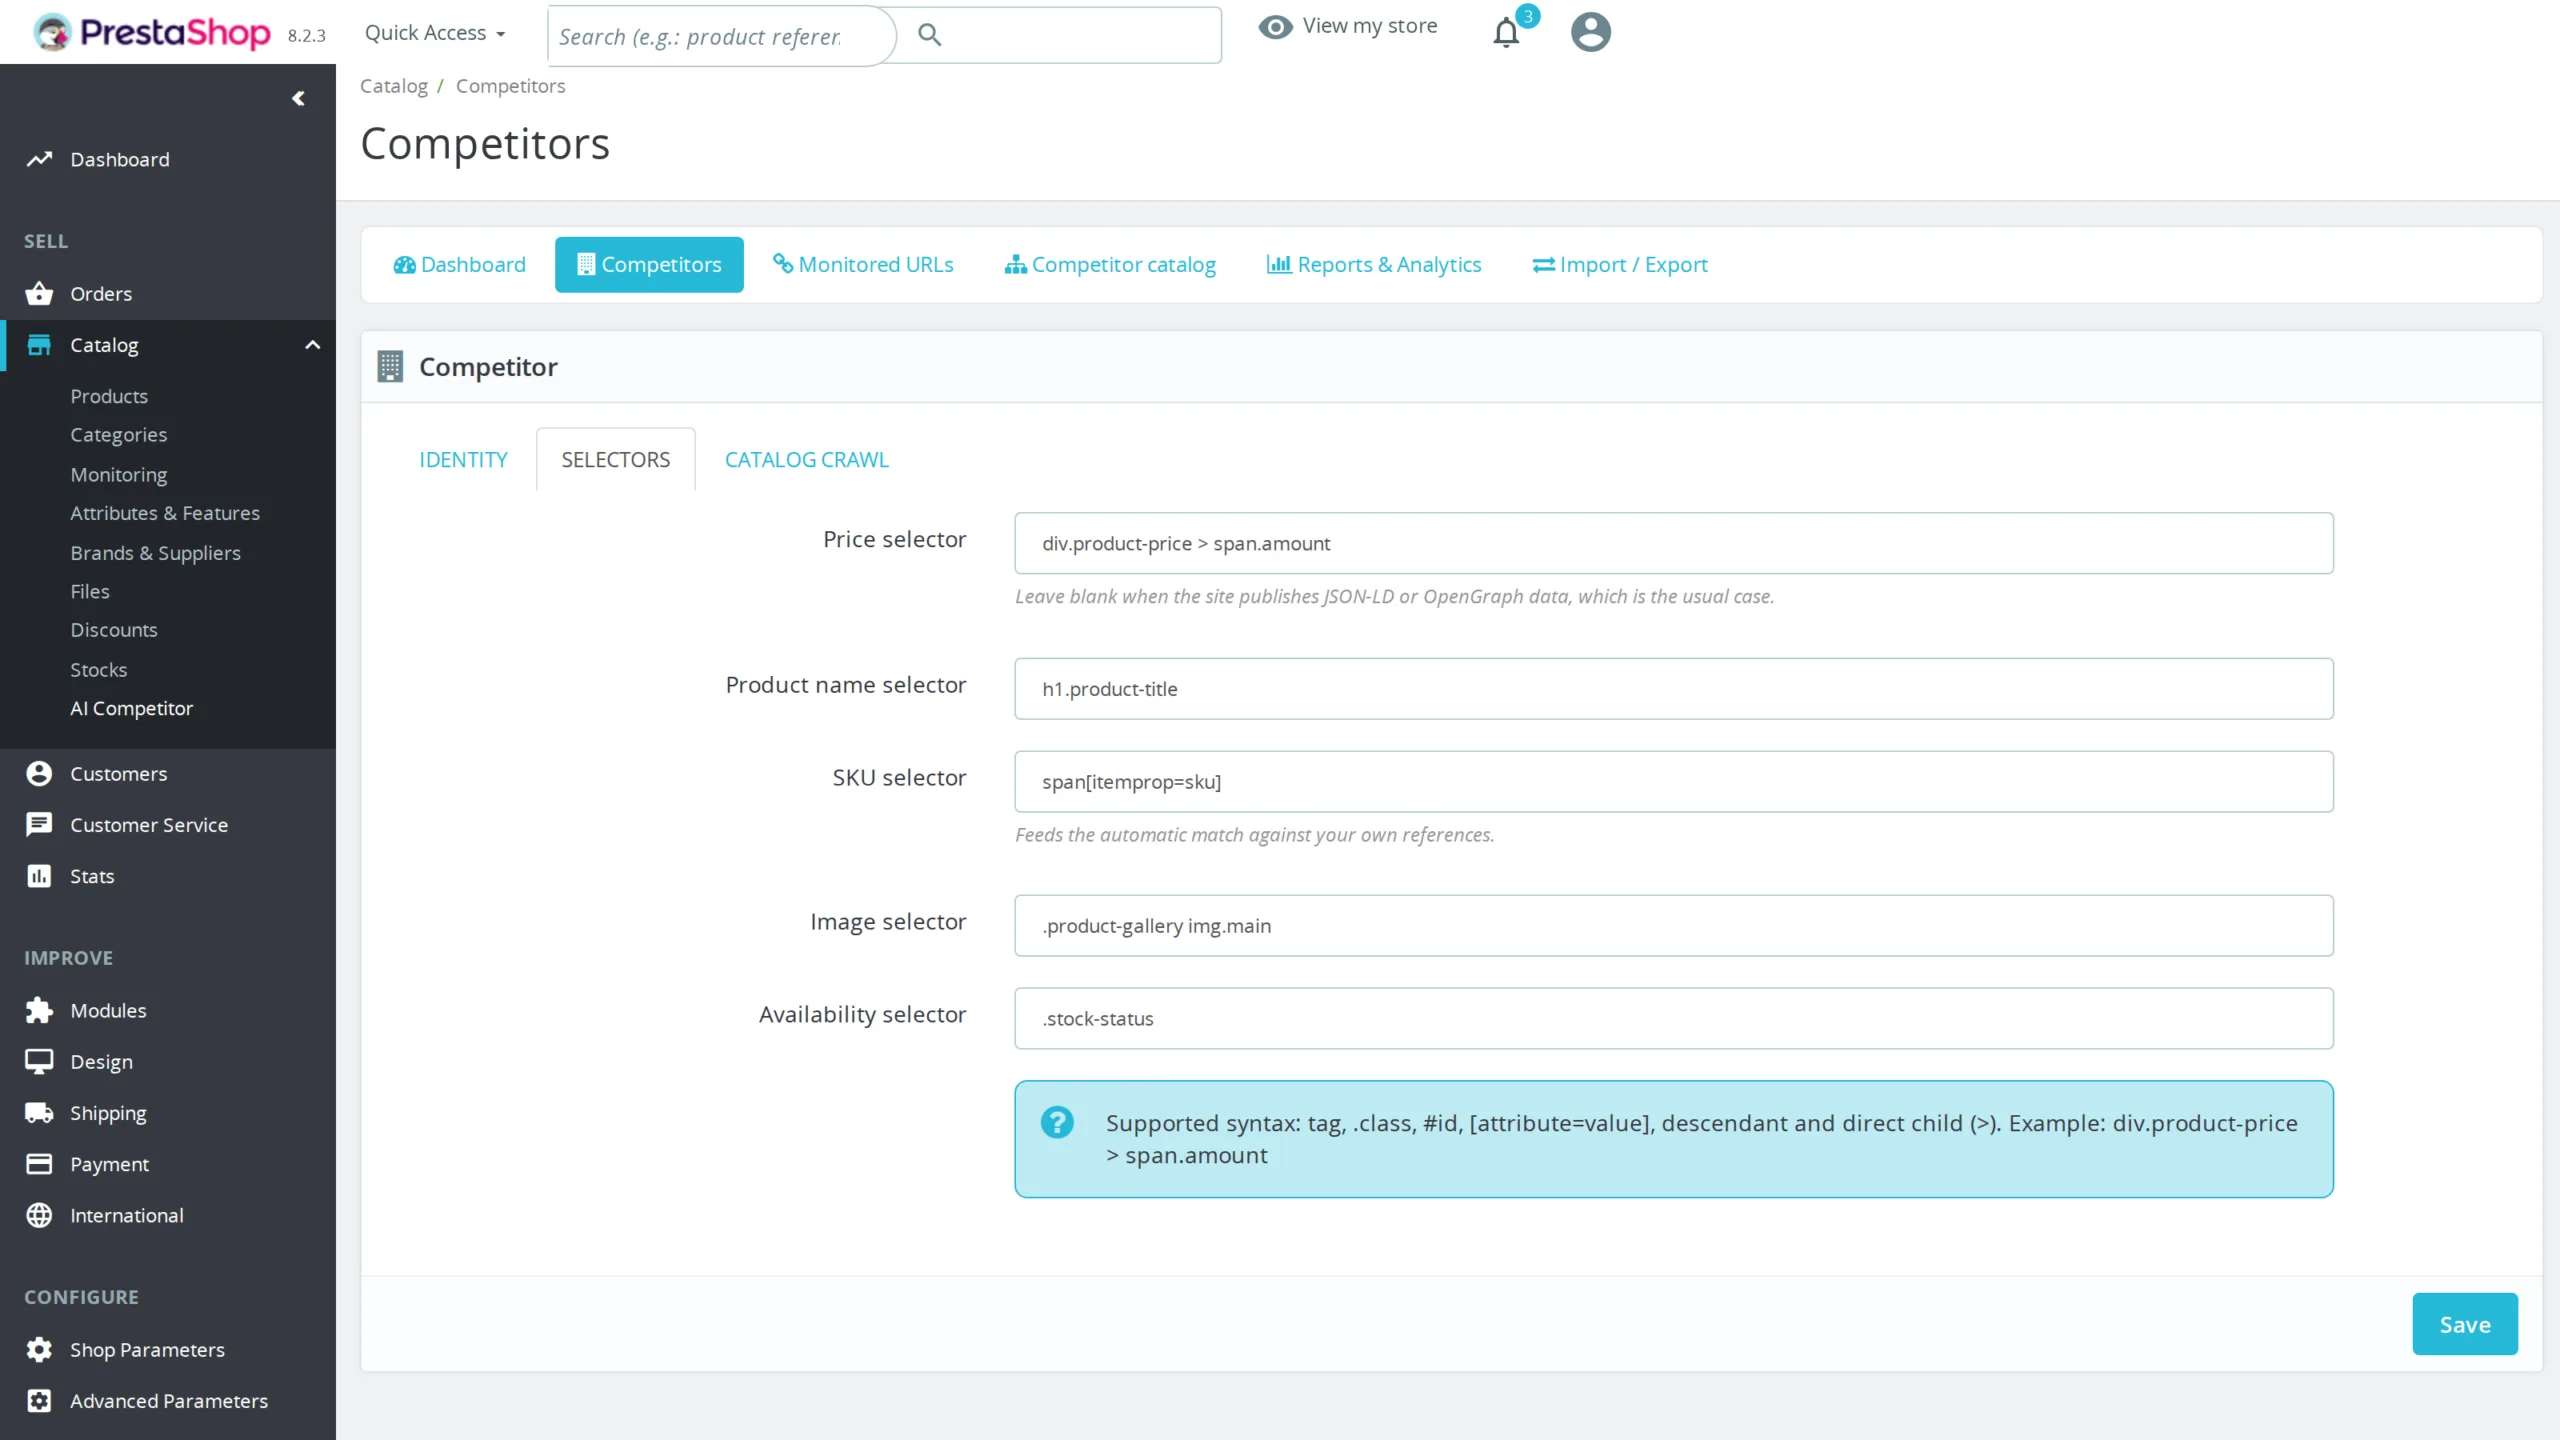
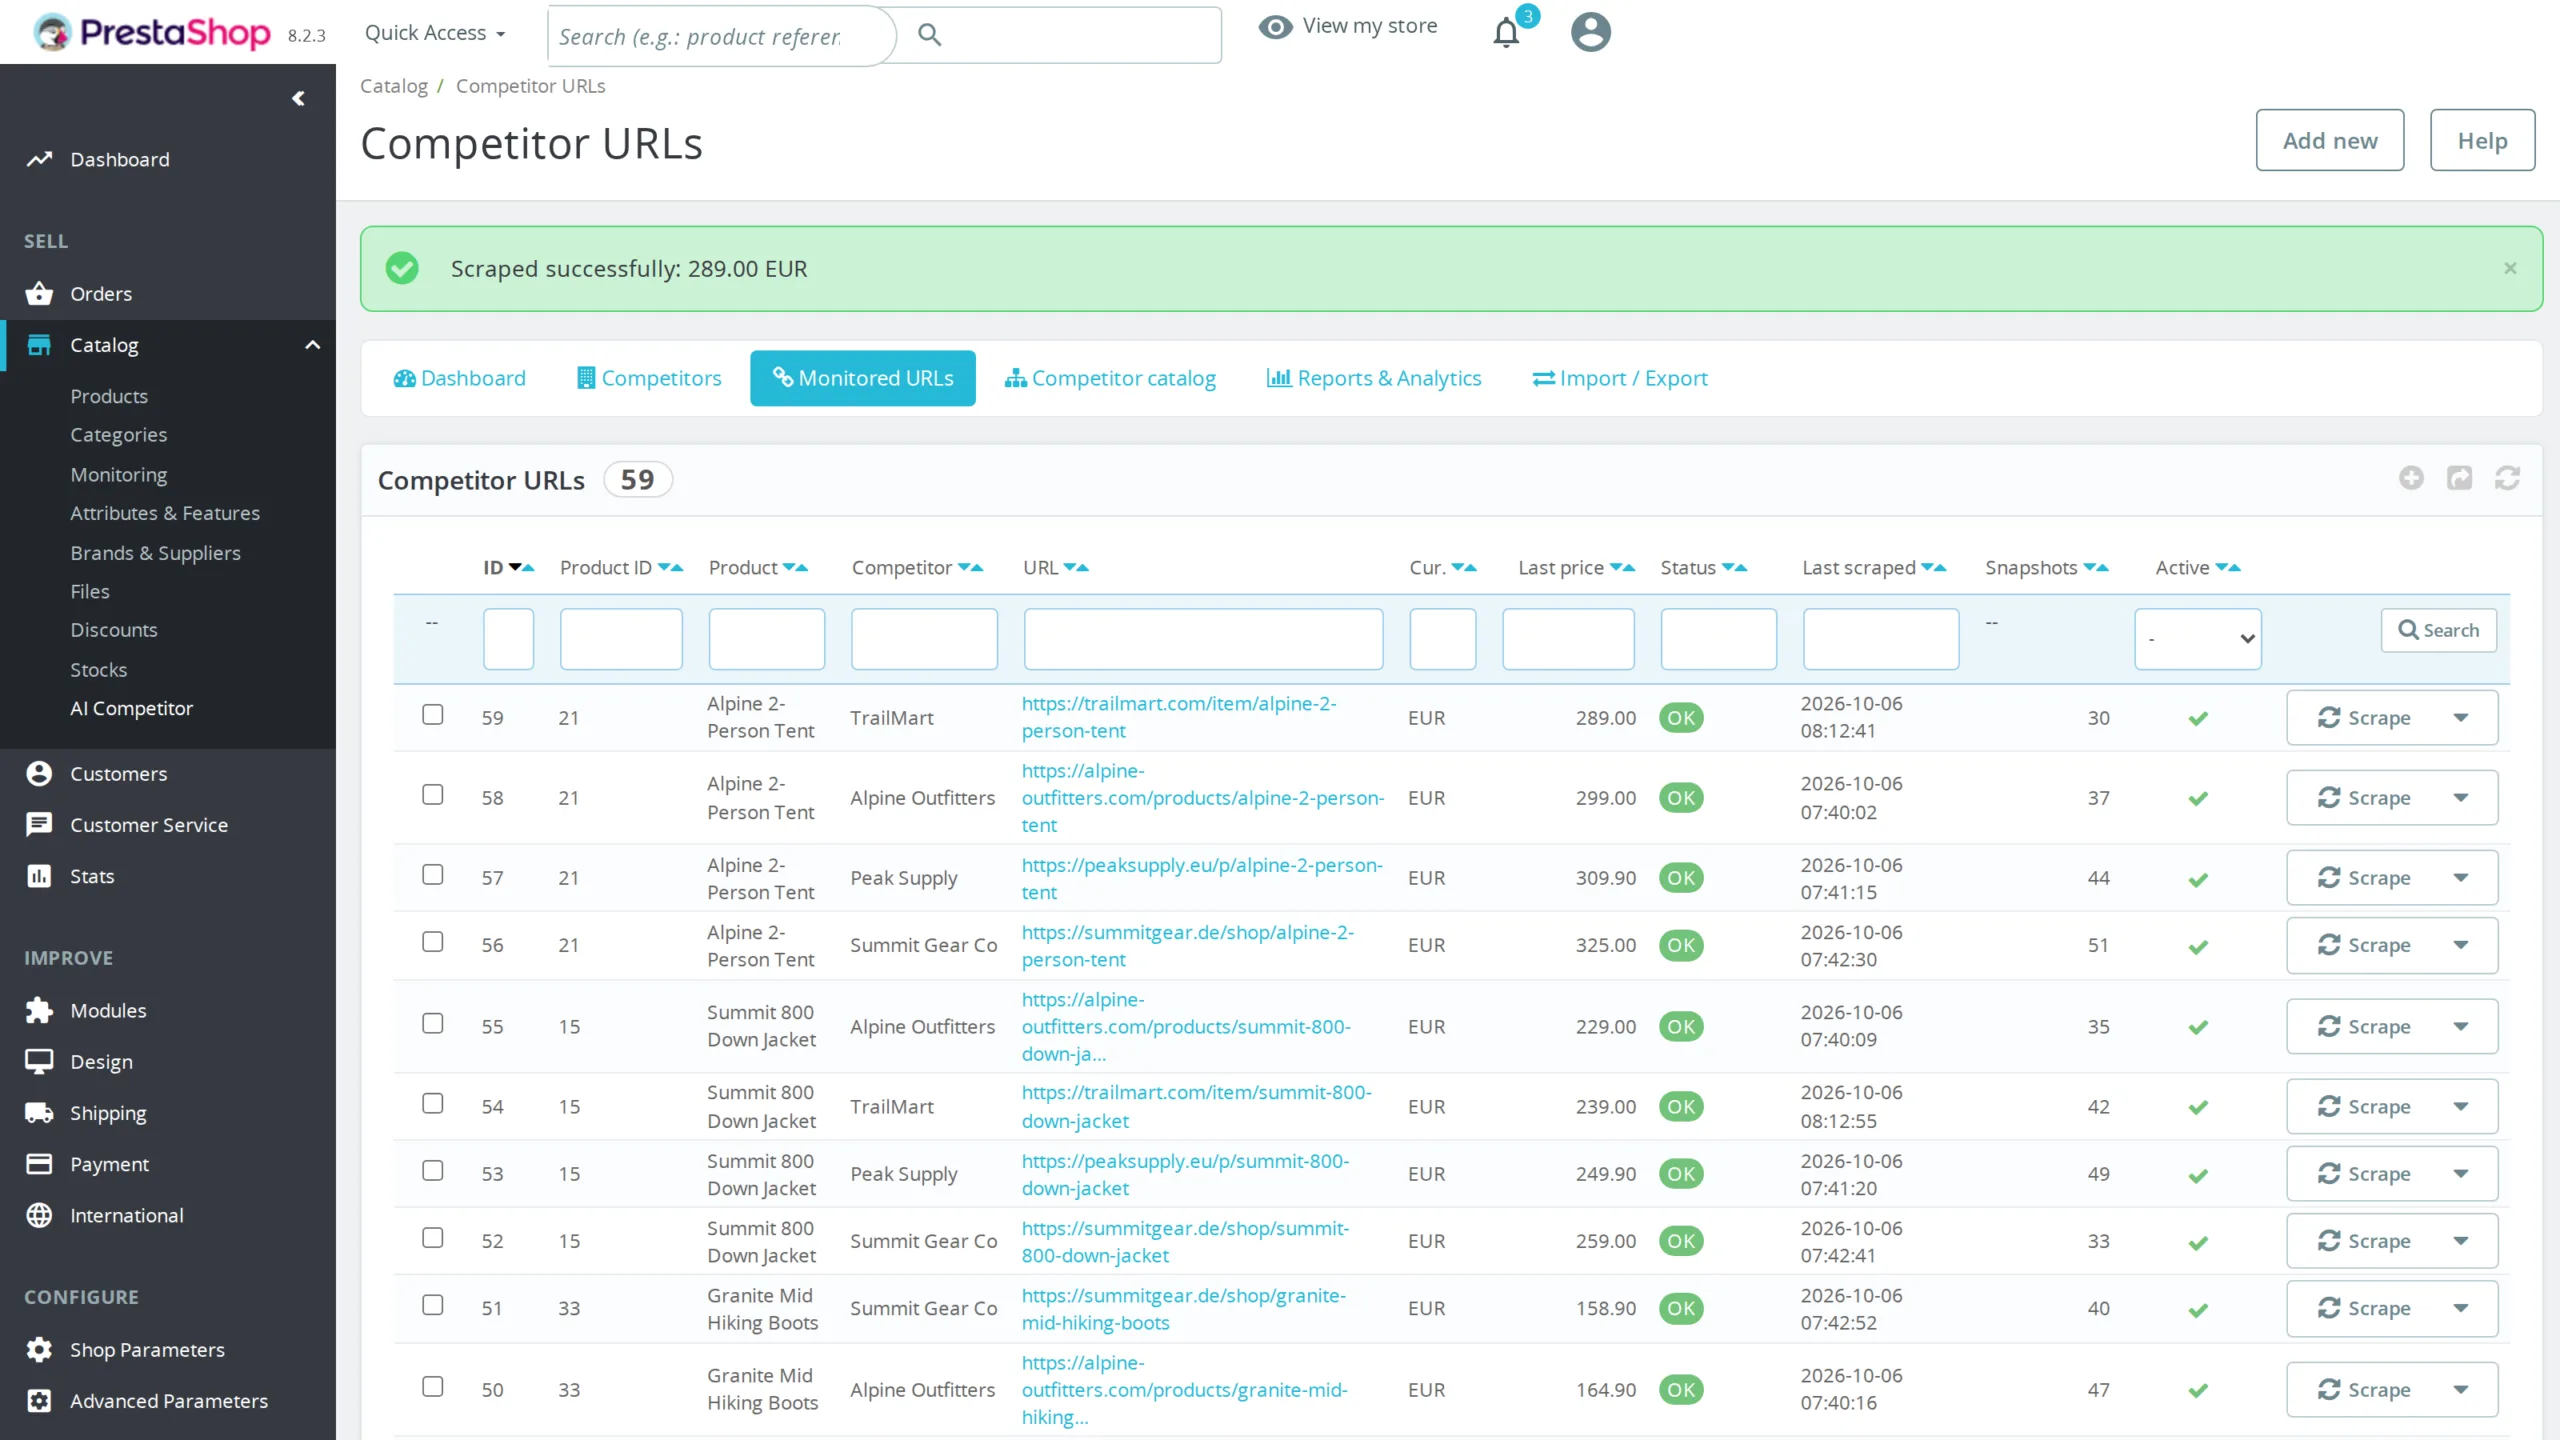
Le nom du concurrent et ses sélecteurs CSS ne se retapent plus à chaque URL. Un concurrent est une fiche : nom, domaine, sélecteur de prix, de titre, de SKU, d'image, de disponibilité, devise, intervalle de relevé, réglages de crawl. Toute URL qui lui est rattachée en hérite, et le rattachement se fait automatiquement en comparant le domaine de l'adresse saisie. Le jour où un concurrent refond son site et casse un sélecteur, vous le corrigez sur la fiche du concurrent et la correction se propage à toutes ses URLs.
§ 05
Emporter votre configuration d'une boutique à l'autre
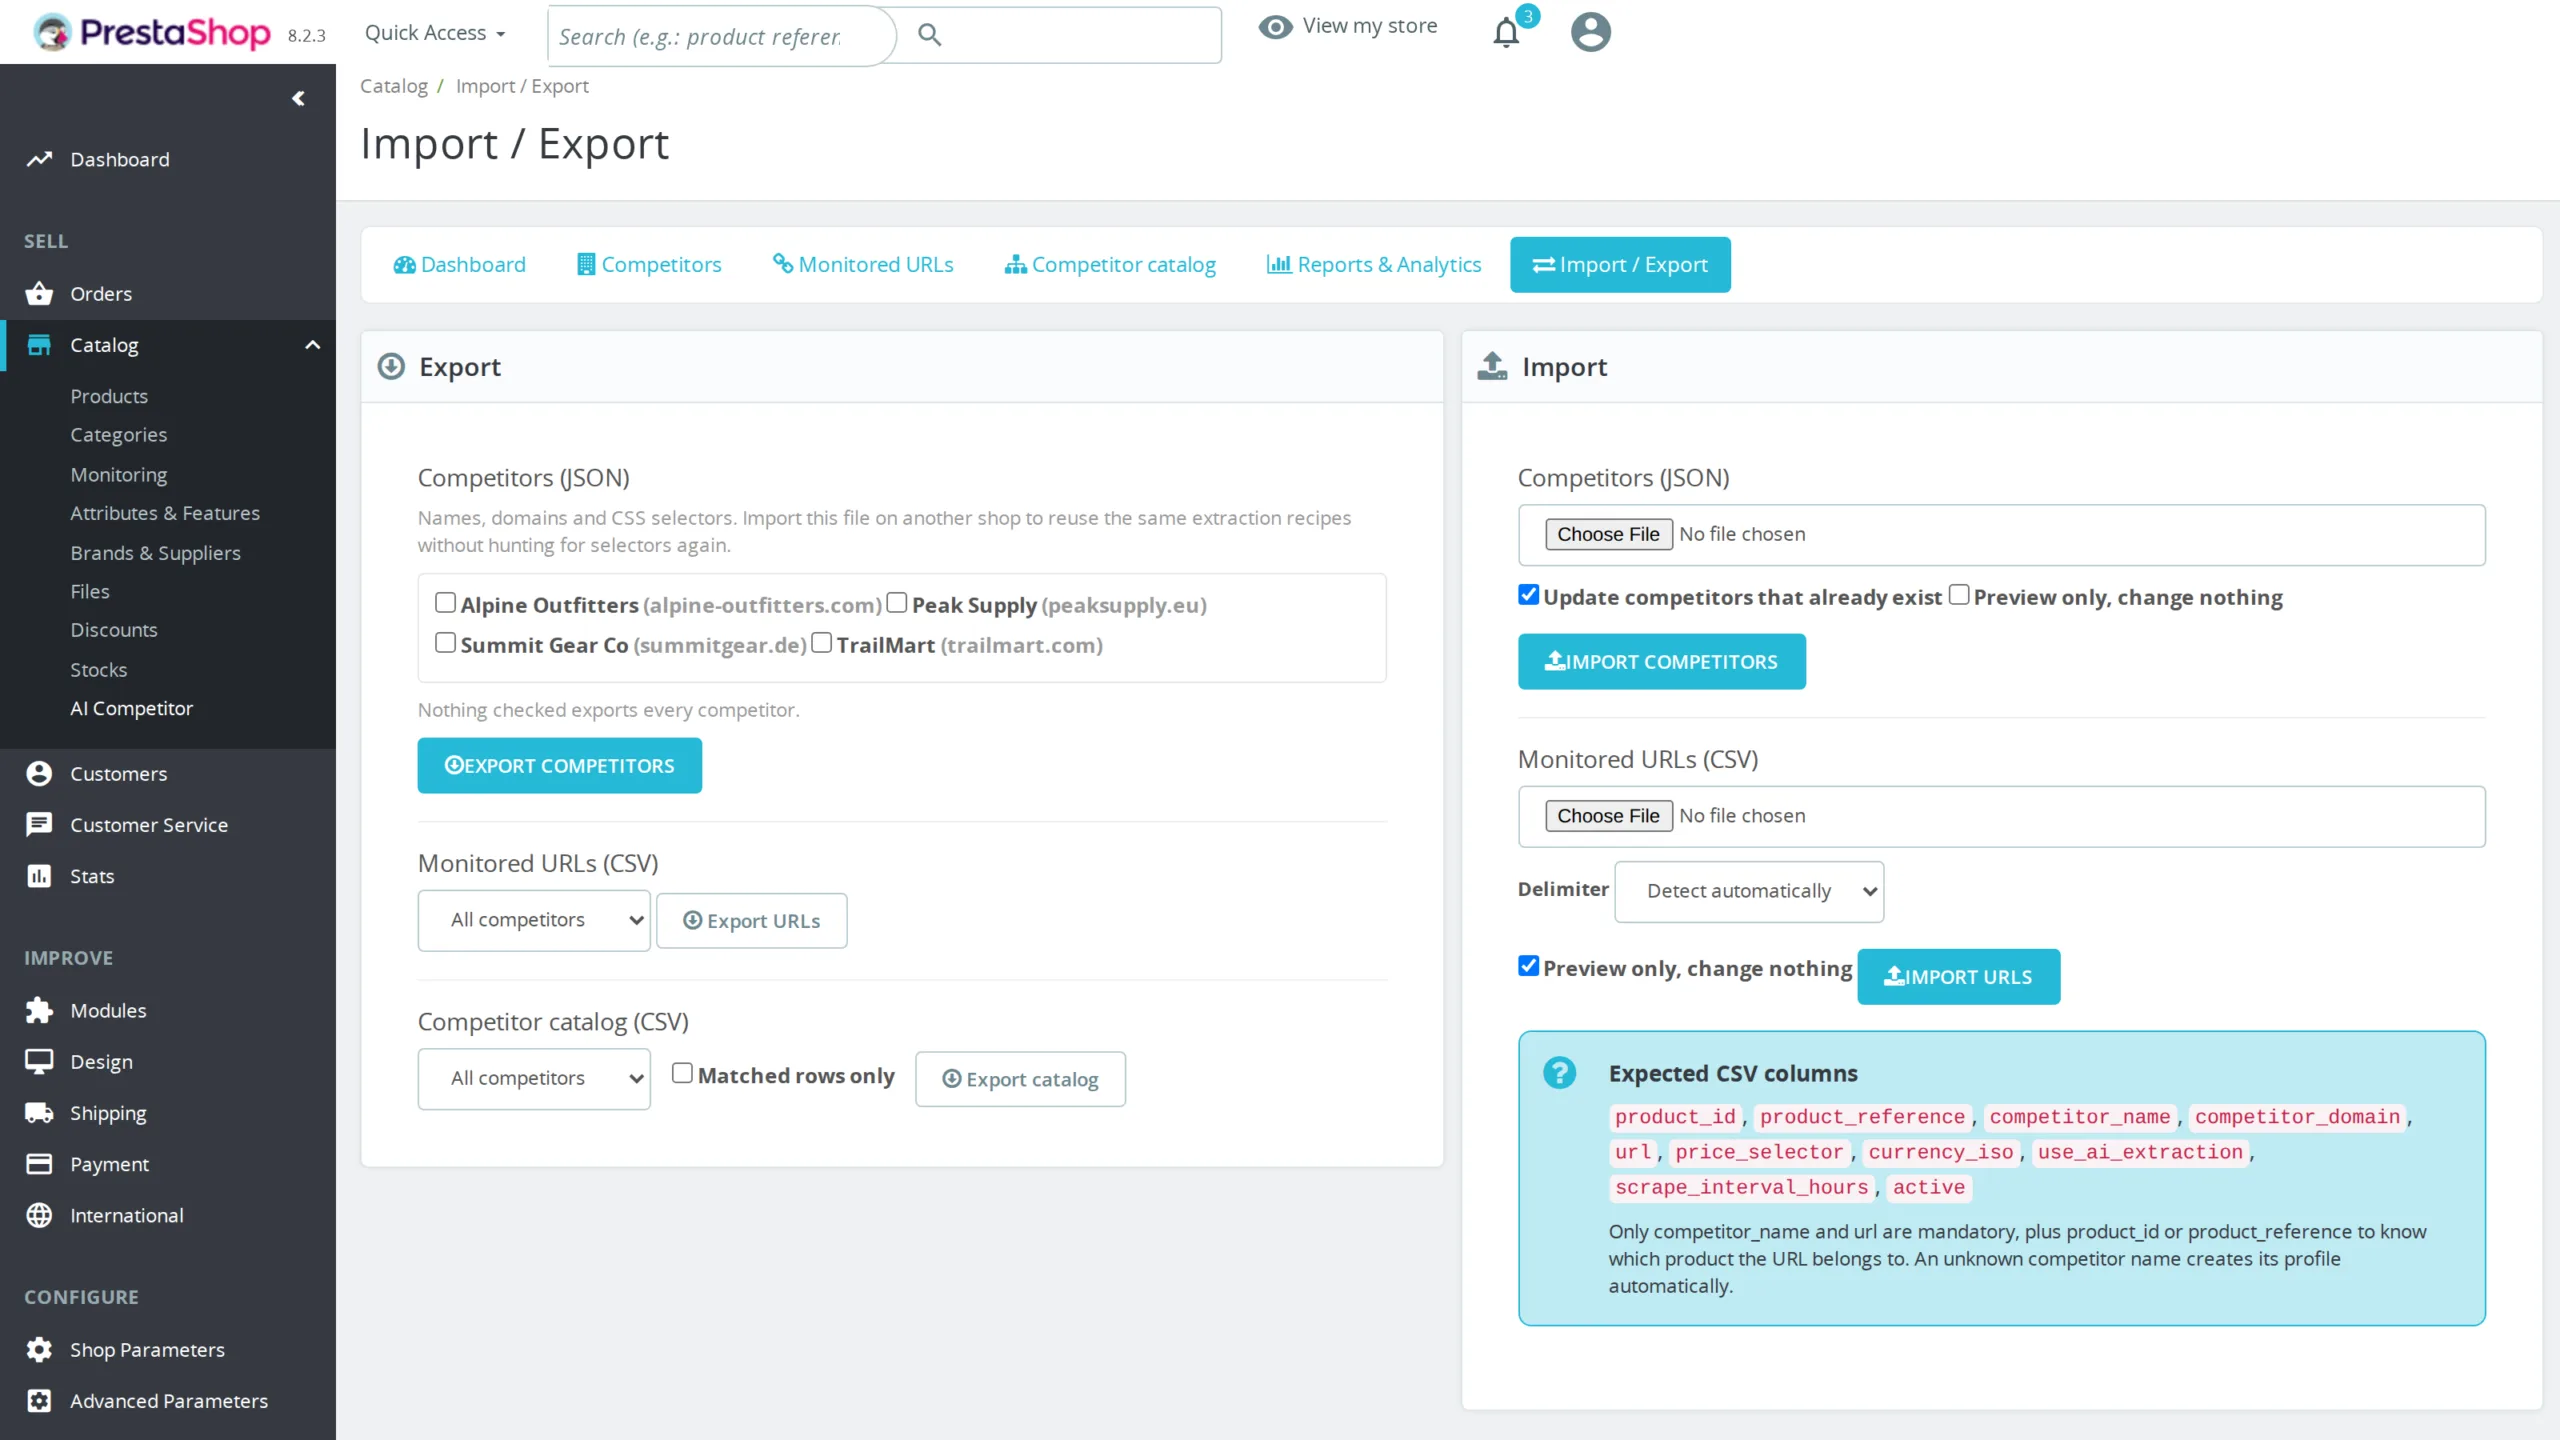
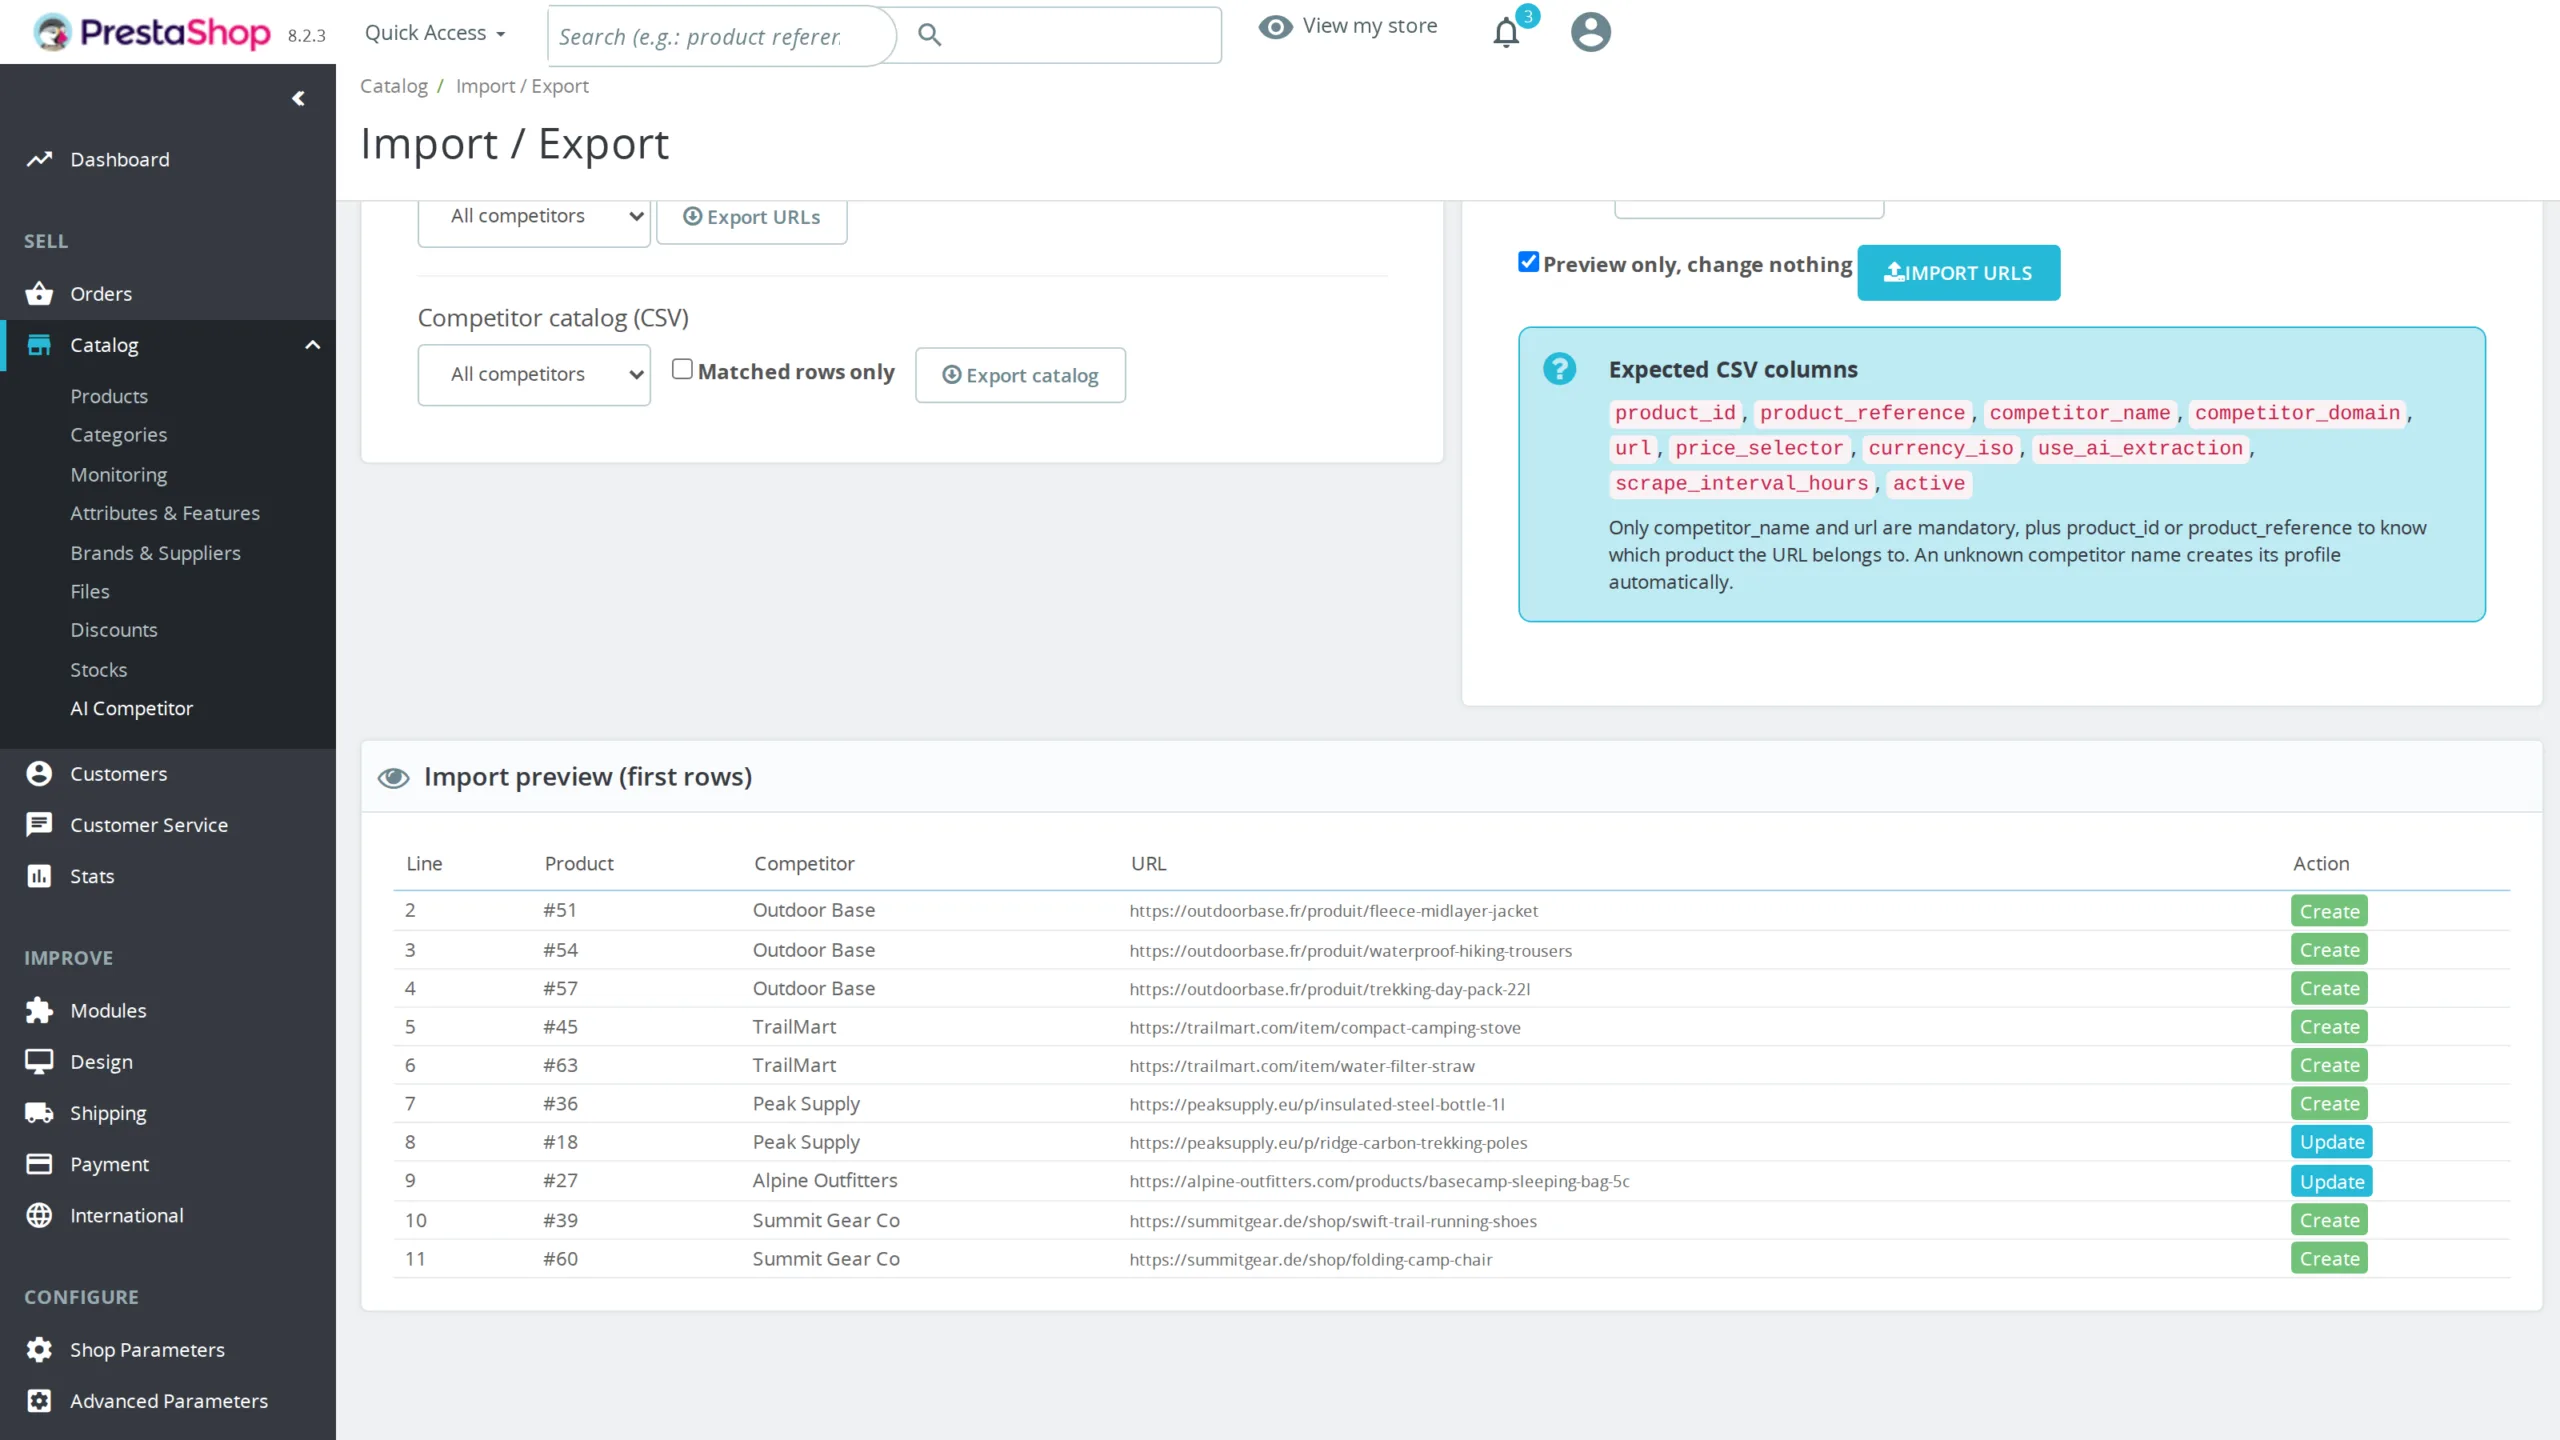
La bibliothèque de concurrents s'exporte dans un fichier JSON et se réimporte ailleurs. Les recettes d'extraction que vous avez mises au point sur une boutique servent immédiatement sur la suivante, au lieu d'être redécouvertes sélecteur par sélecteur. Les URLs surveillées s'échangent en CSV : le produit est retrouvé par identifiant ou par référence, et un nom de concurrent inconnu crée sa fiche à la volée, de sorte qu'un seul fichier suffit à amorcer une installation entière. Le séparateur est détecté automatiquement, et l'import démarre en mode prévisualisation qui rapporte ligne par ligne ce qui serait créé, mis à jour ou ignoré avant la moindre écriture.
§ 06
Une extraction de prix qui ne casse jamais
Le module essaie en cascade plusieurs méthodes d'extraction pour chaque URL. D'abord les données structurées JSON-LD Product/Offer, présentes sur la majorité des sites modernes. Ensuite les balises OpenGraph product price amount. Ensuite votre sélecteur CSS si vous en avez fourni un. Et en dernier recours l'IA : un extrait HTML nettoyé est envoyé au provider de votre choix, qui renvoie le prix, la devise et l'état de stock au format JSON strict. Concrètement, même si un concurrent refond son site demain, votre veille continue de tourner.
§ 07
Des analytics qui répondent à la question utile
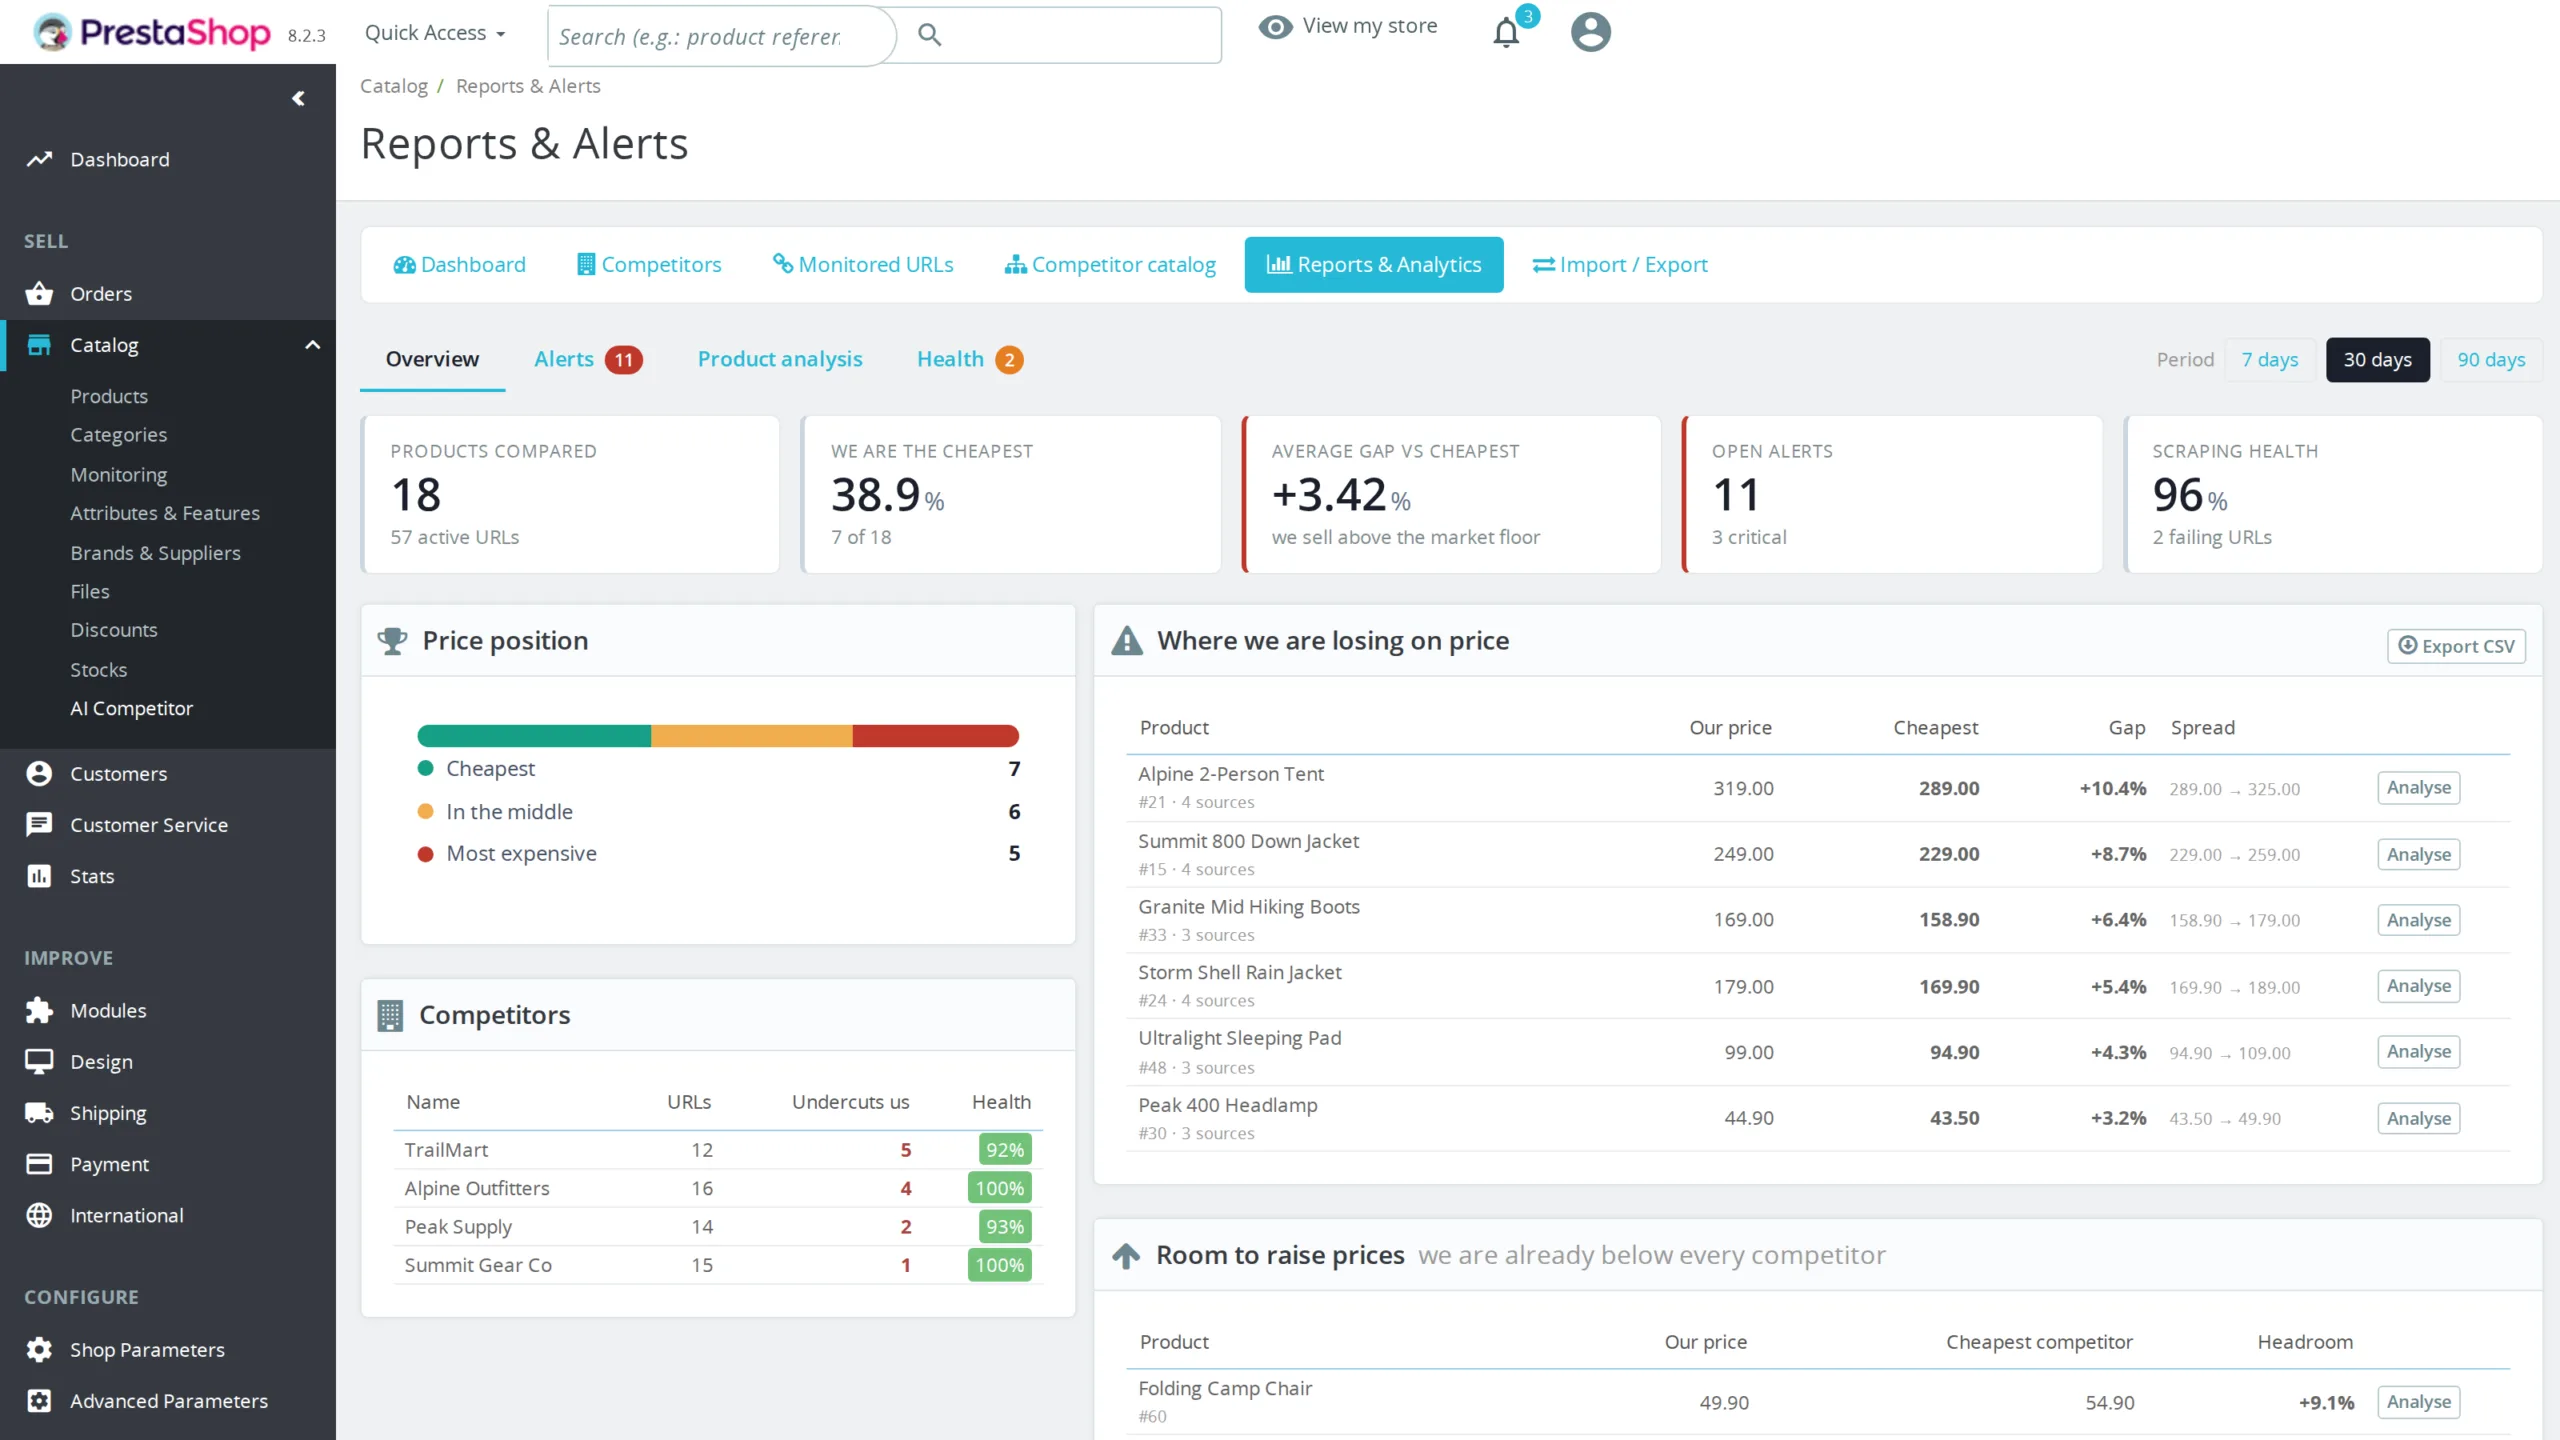
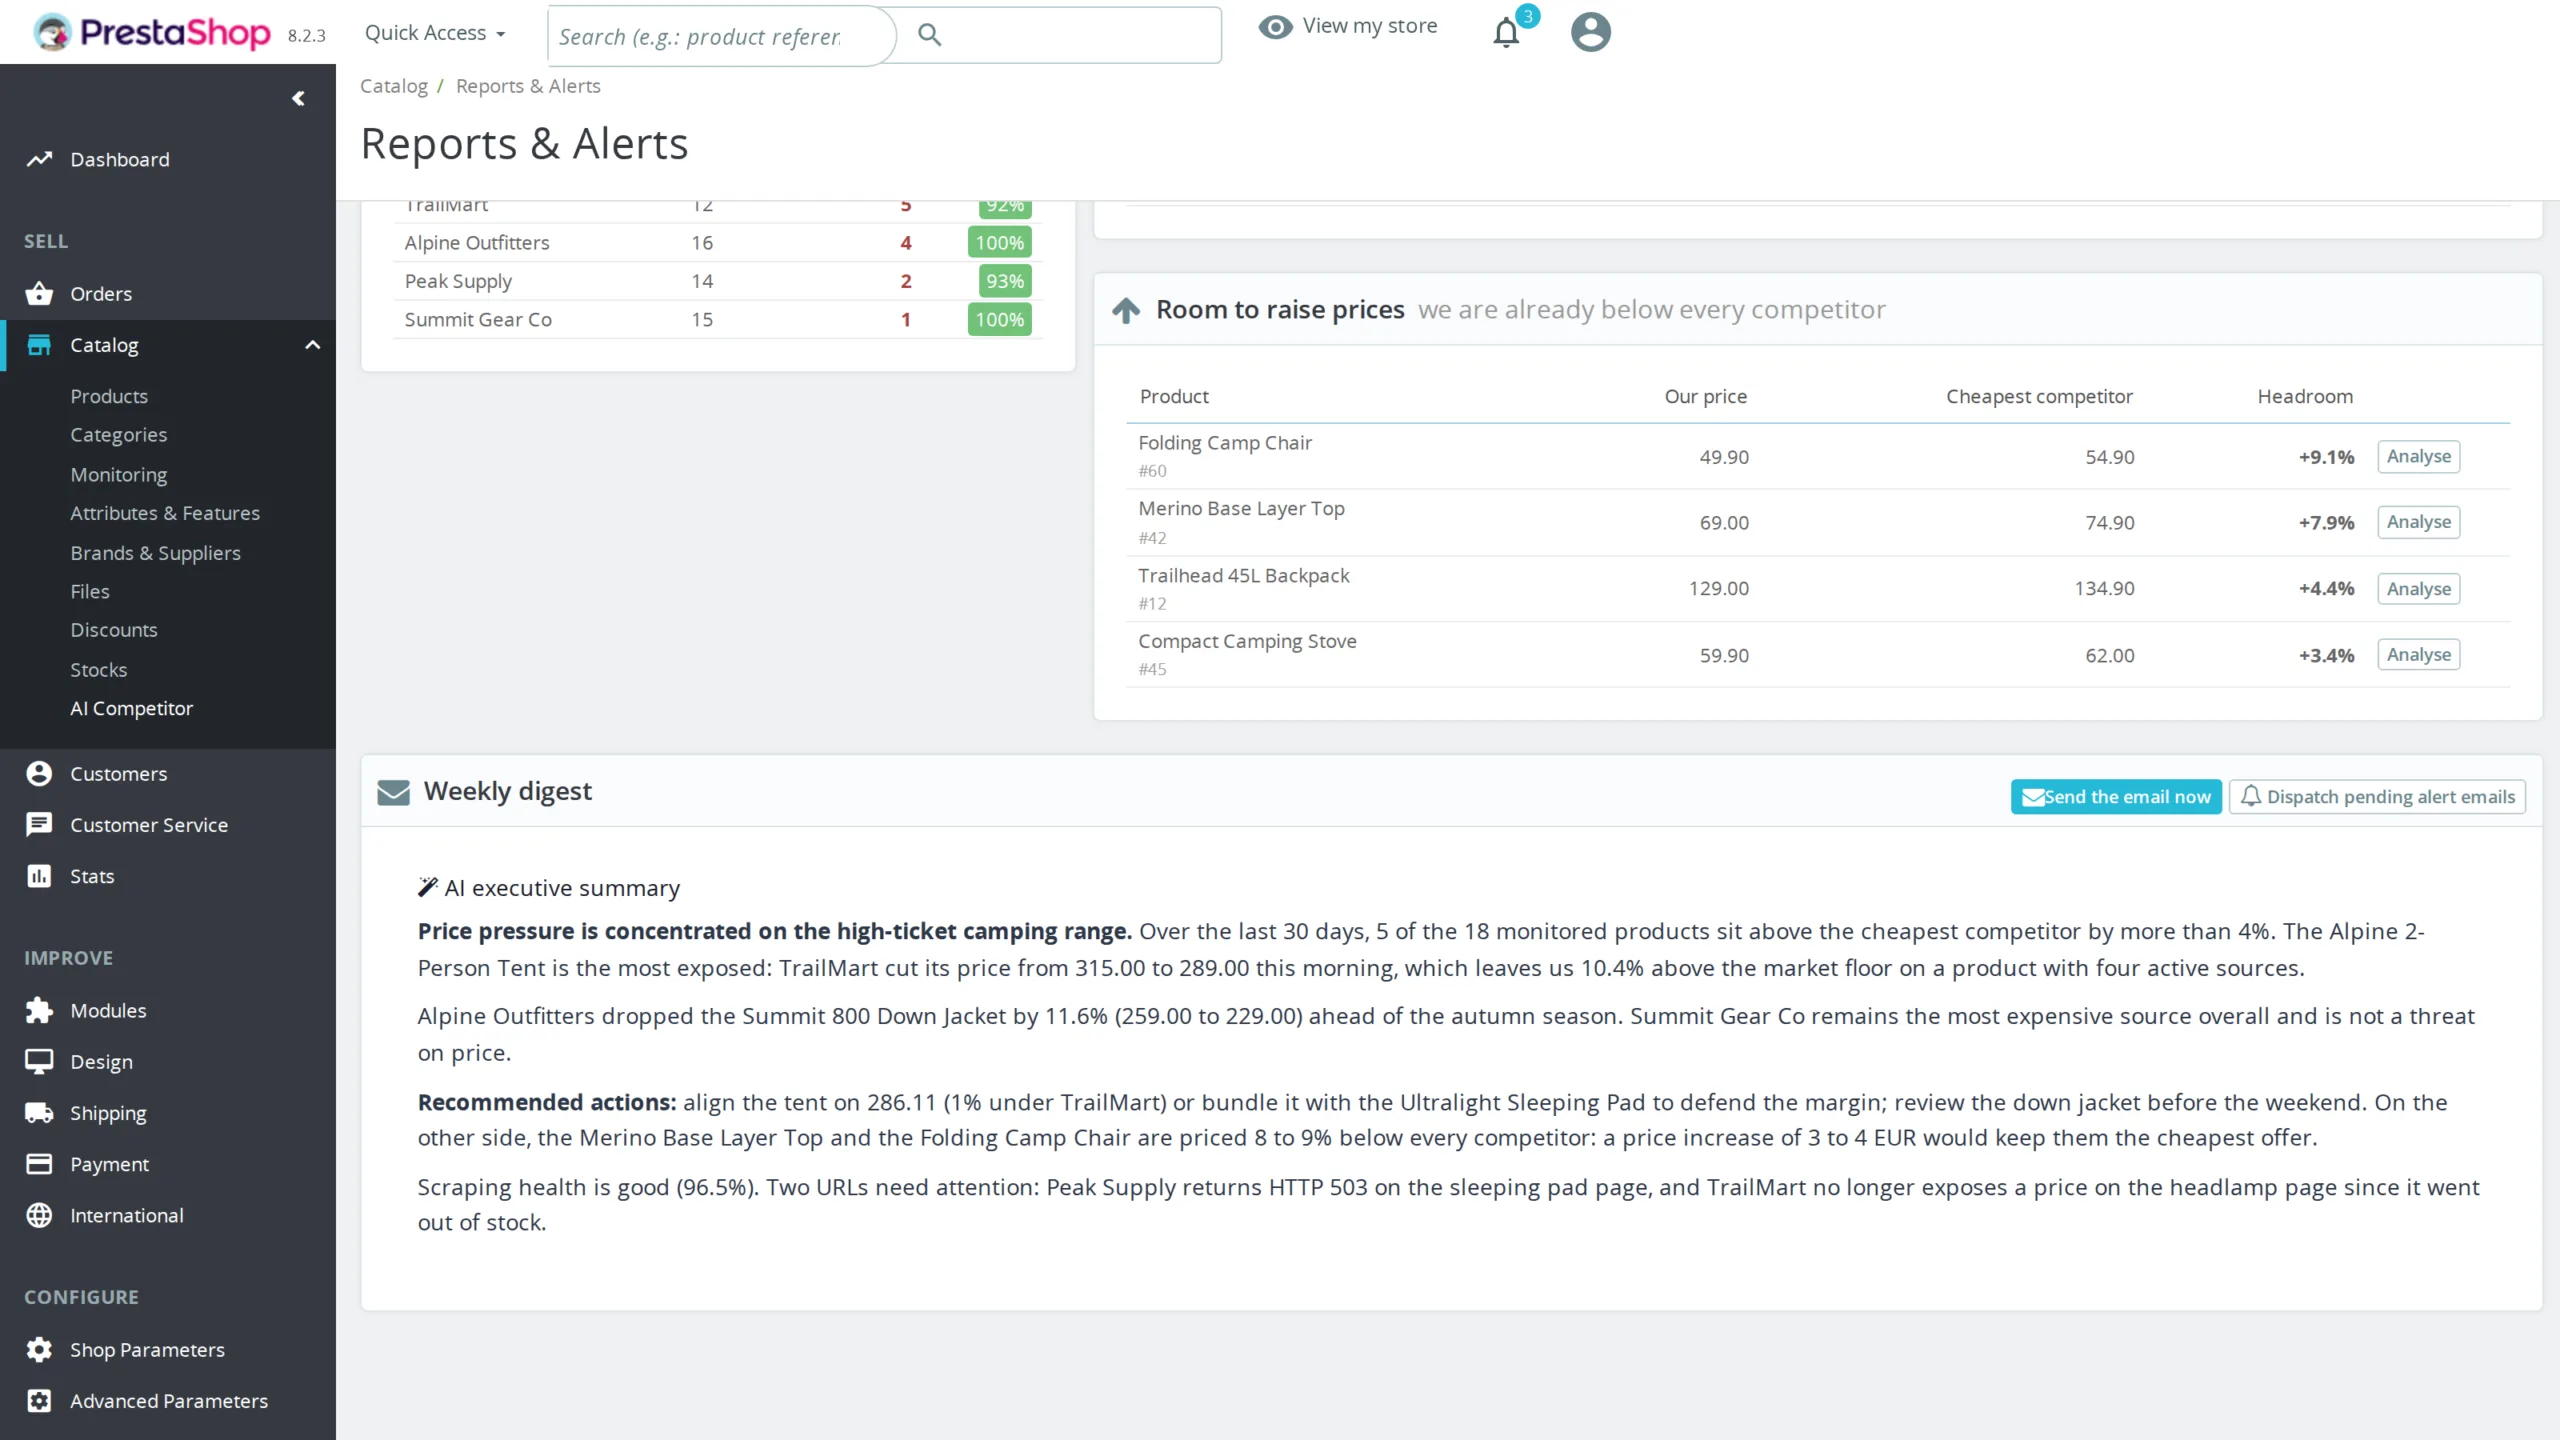
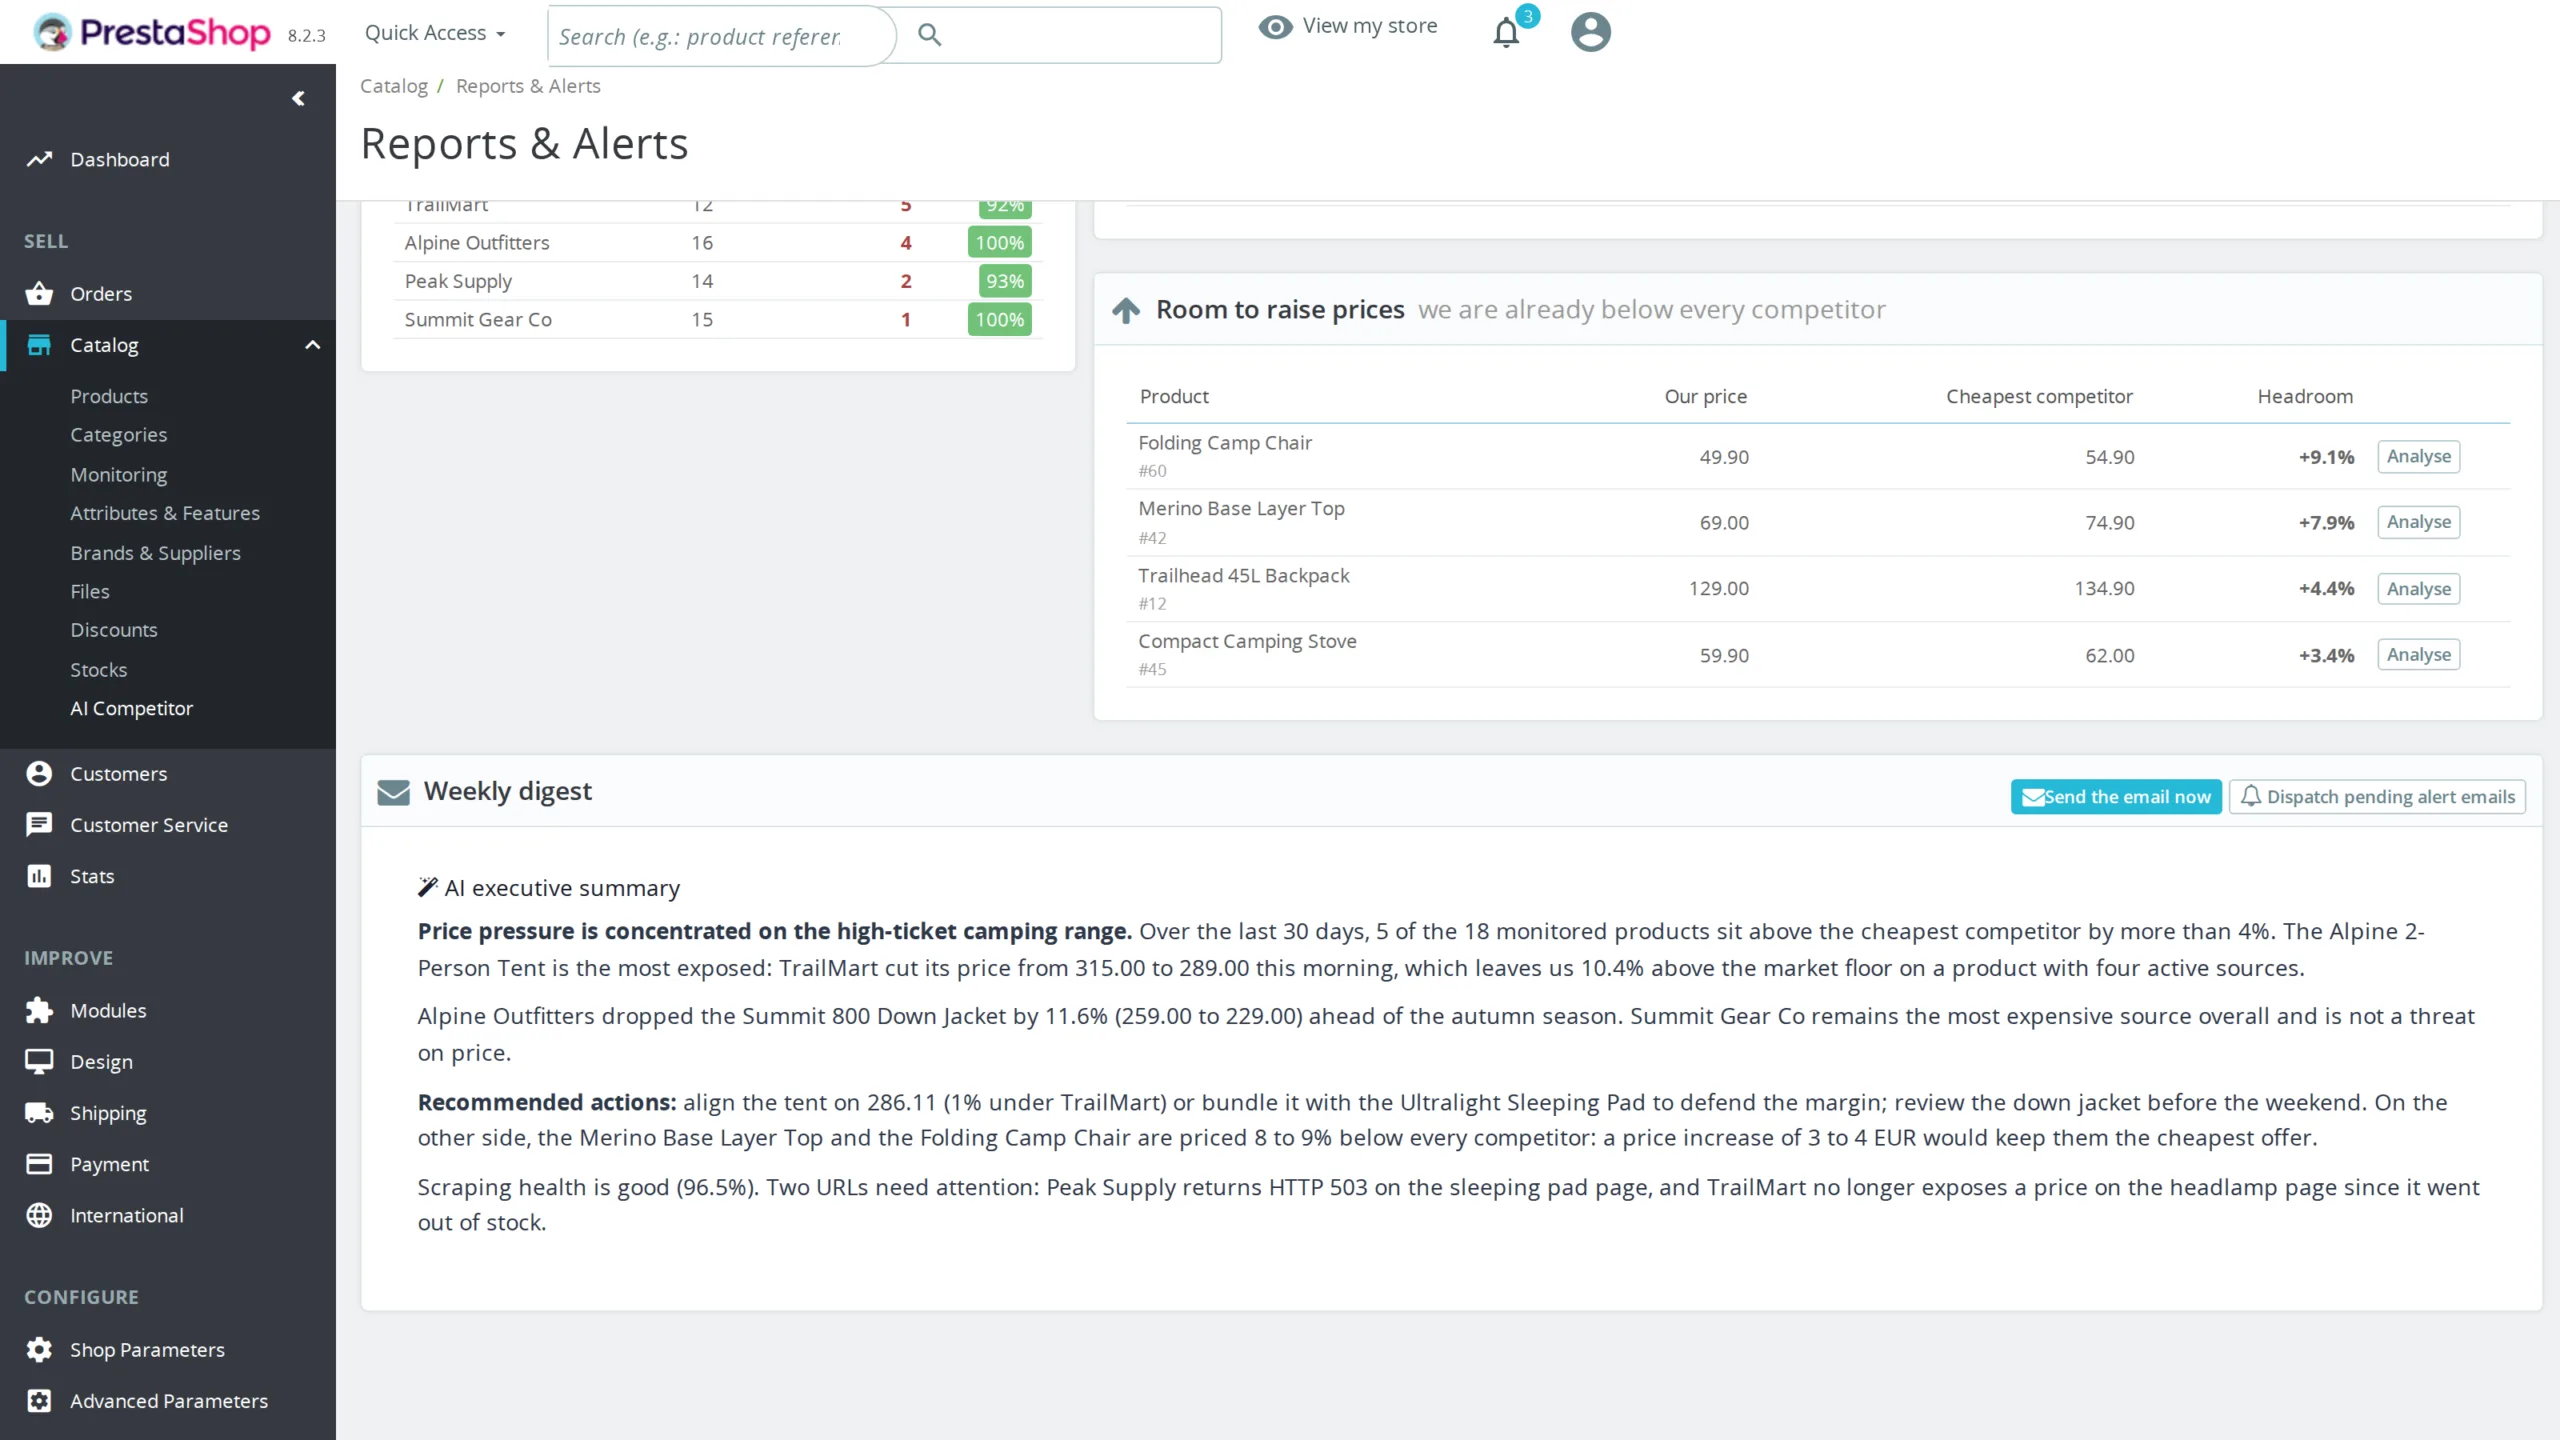
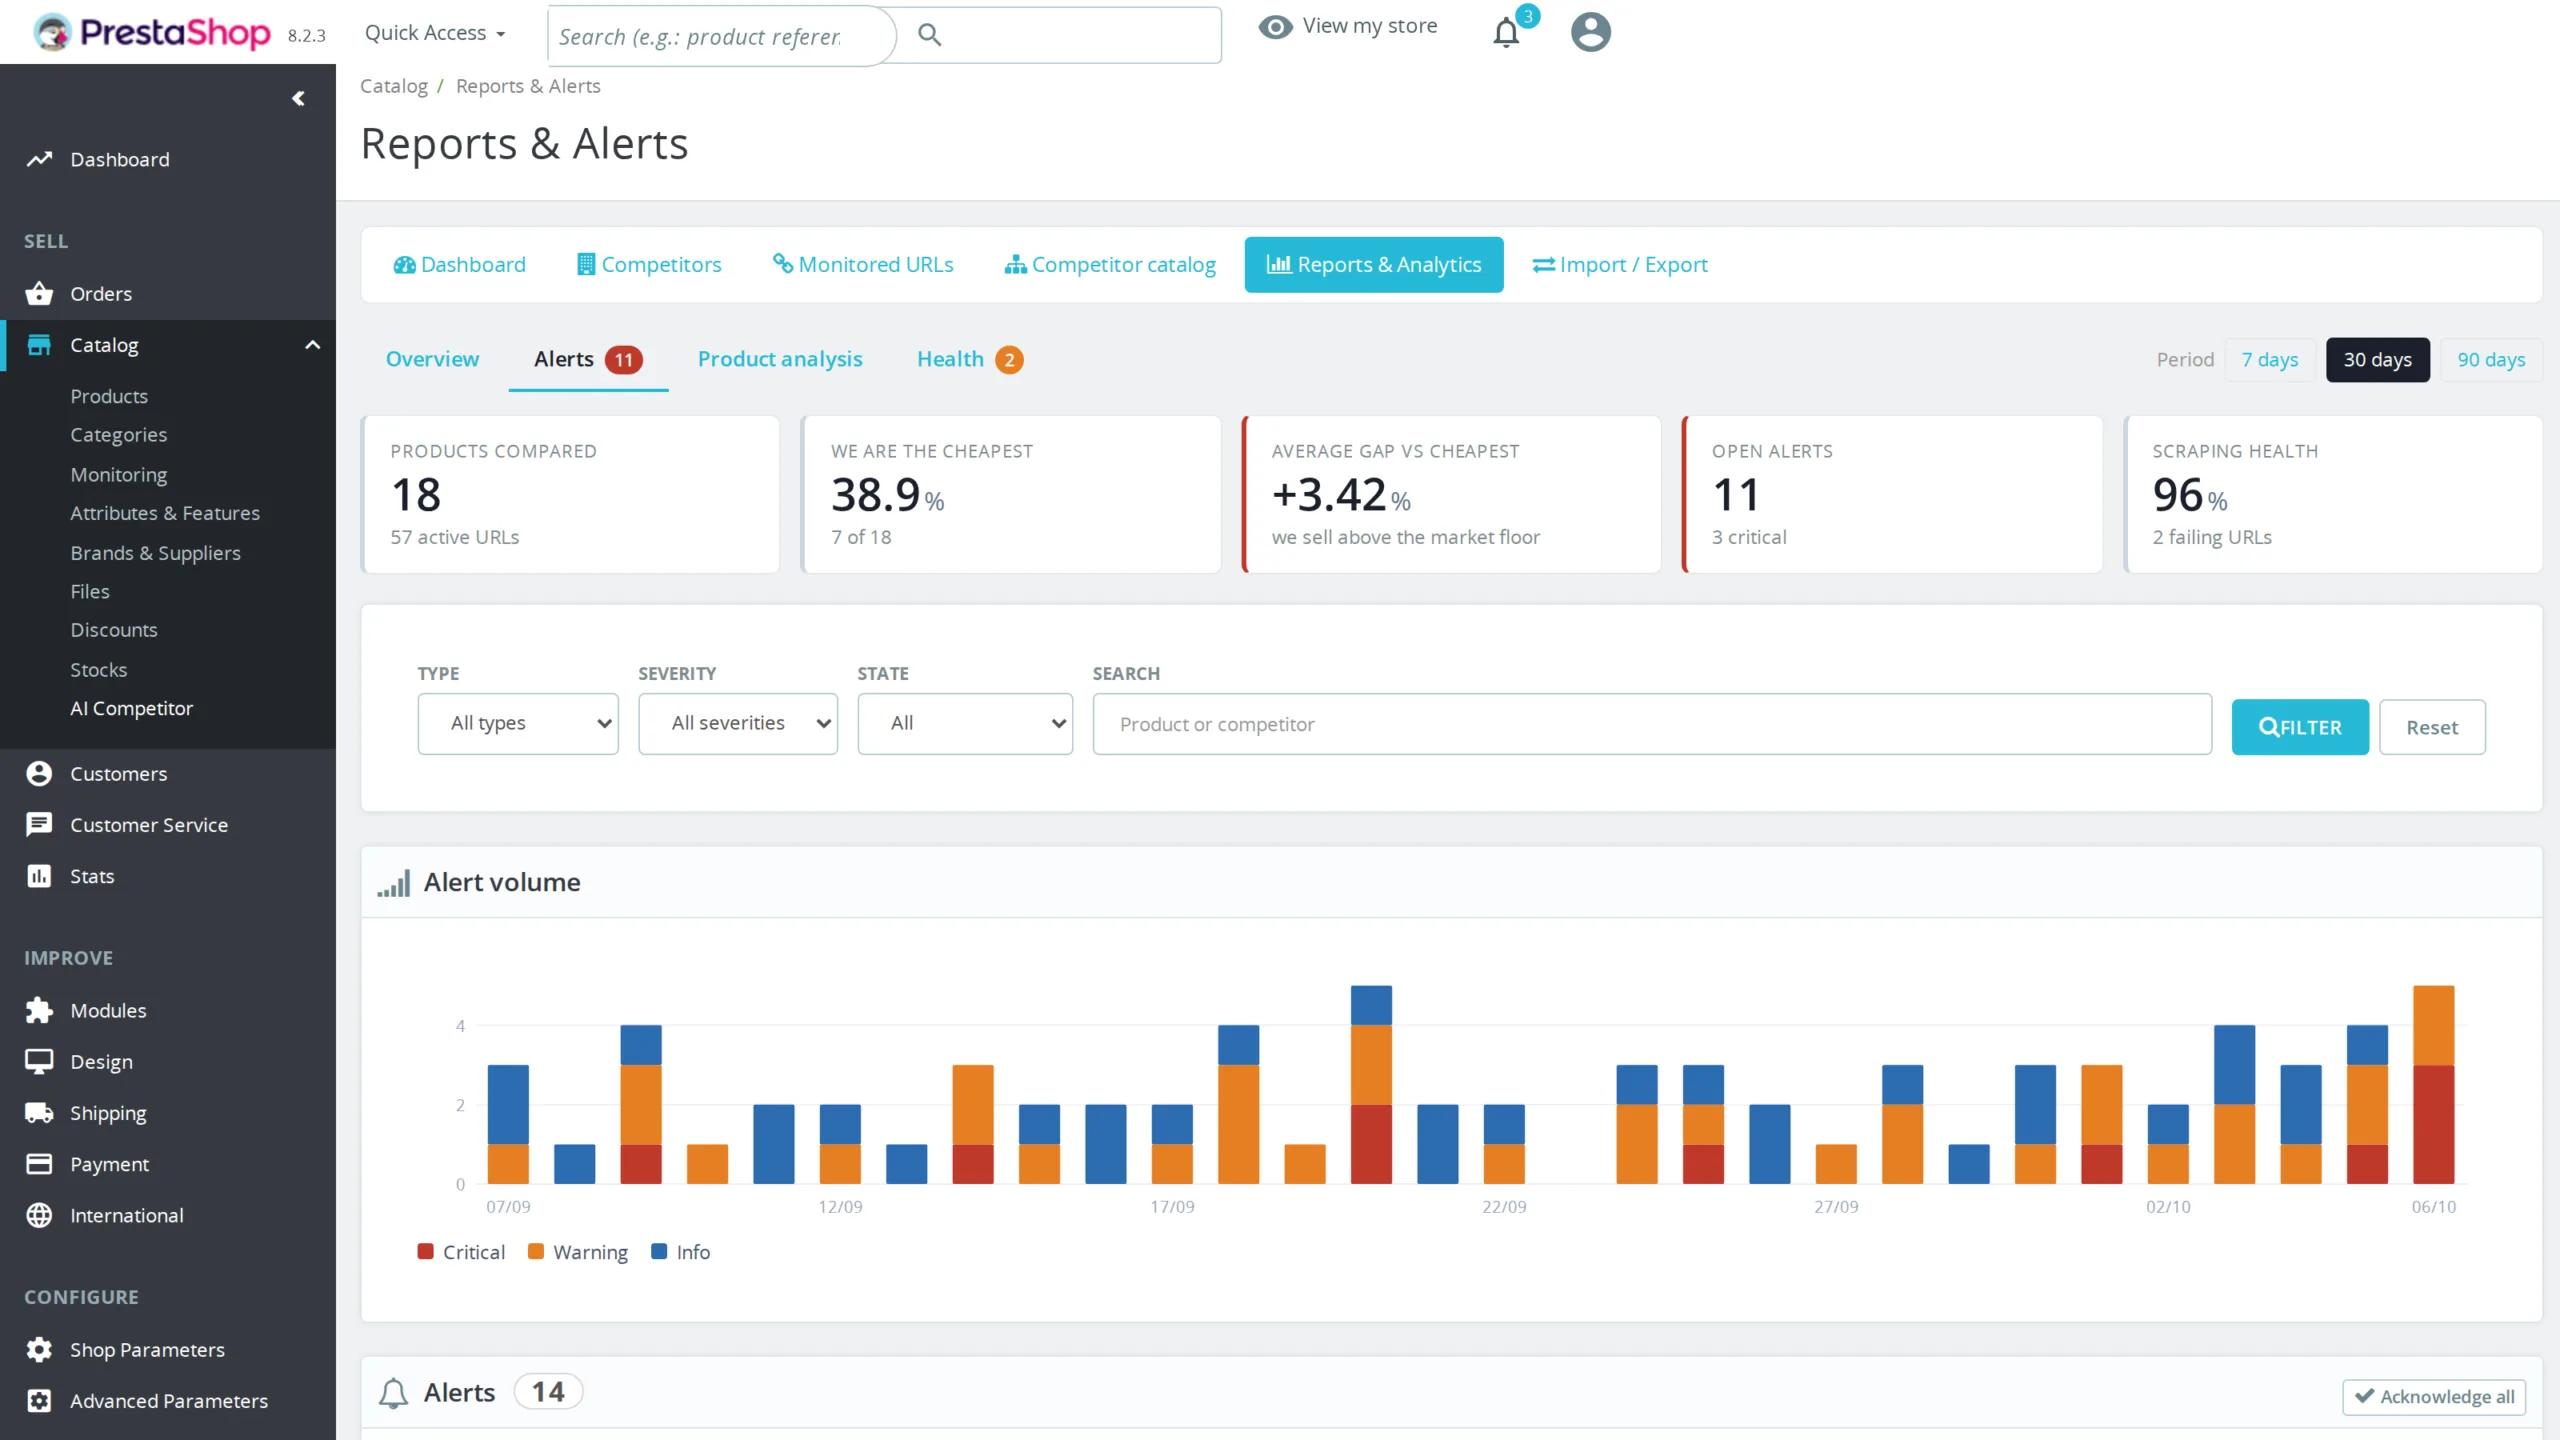
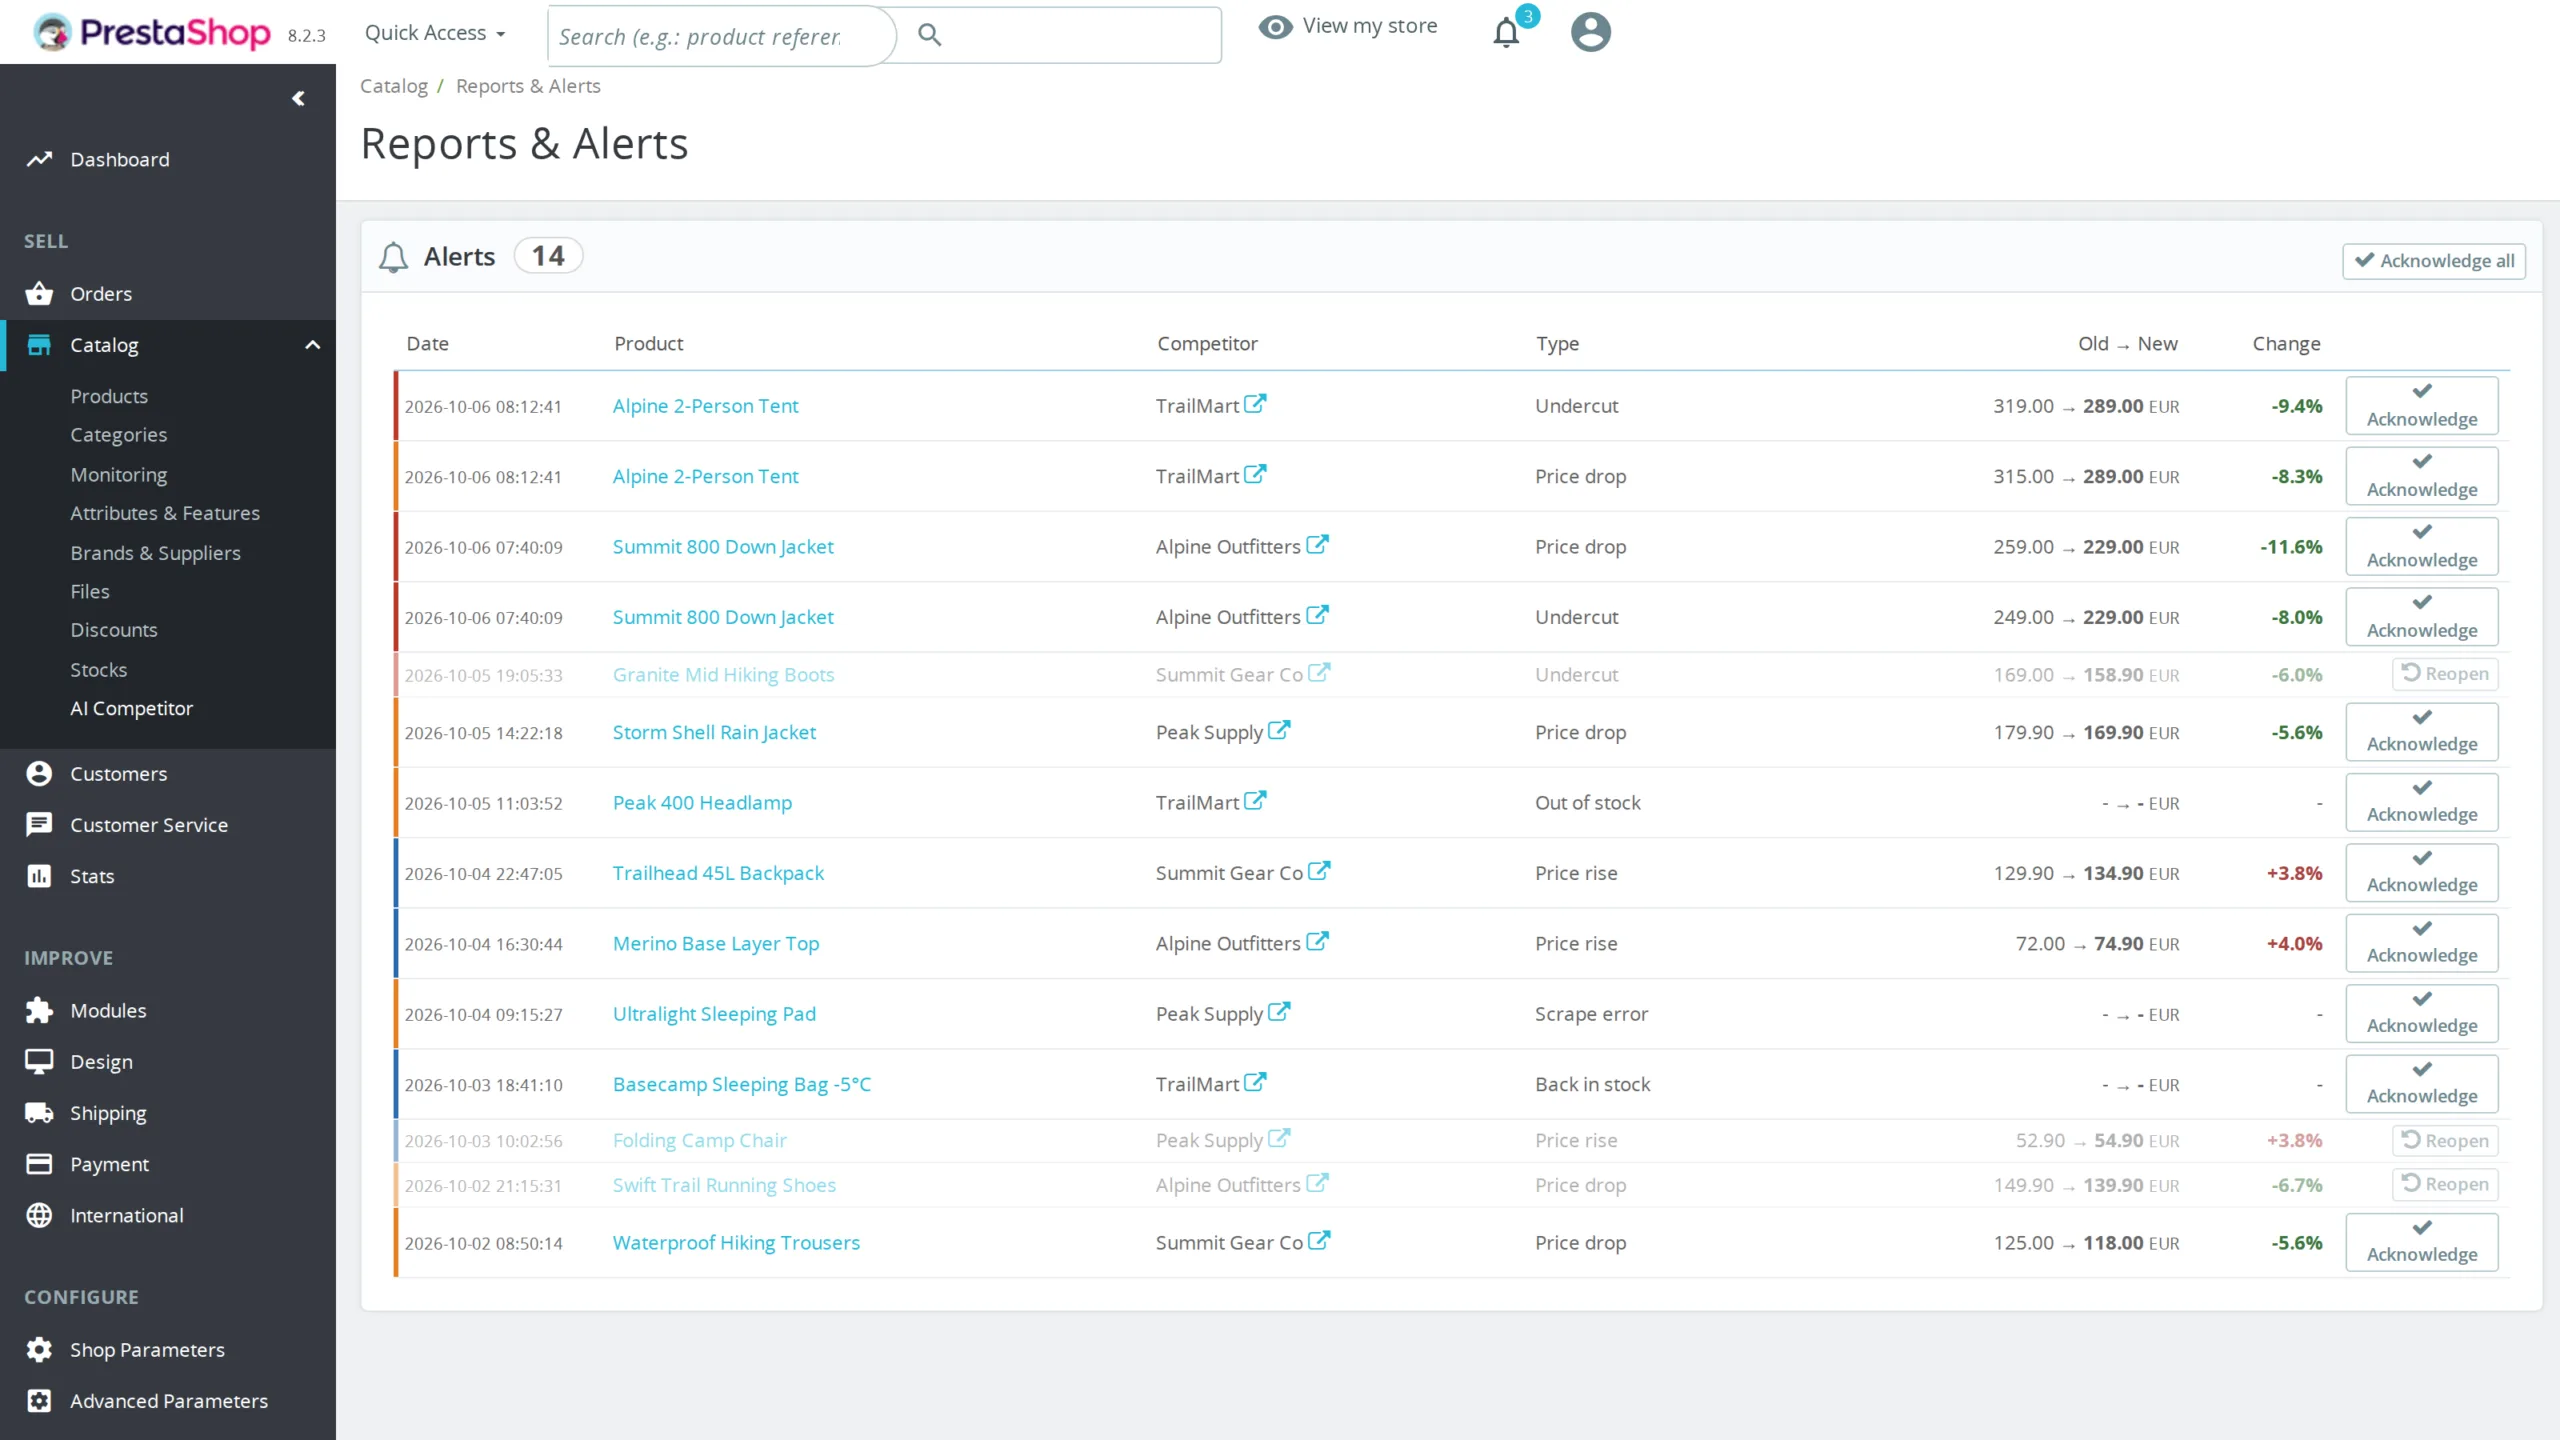
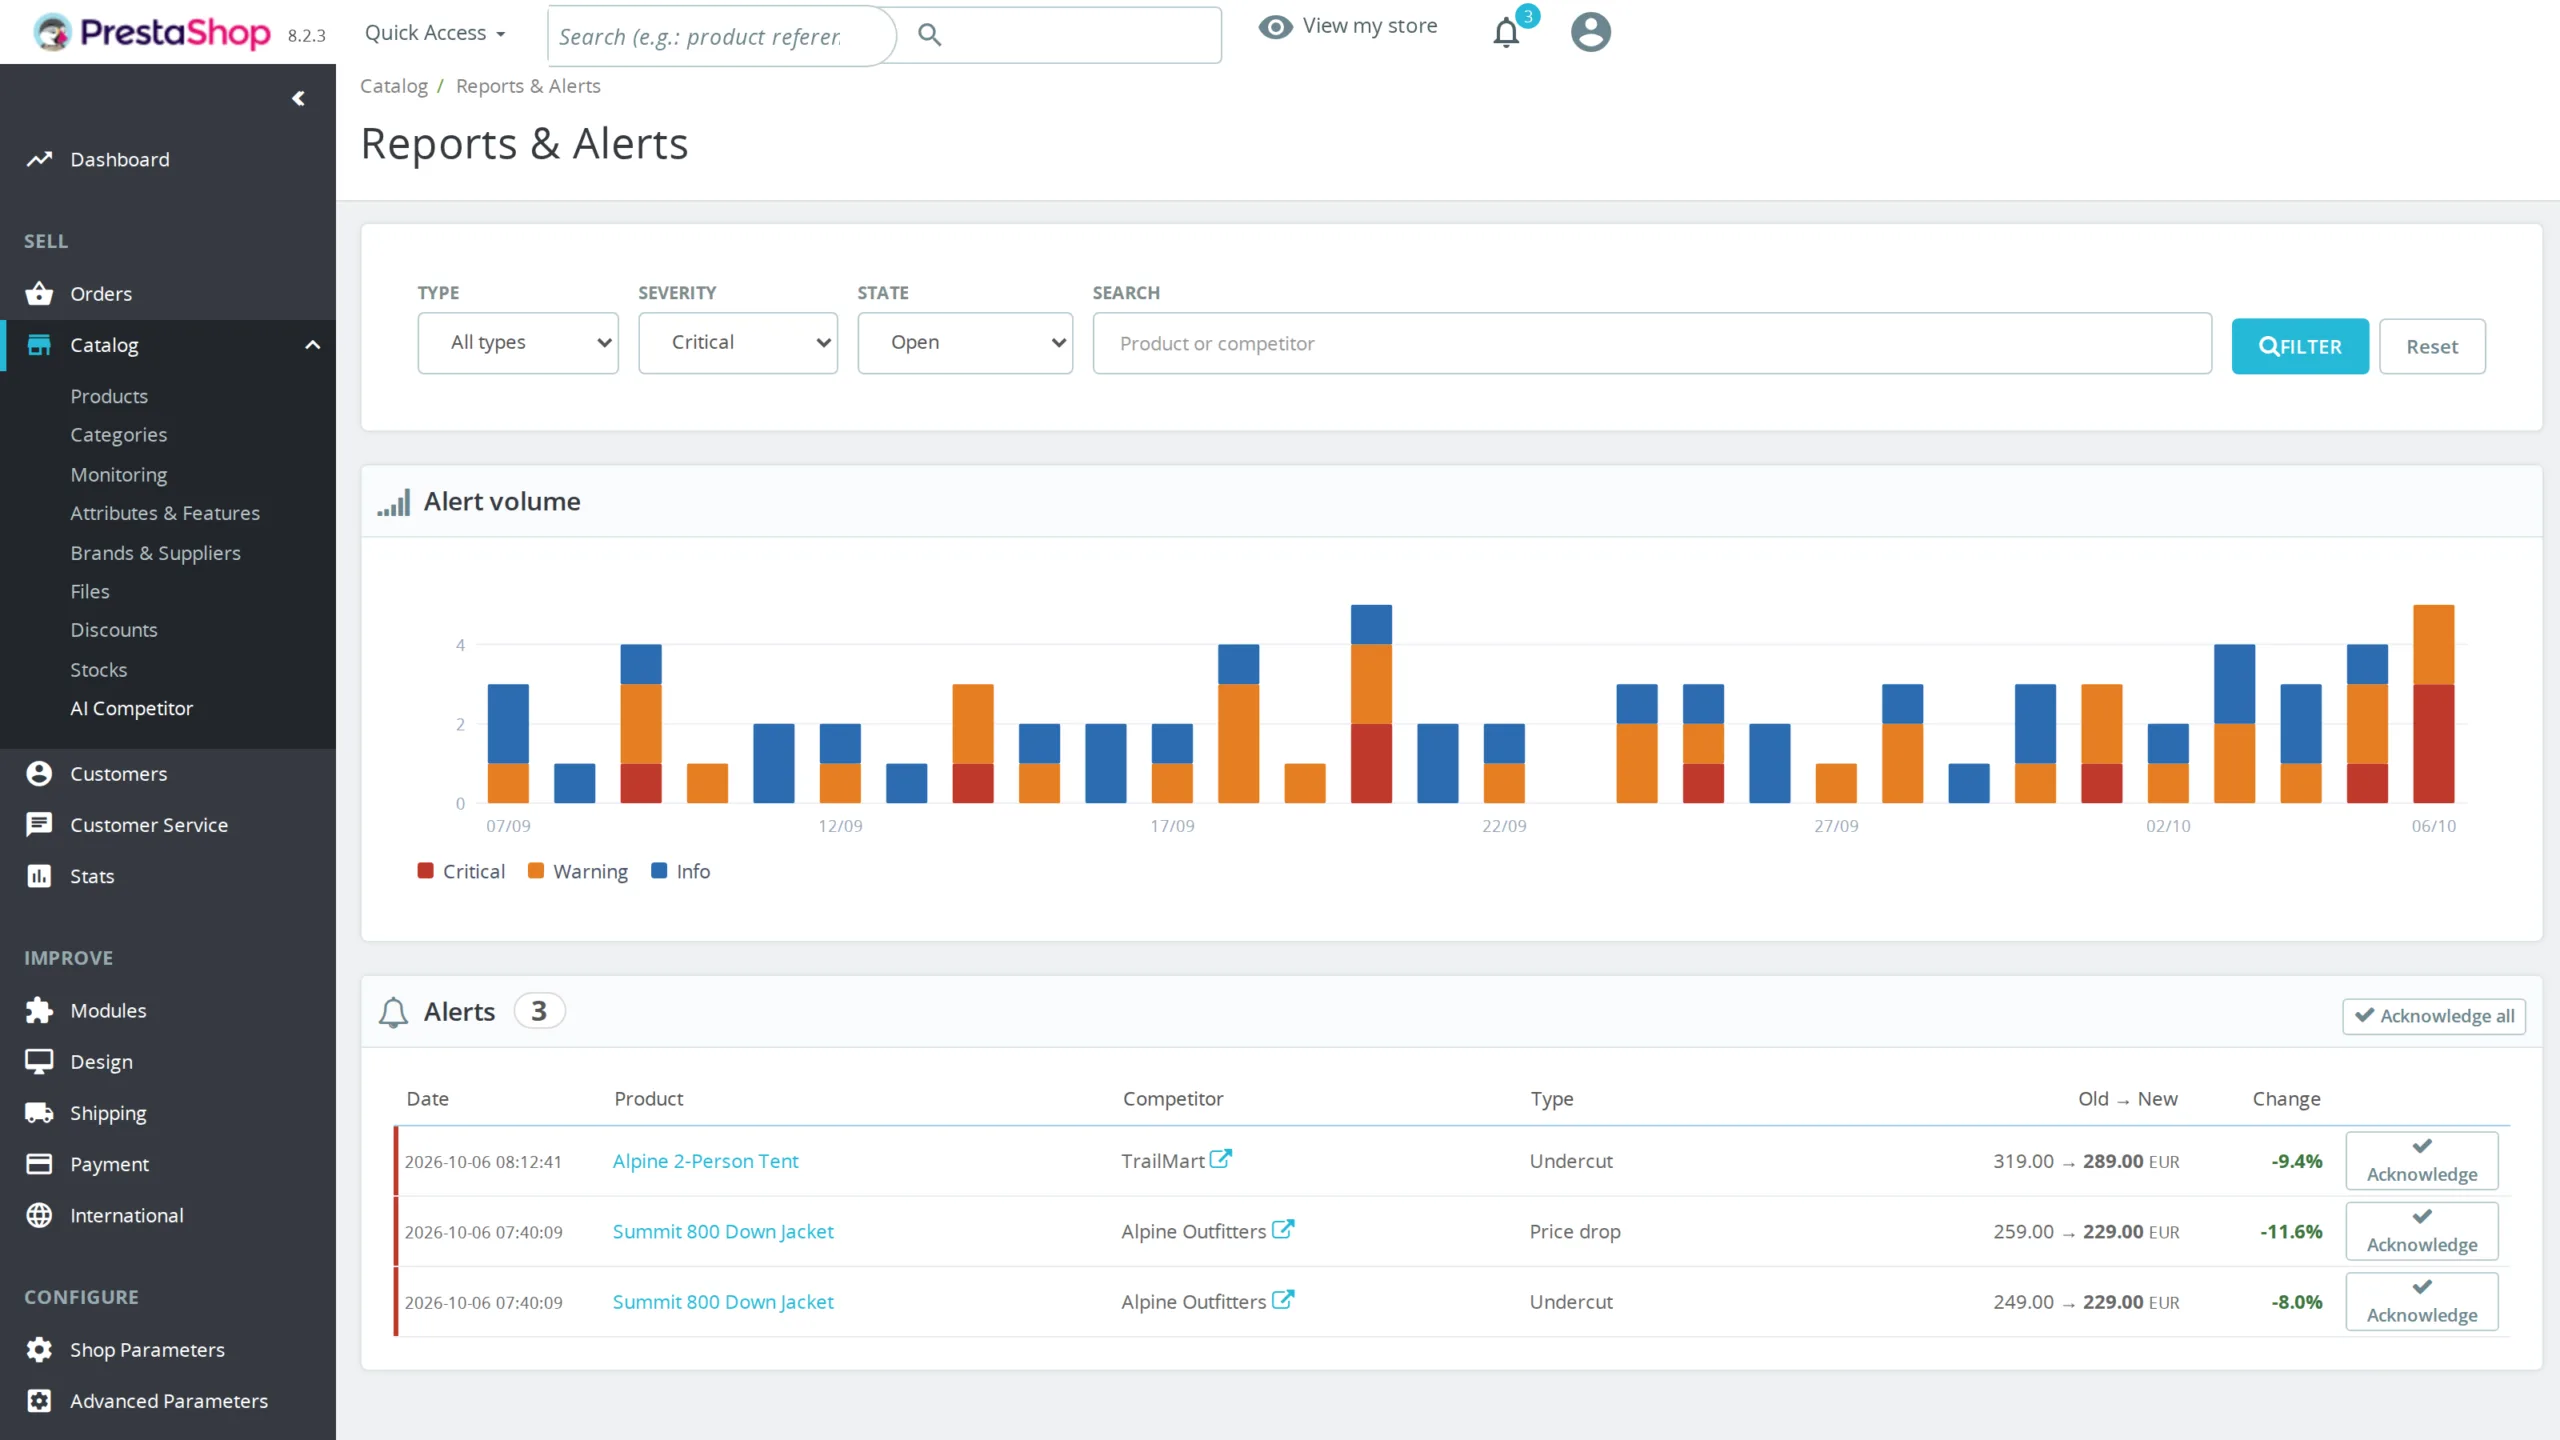
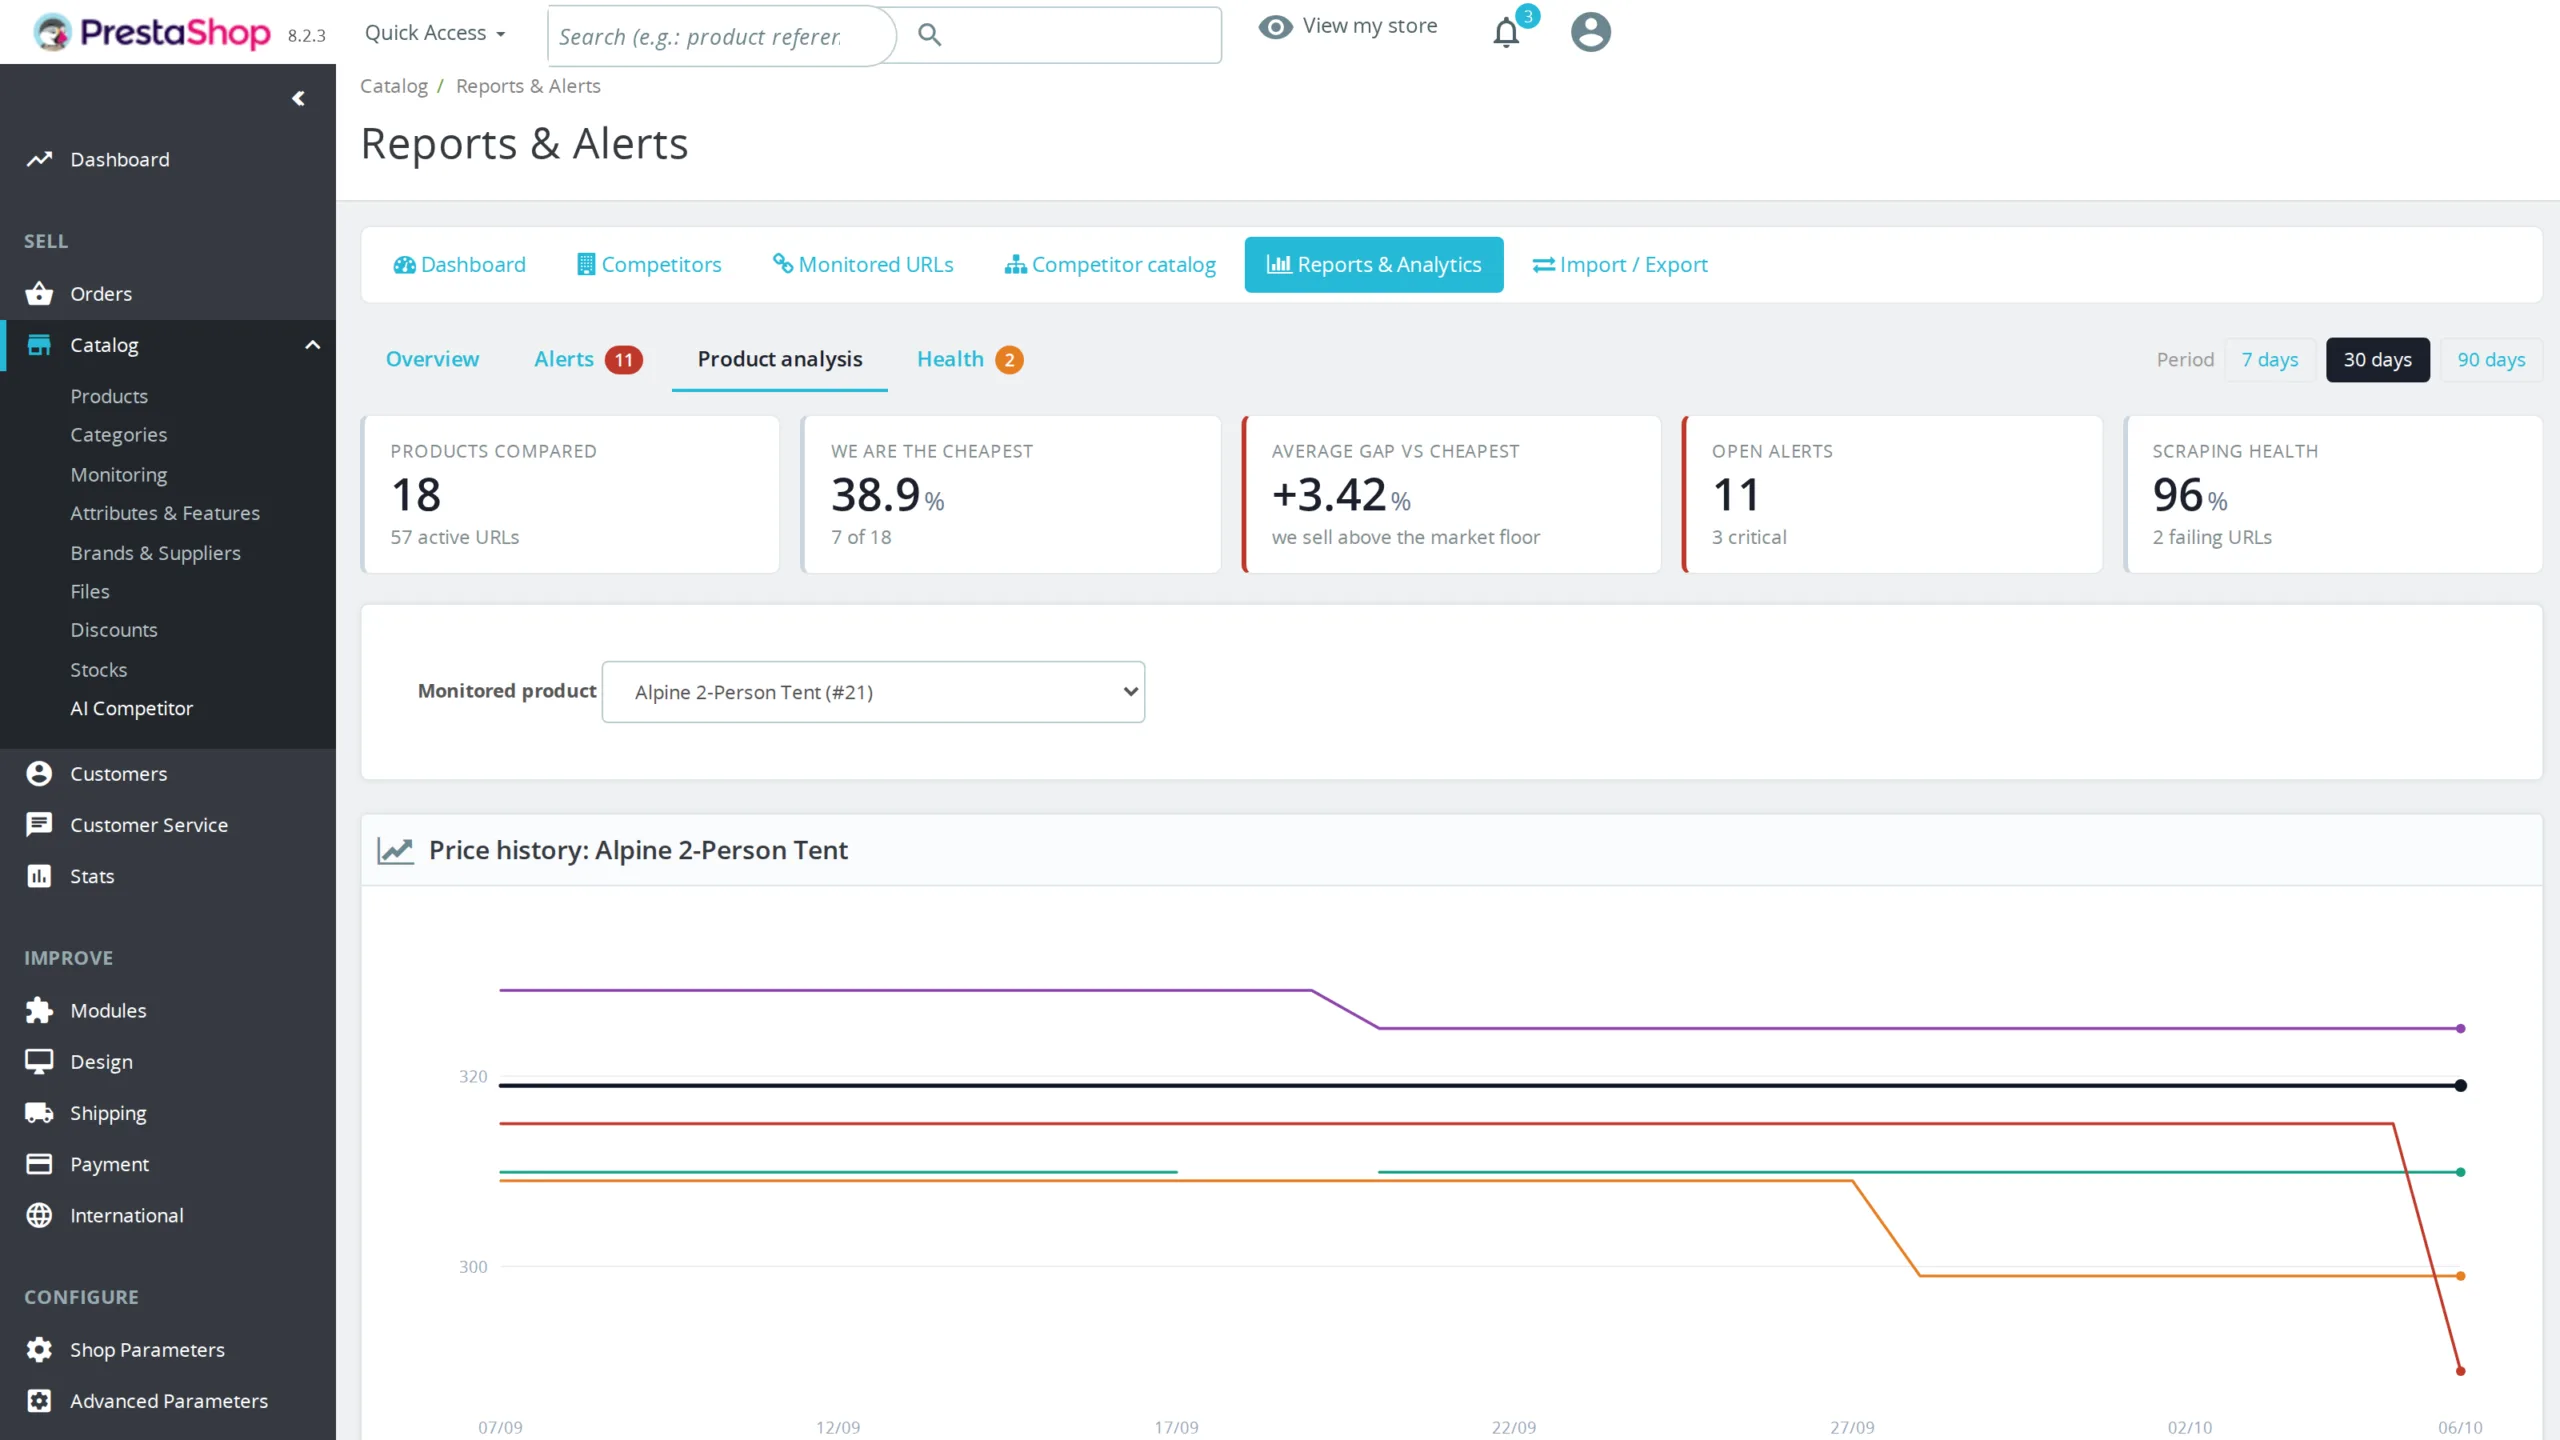
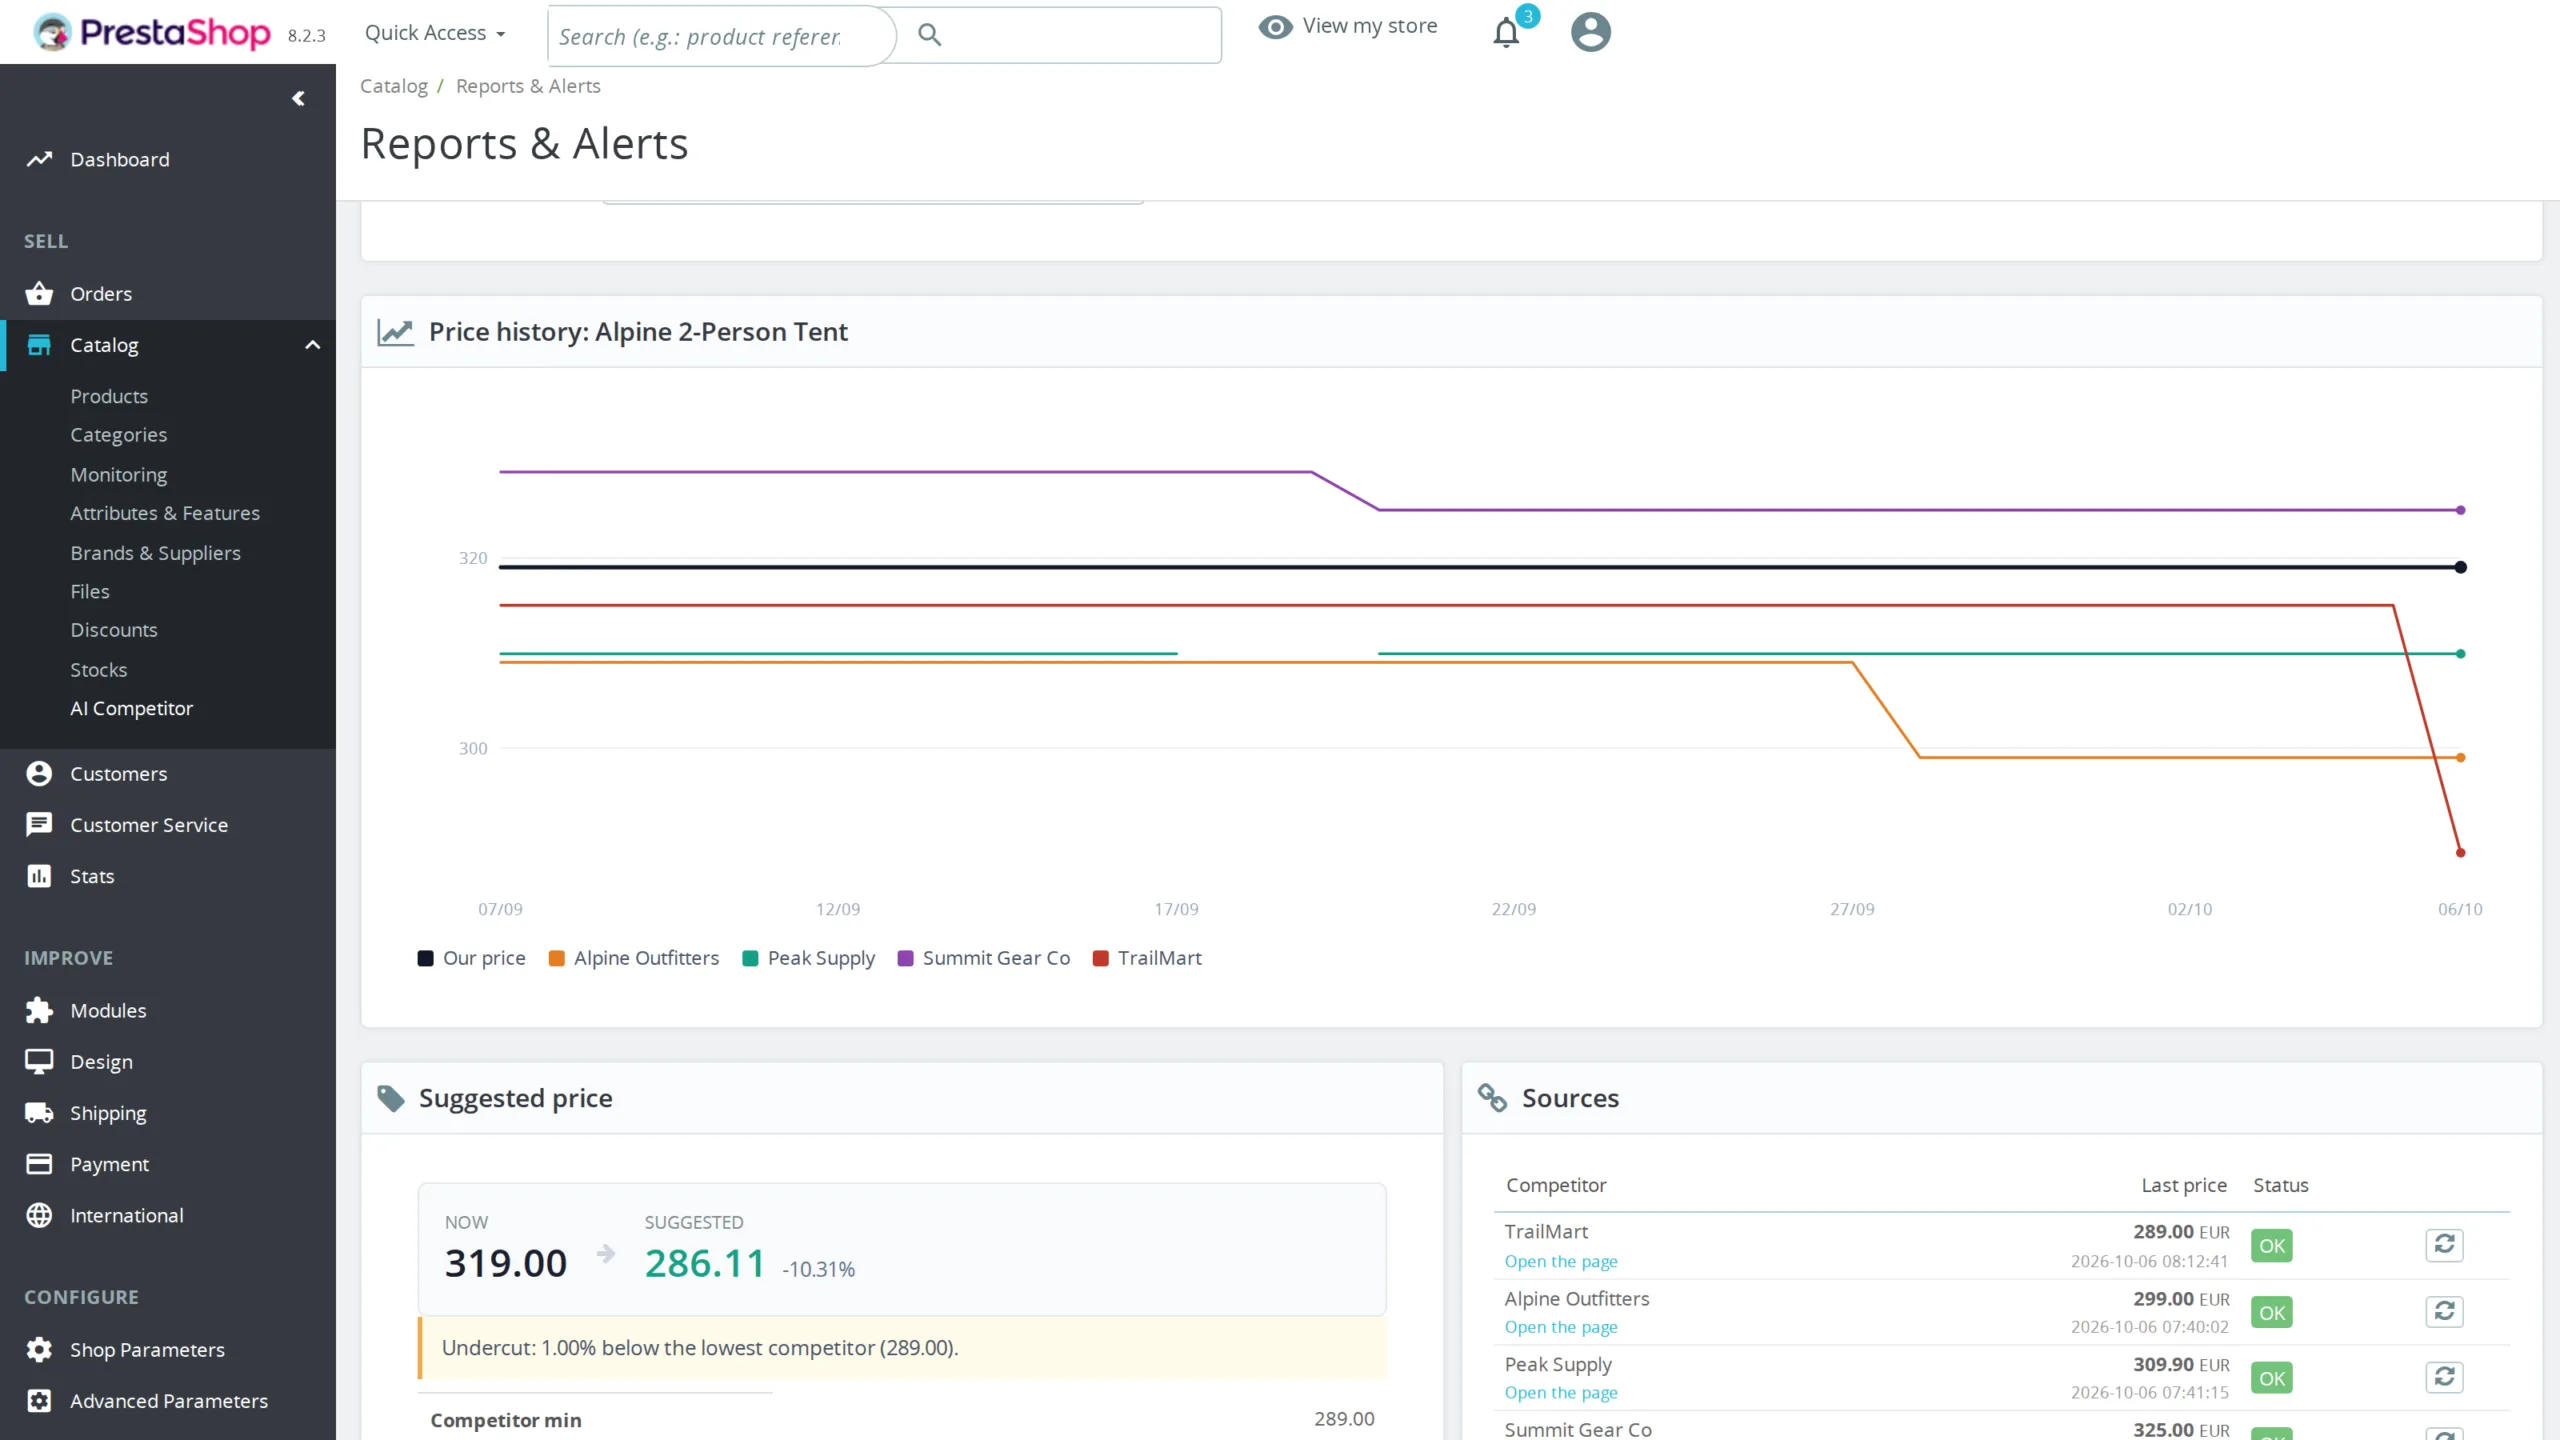
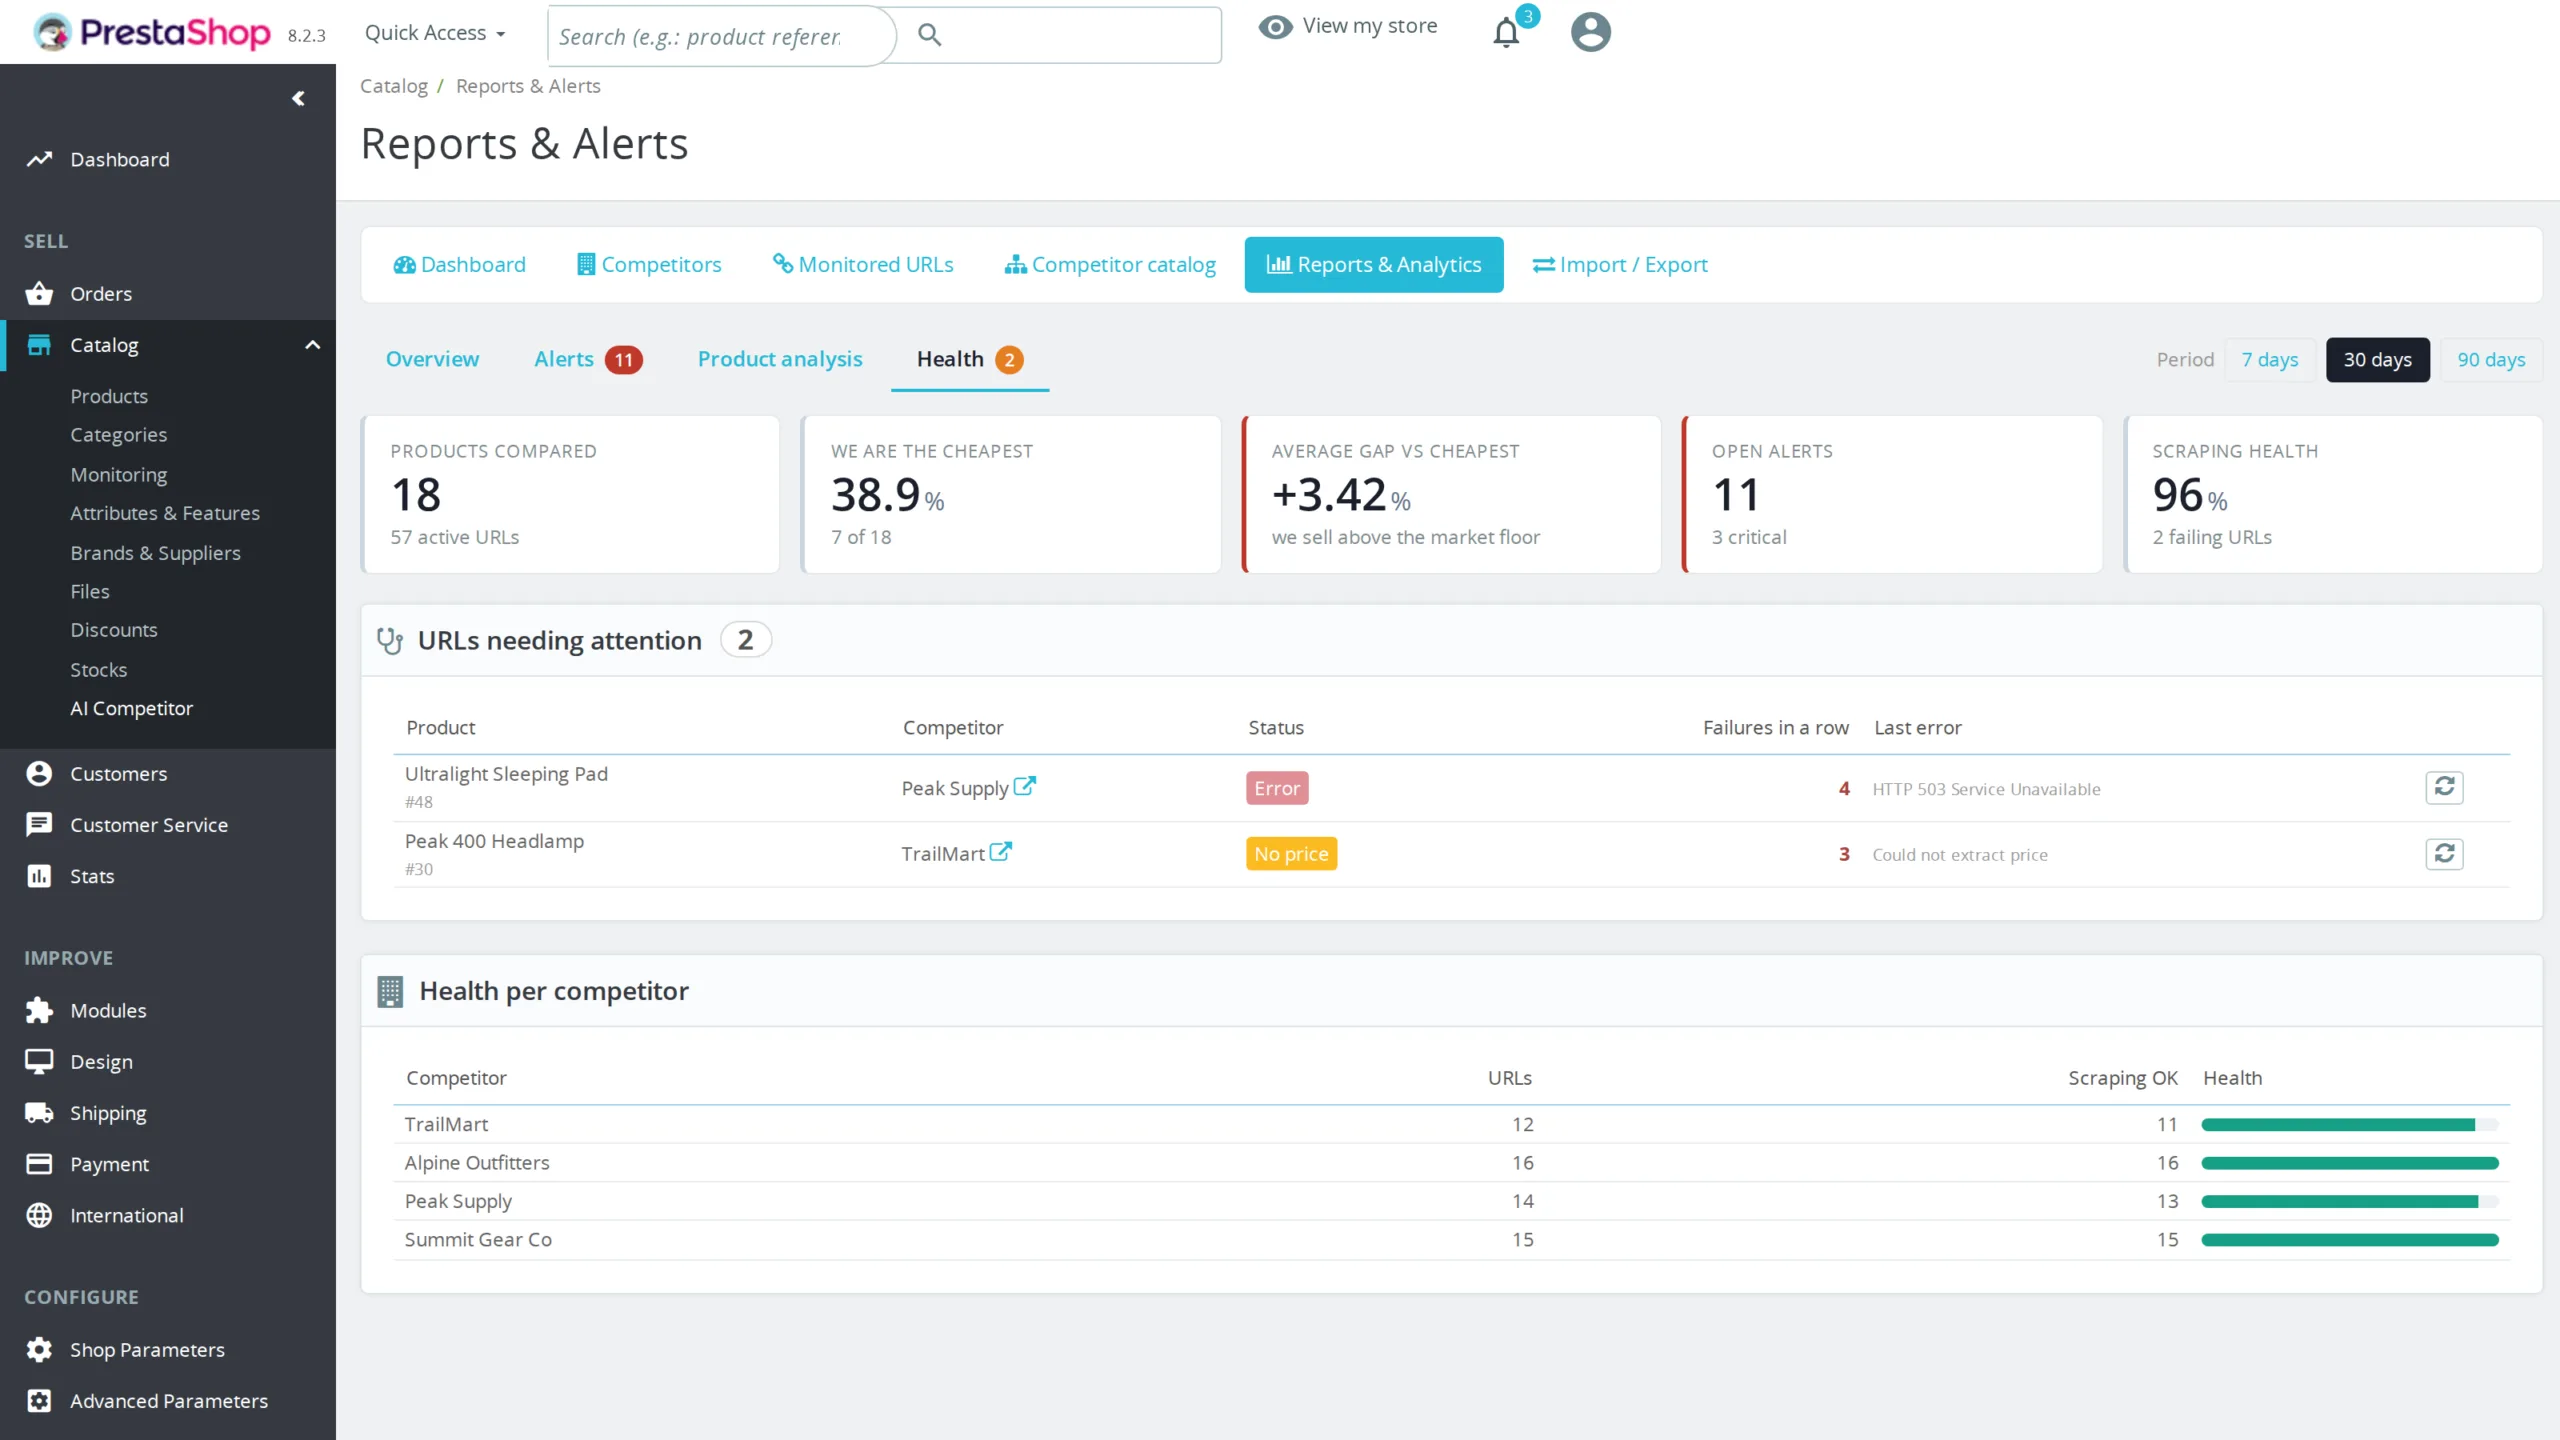
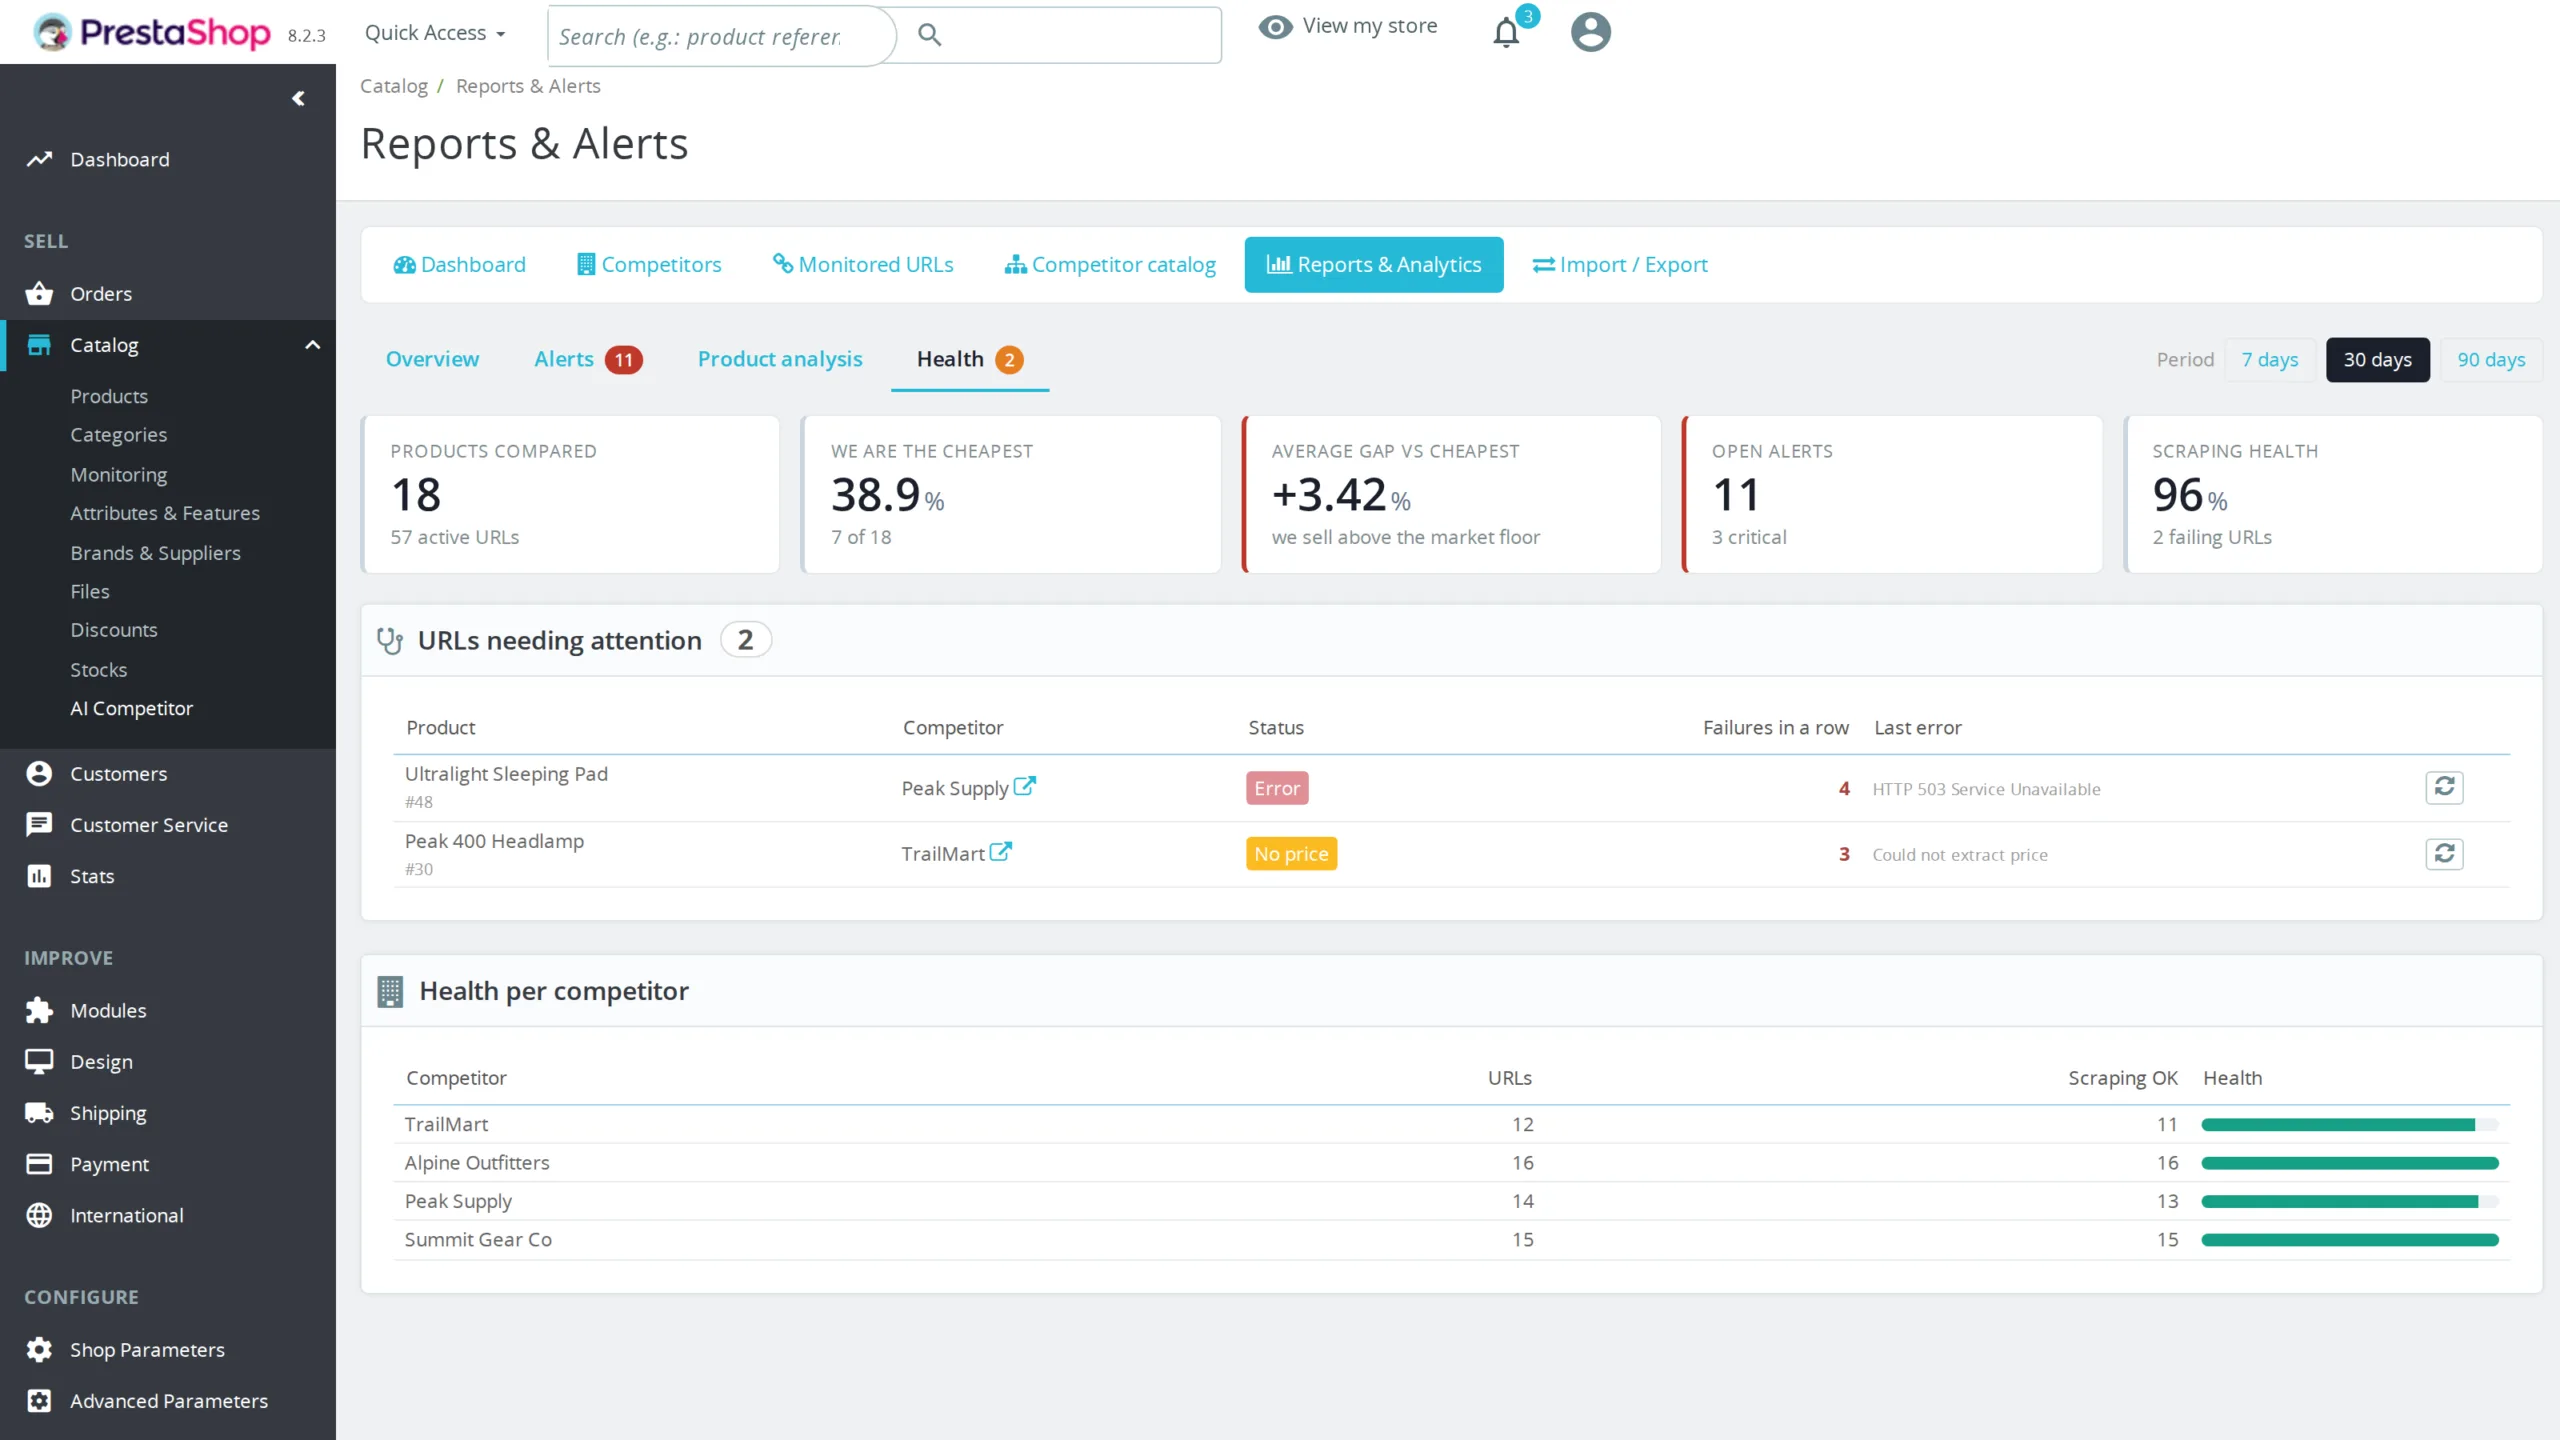
L'écran de rapports tient en quatre onglets derrière un bandeau d'indicateurs permanent. La vue d'ensemble donne votre position sur le marché : part de produits où vous êtes le moins cher, part où vous êtes le plus cher, écart moyen face au prix plancher, et la liste des produits classés par écart, ceux où vous perdez sur le prix comme ceux où vous avez de la marge pour remonter. L'onglet alertes filtre par type, sévérité, état et texte libre, avec acquittement sans rechargement de page. L'onglet analyse produit trace votre prix contre celui de chaque concurrent sur la période choisie. L'onglet santé liste les URLs qui échouent, avec leur dernière erreur et un bouton de relance. Chaque relevé conserve aussi votre propre prix du moment, ce qui rend l'historique des écarts reconstituable.
§ 08
Des alertes utiles, jamais bruyantes
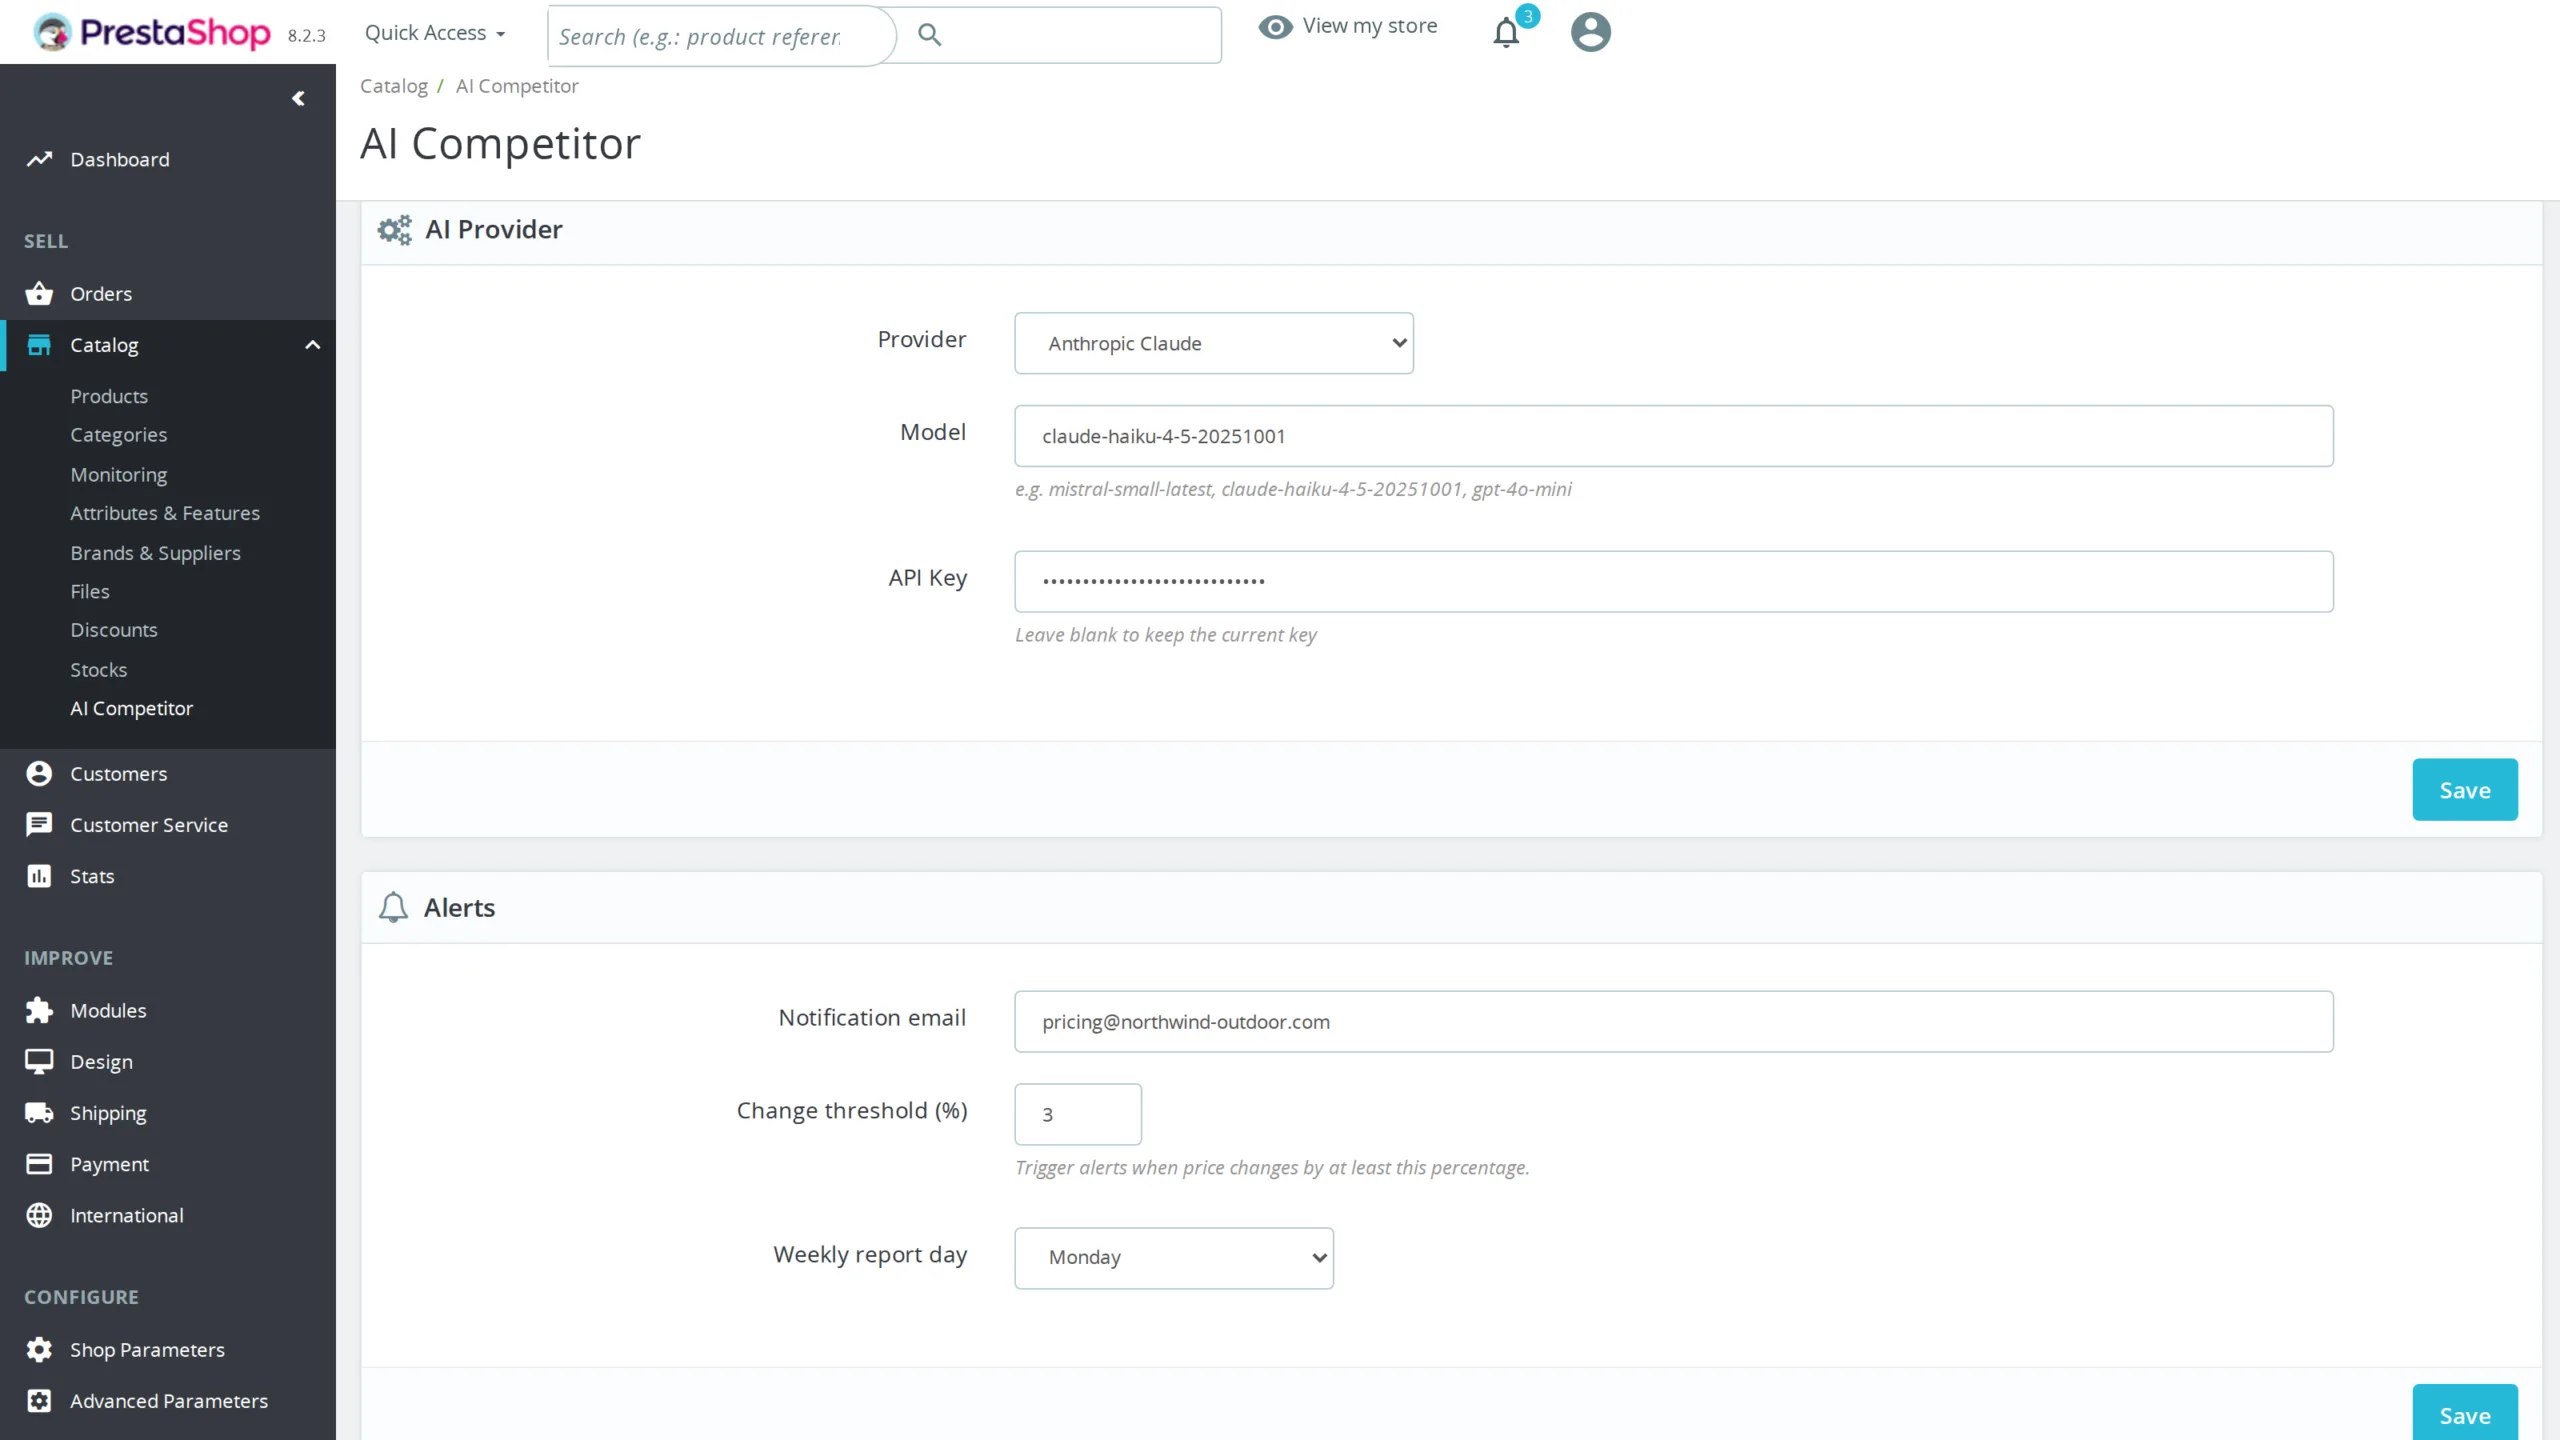
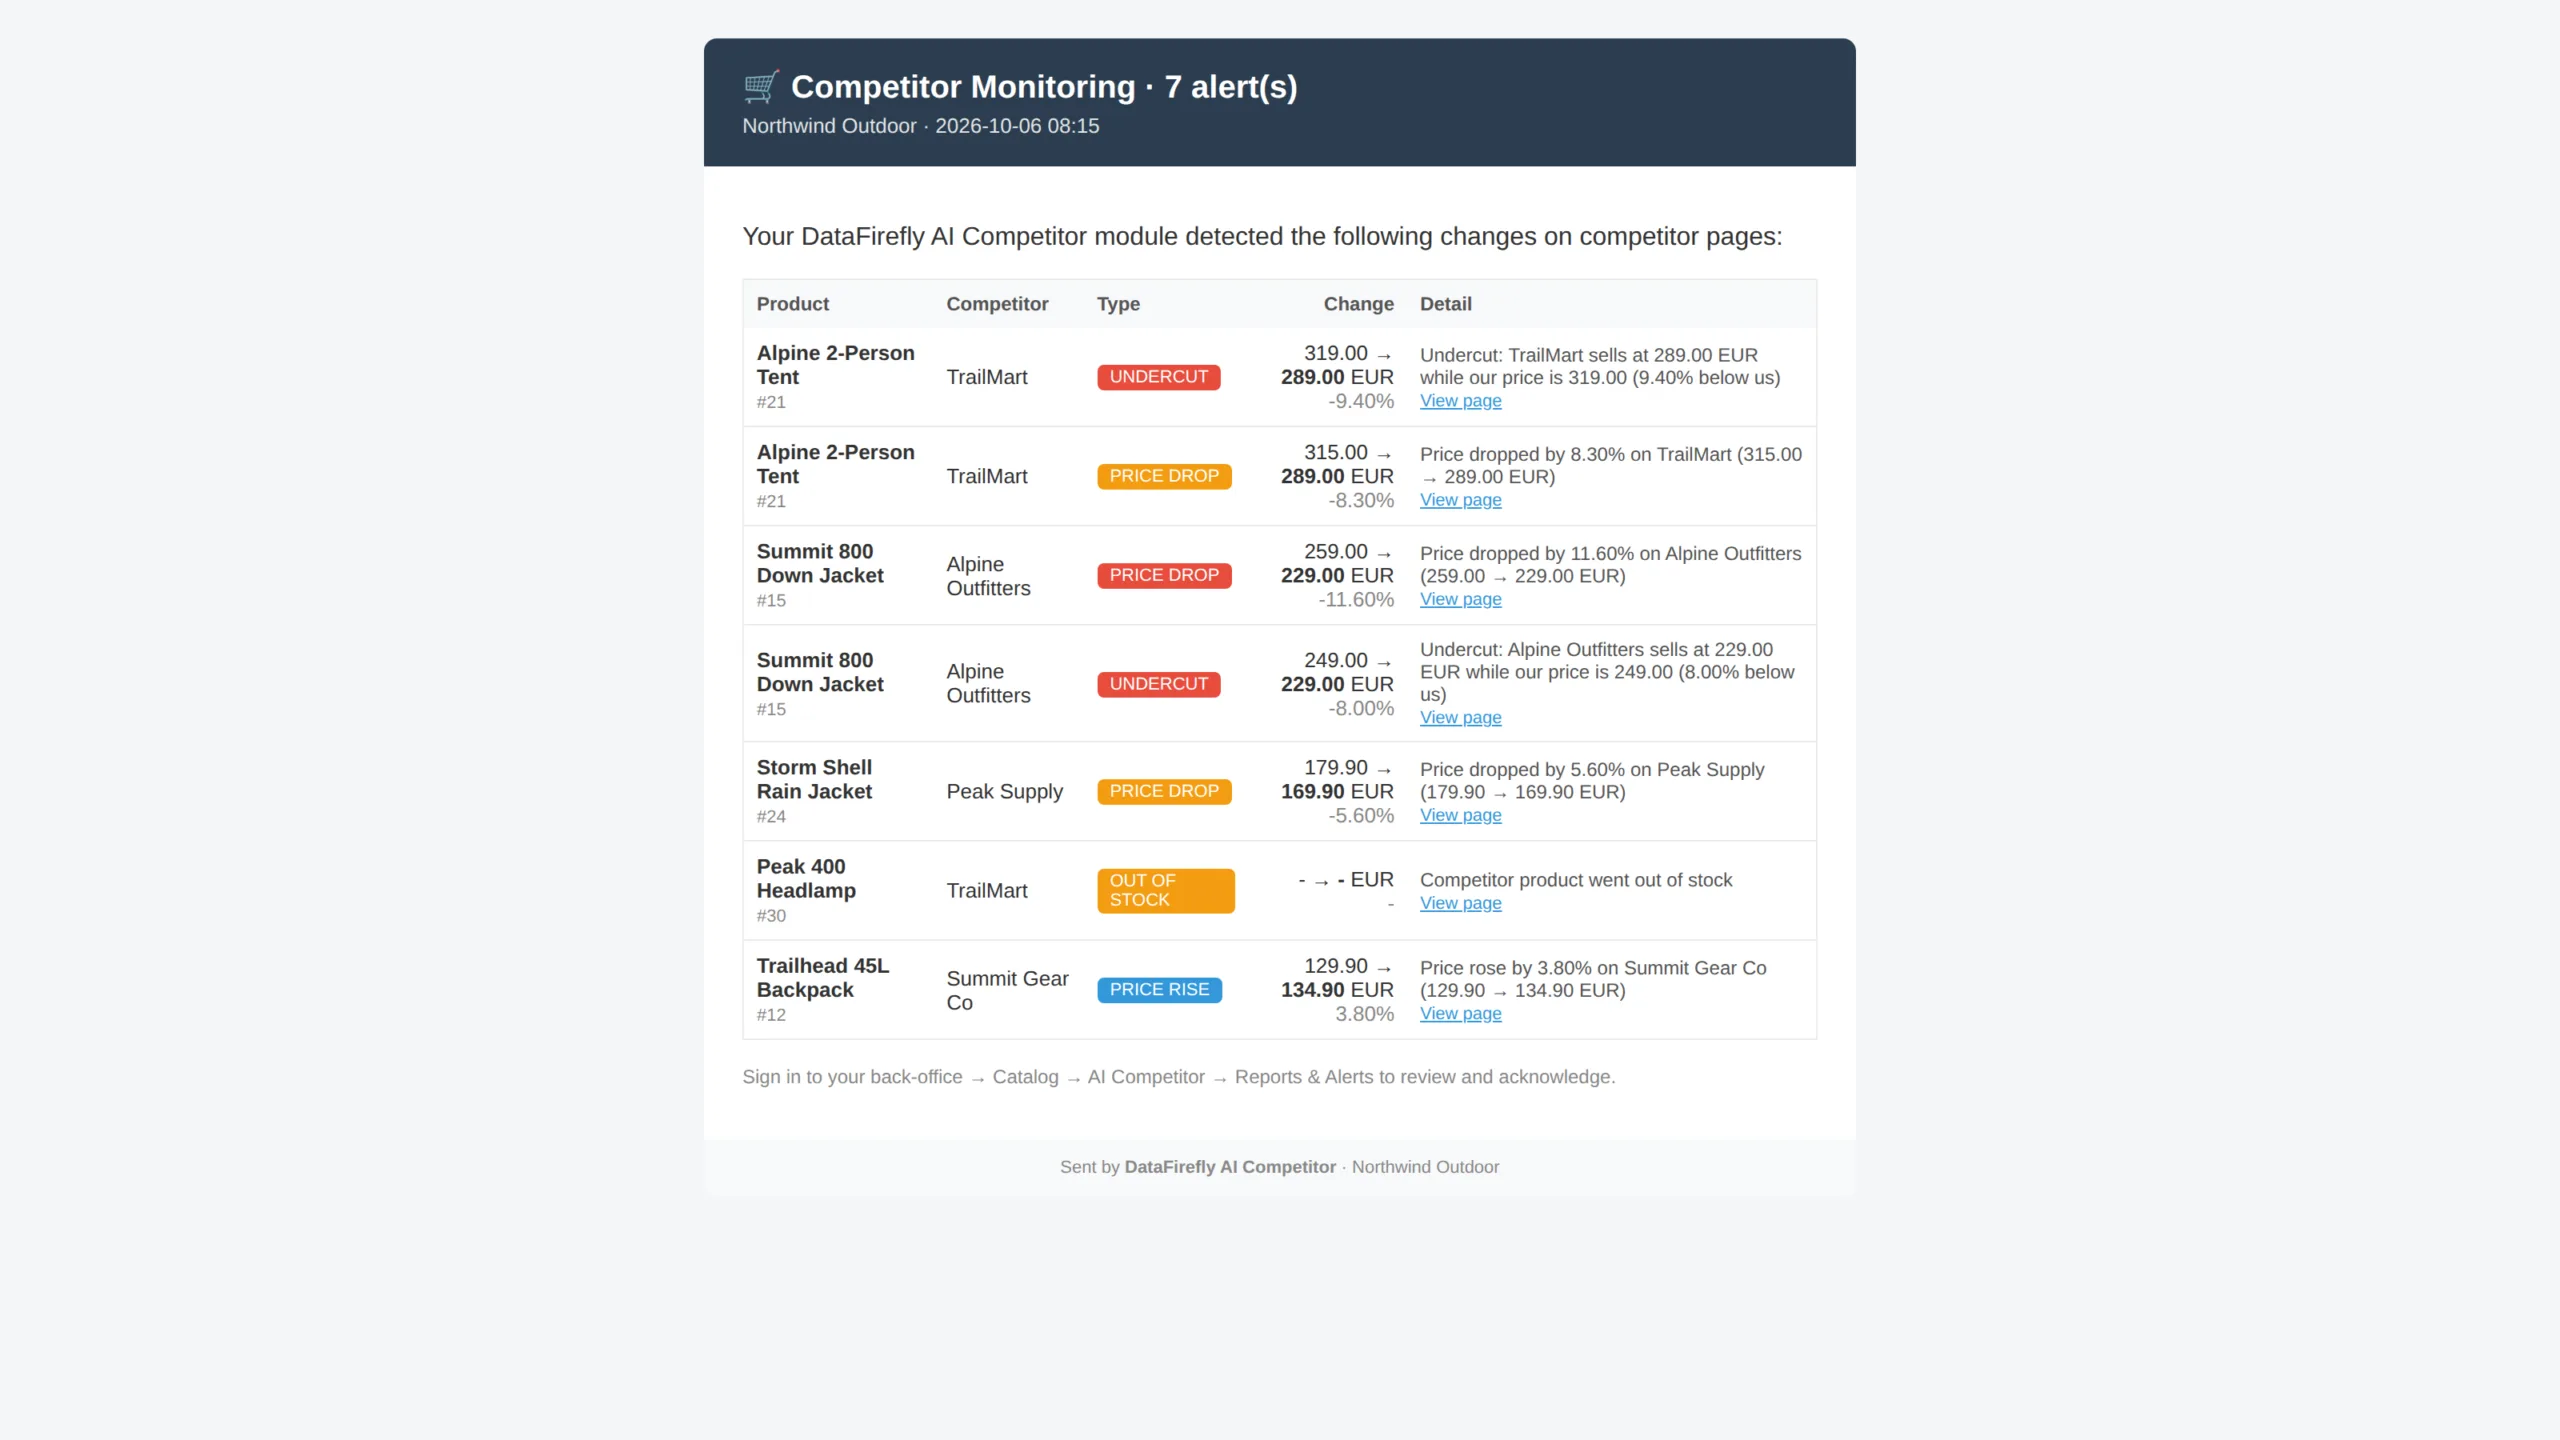
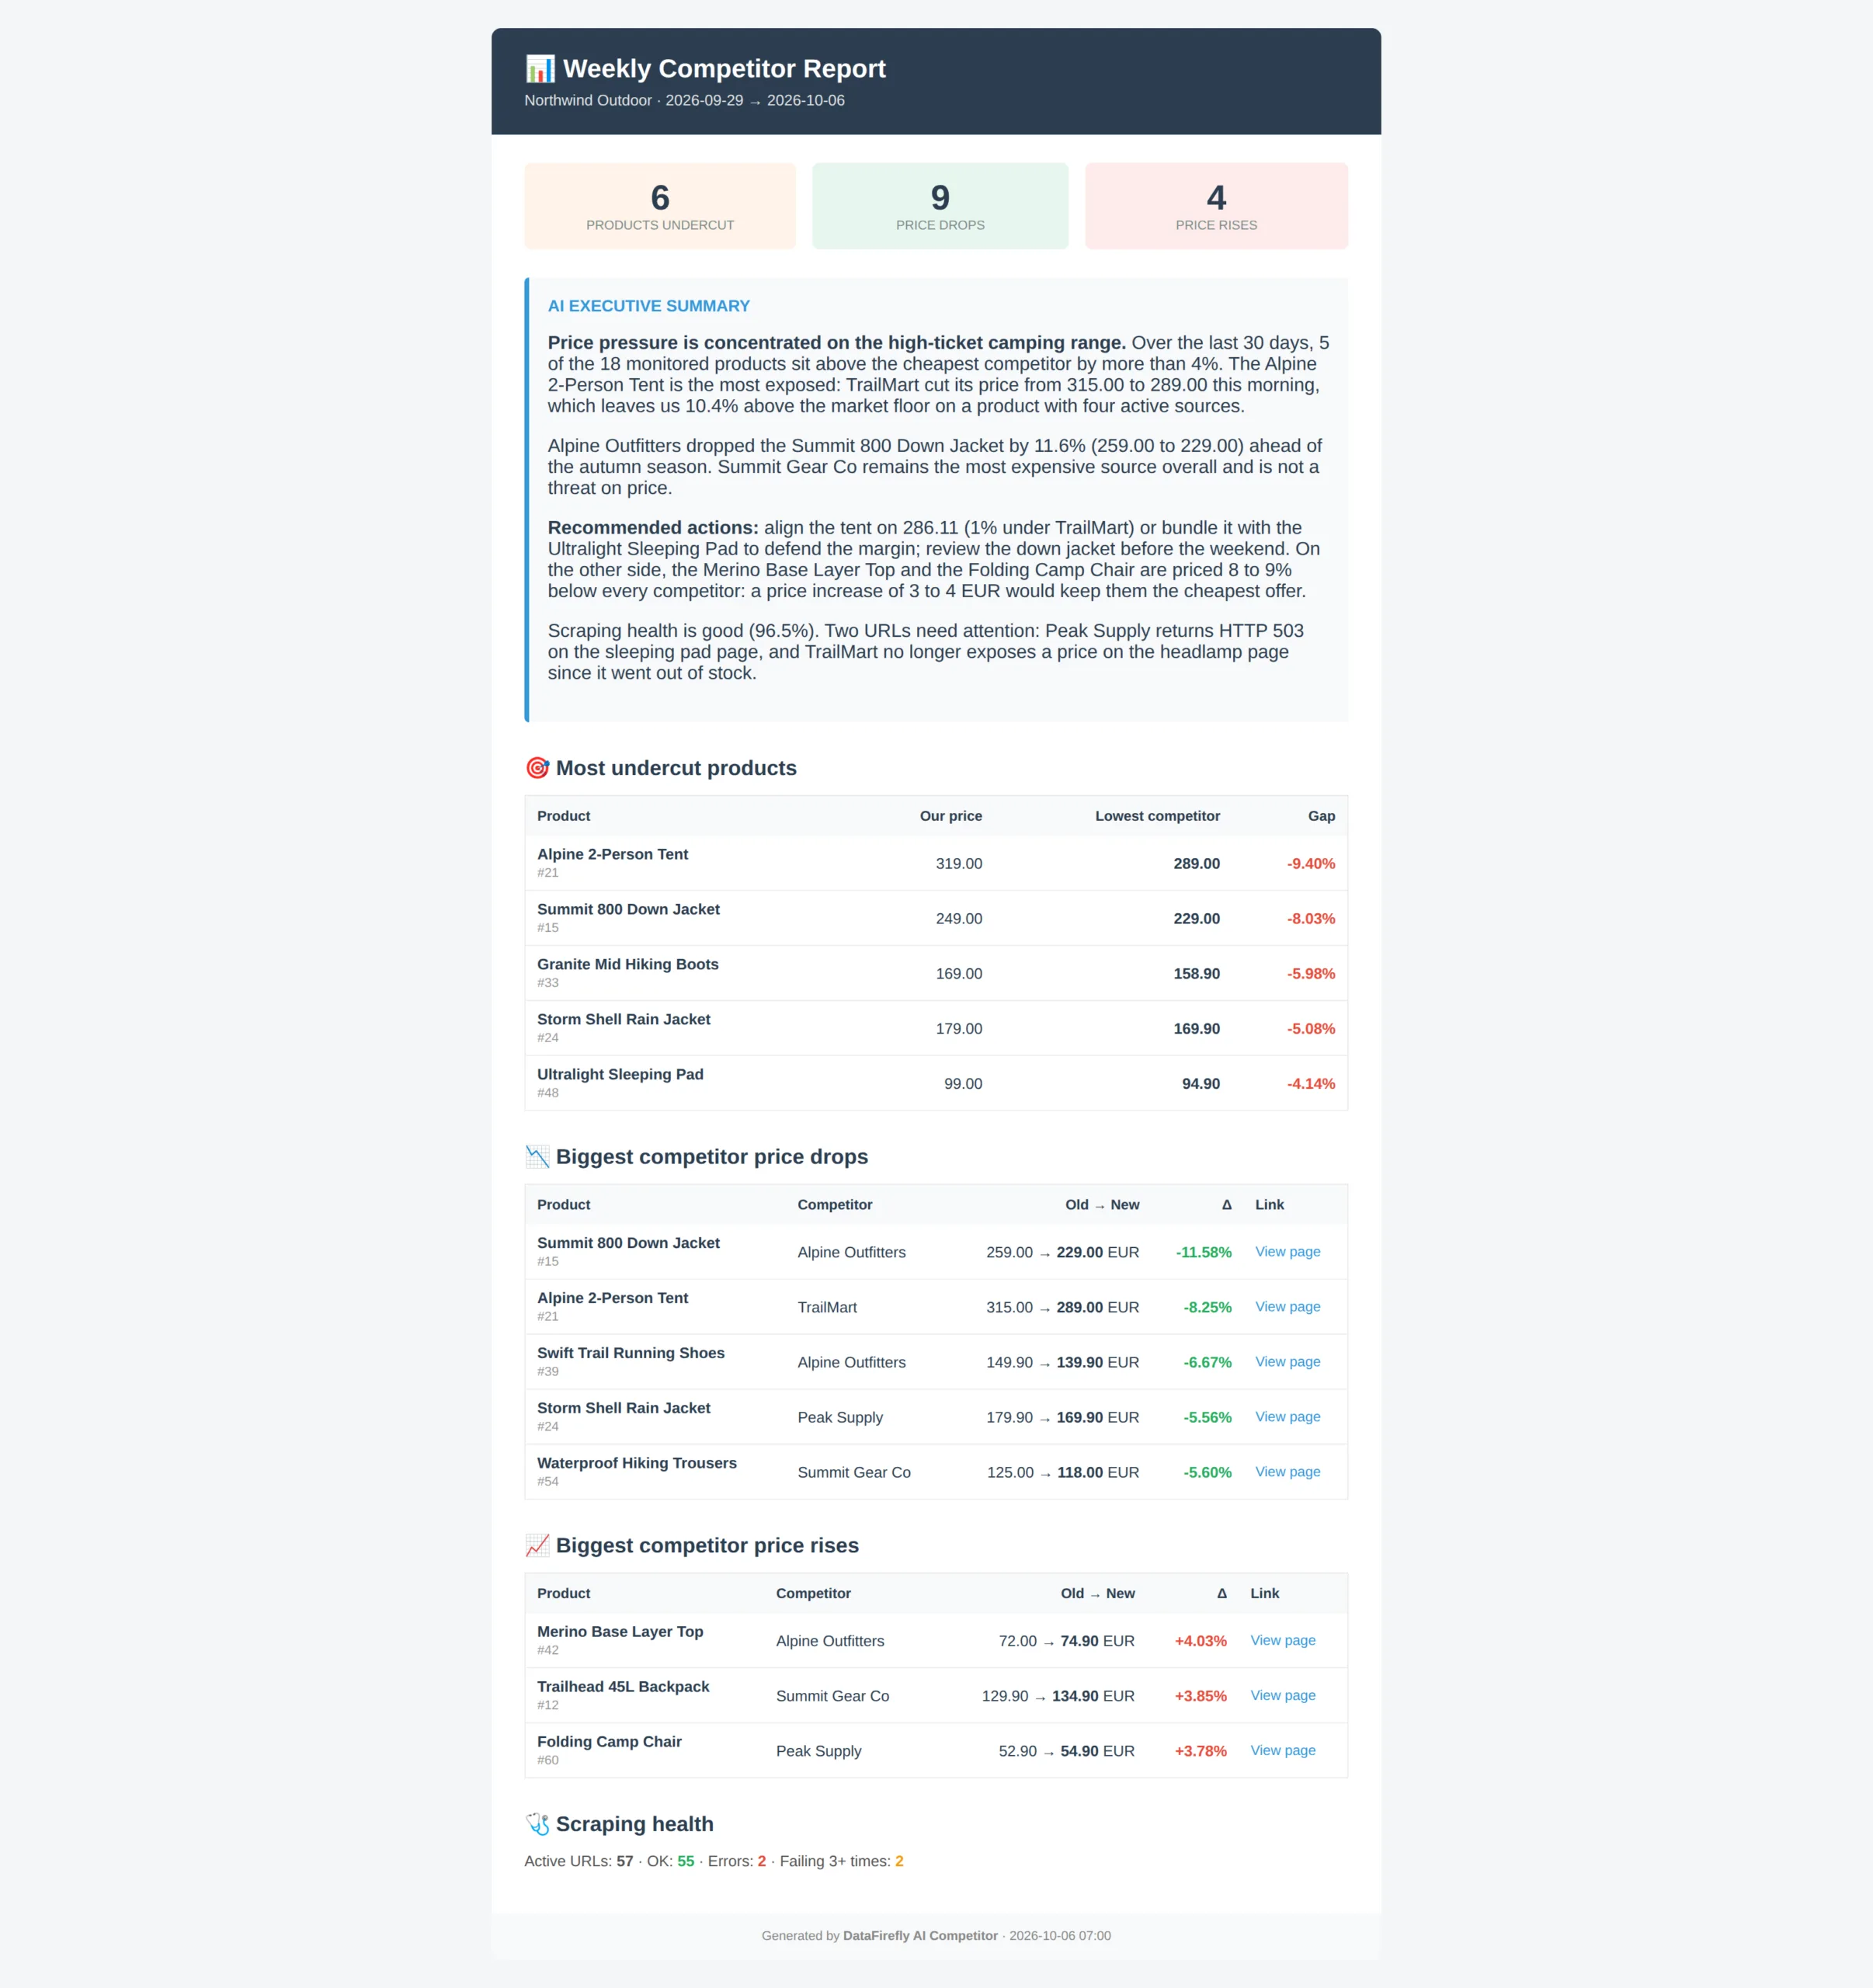
Le seuil de déclenchement est configurable, 3 pourcent par défaut. Cinq types d'alertes sont gérés : baisse de prix, hausse, rupture de stock, retour en stock, et undercut quand un concurrent passe sous votre prix. Chaque alerte est graduée selon sa sévérité. Une variation de 1 pourcent est notée info, une baisse de 15 pourcent ou un undercut sont qualifiés de critical. Les erreurs de scraping ne génèrent une alerte qu'après trois échecs consécutifs, ce qui élimine le bruit lié aux indisponibilités passagères. Chaque semaine, le jour de votre choix, un rapport HTML récapitule la période et l'IA en rédige la synthèse exécutive.
§ 09
La suggestion d'ajustement, toujours sous contrôle humain
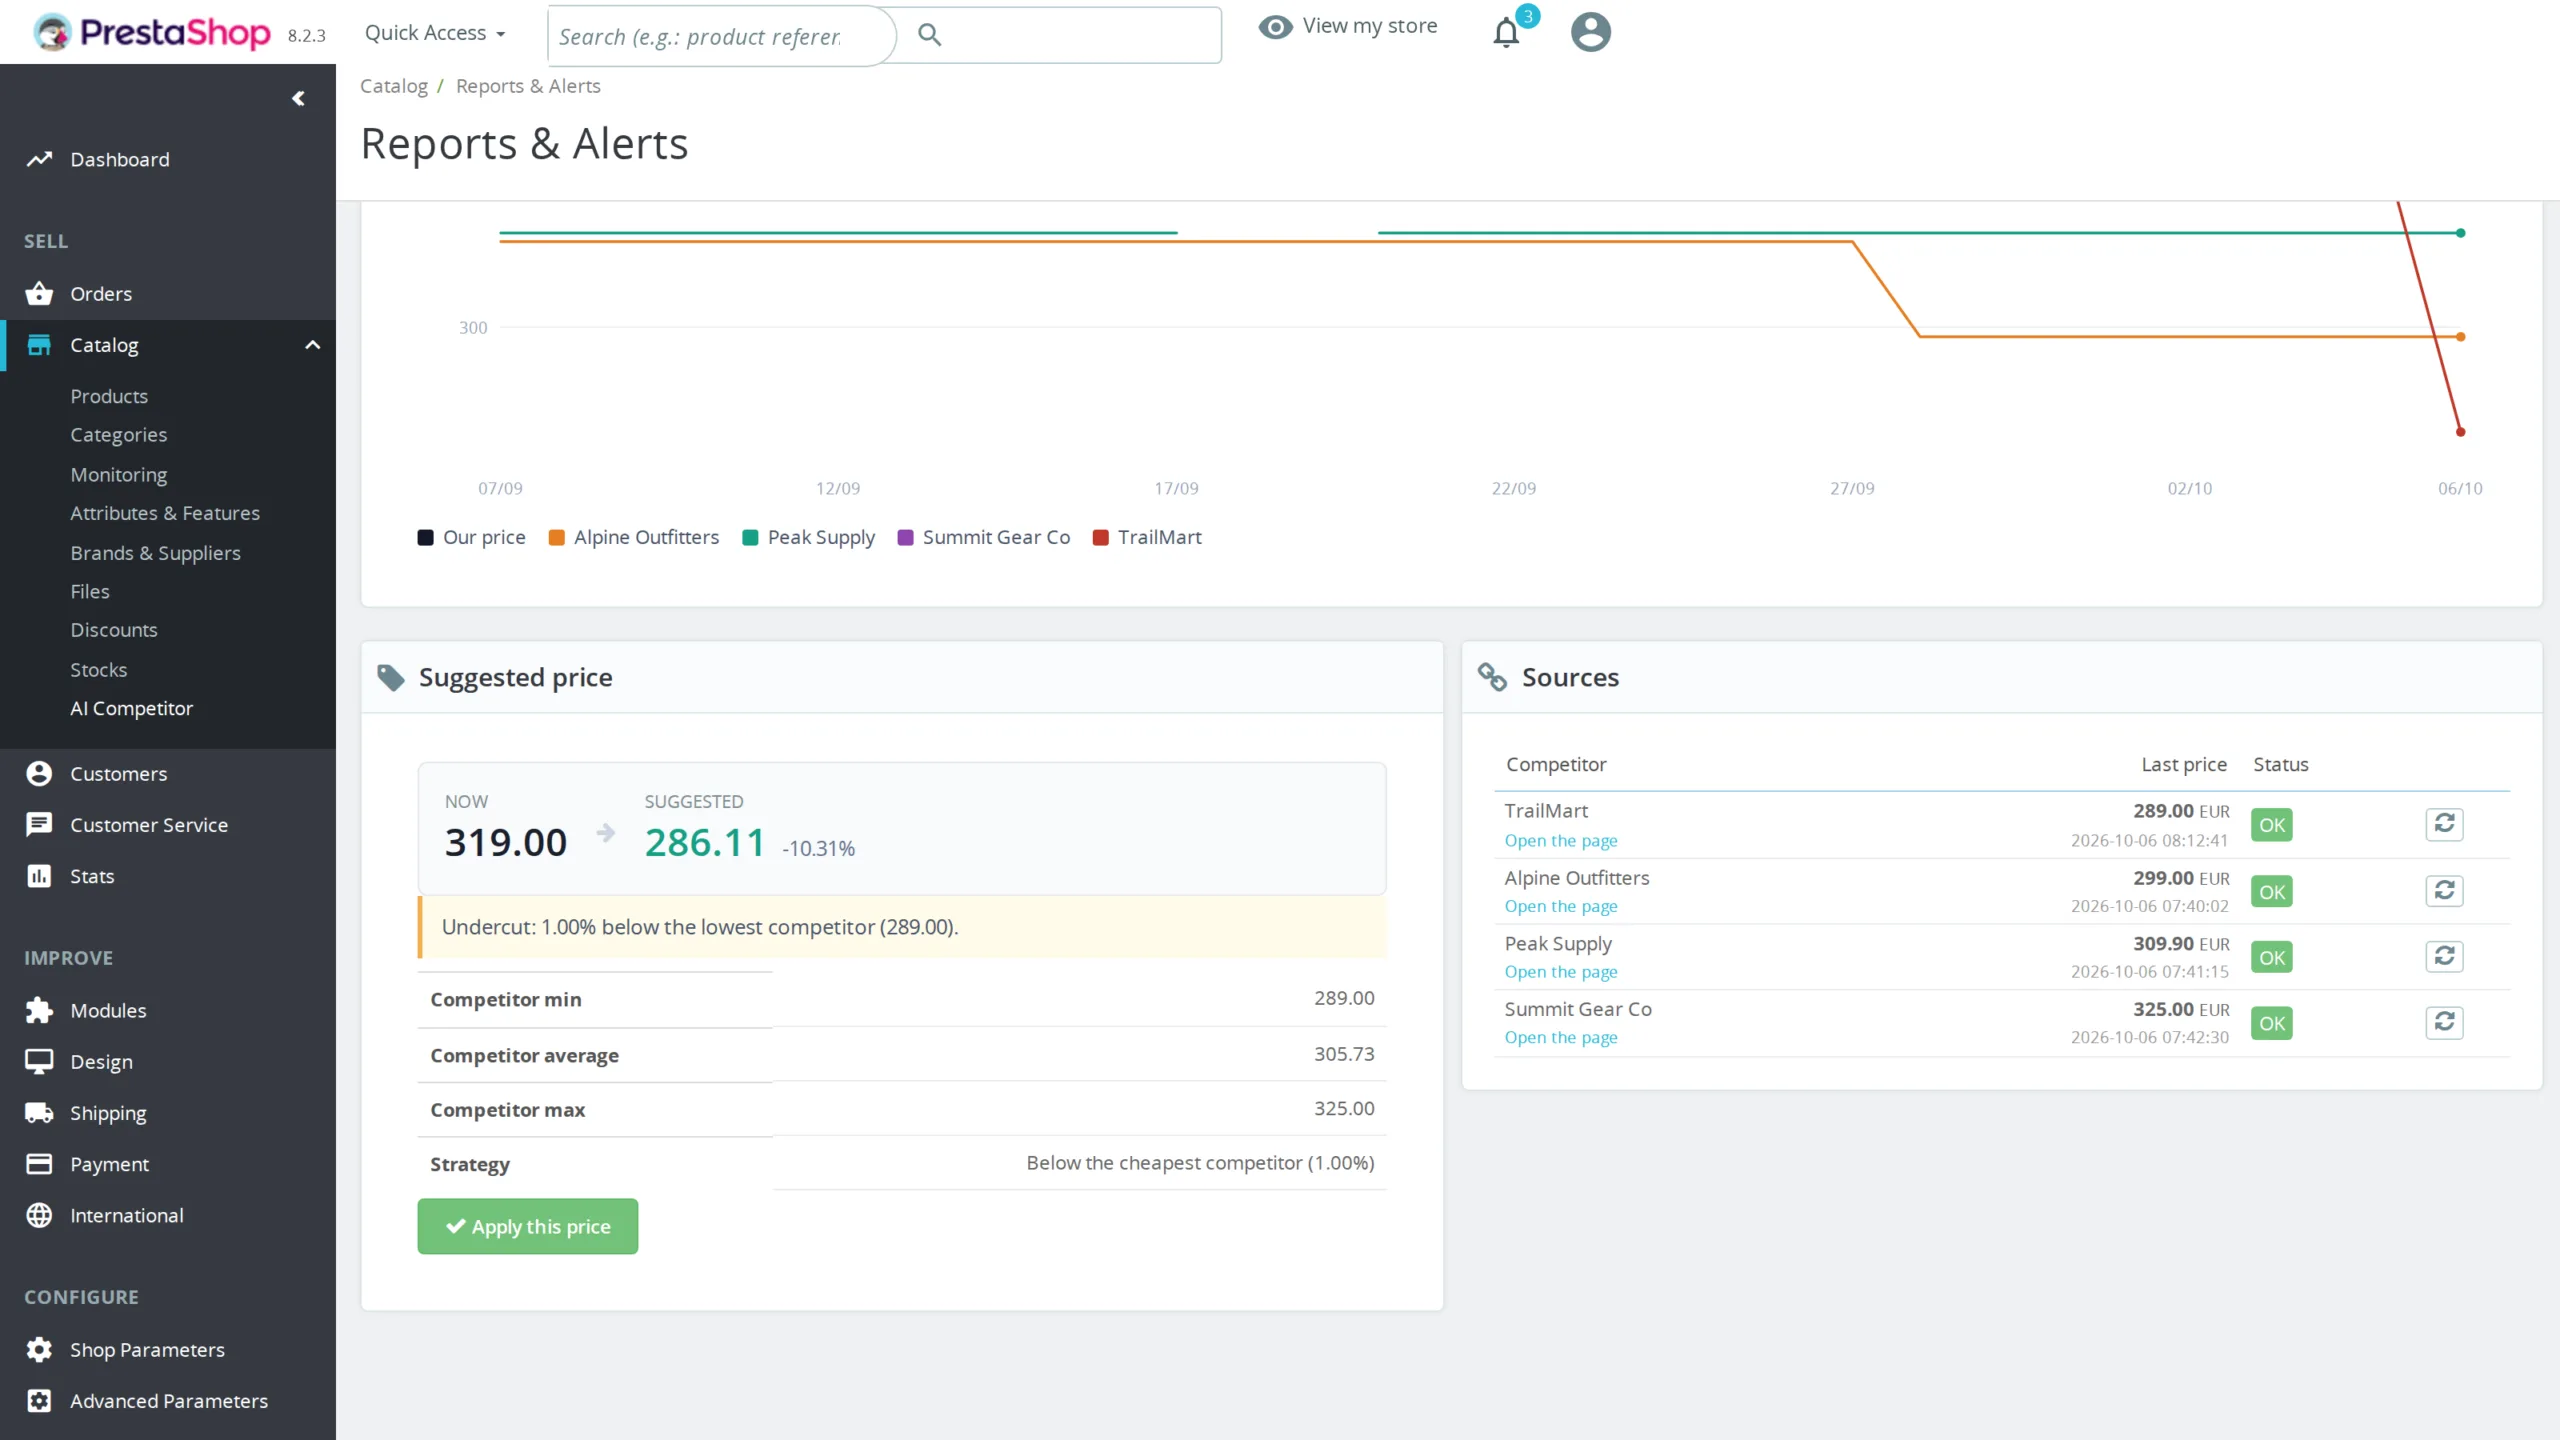
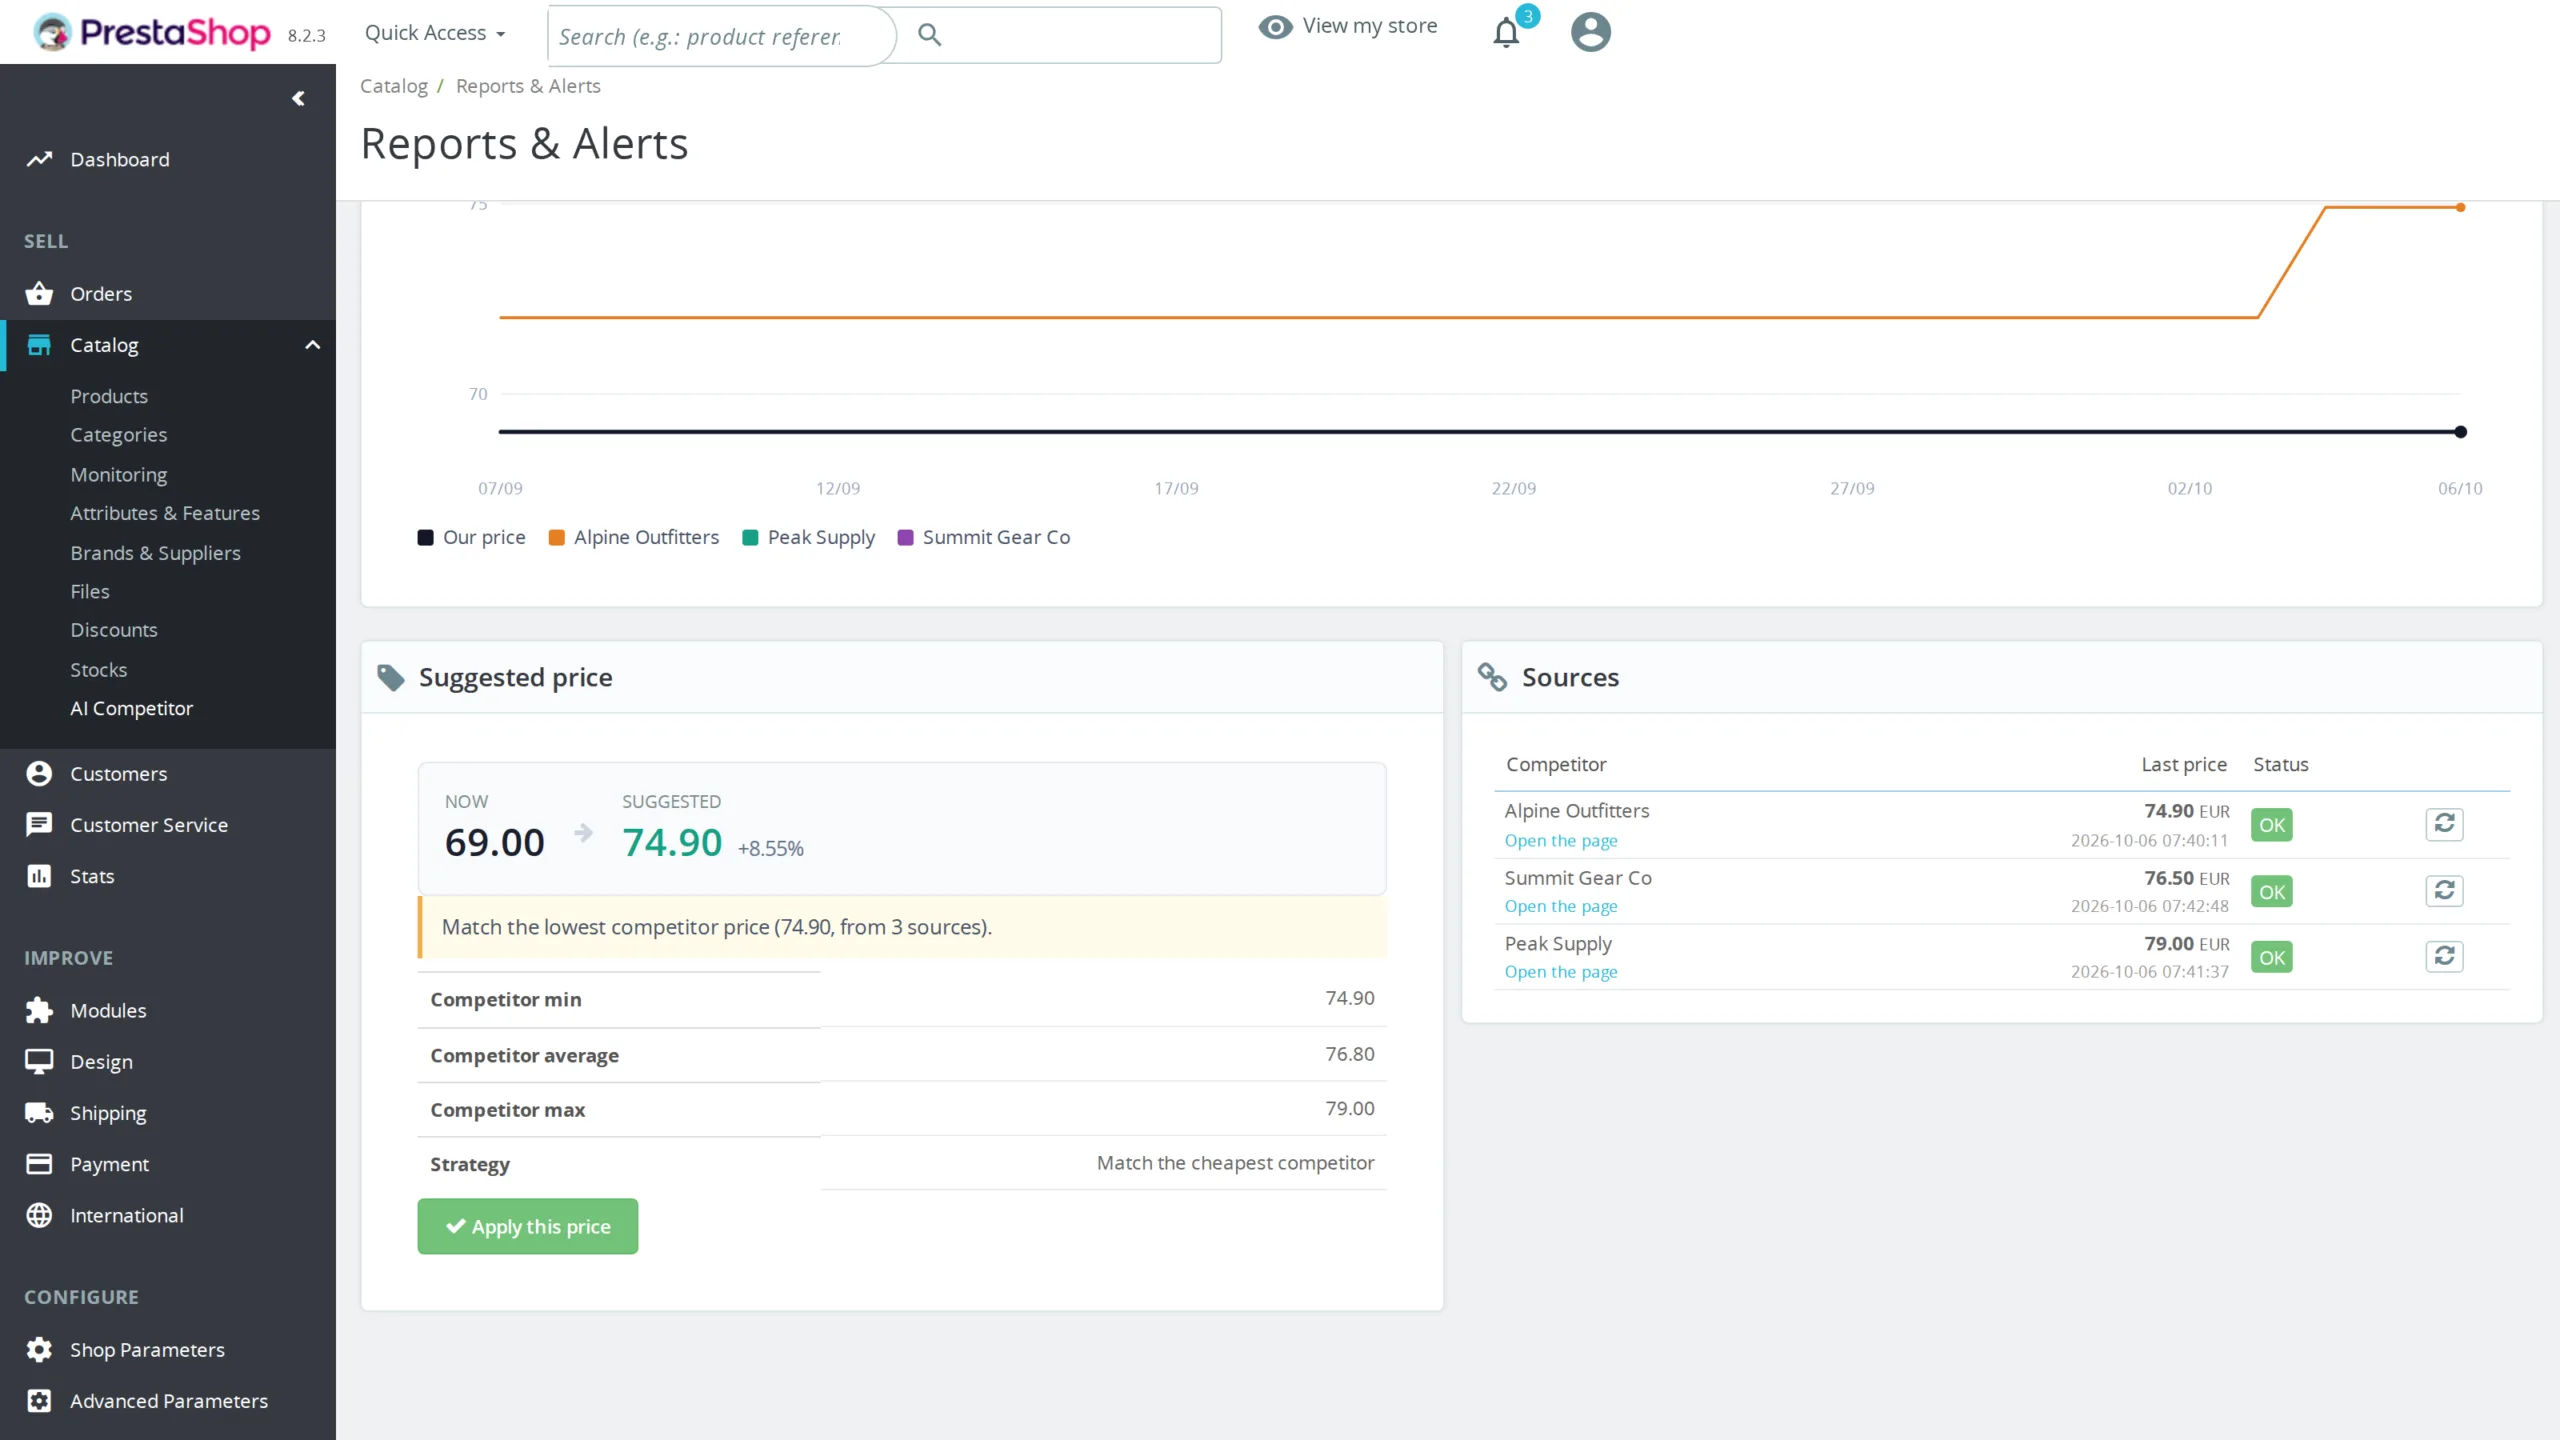
Pour chaque produit surveillé, le module calcule une suggestion de prix selon la stratégie configurée : aligner sur le plus bas concurrent, undercut de X pourcent en dessous, ou positionnement premium à X pourcent au-dessus. La suggestion est toujours présentée à un humain, avec le prix actuel et le prix proposé côte à côte. Un bouton applique le prix au produit PrestaShop. Aucun ajustement automatique : pas de boucle de baisse en miroir avec des concurrents équipés du même type d'outil, pas de dérive incontrôlée. Le contrôle métier reste chez vous.
§ 10
Crawler sans devenir une nuisance
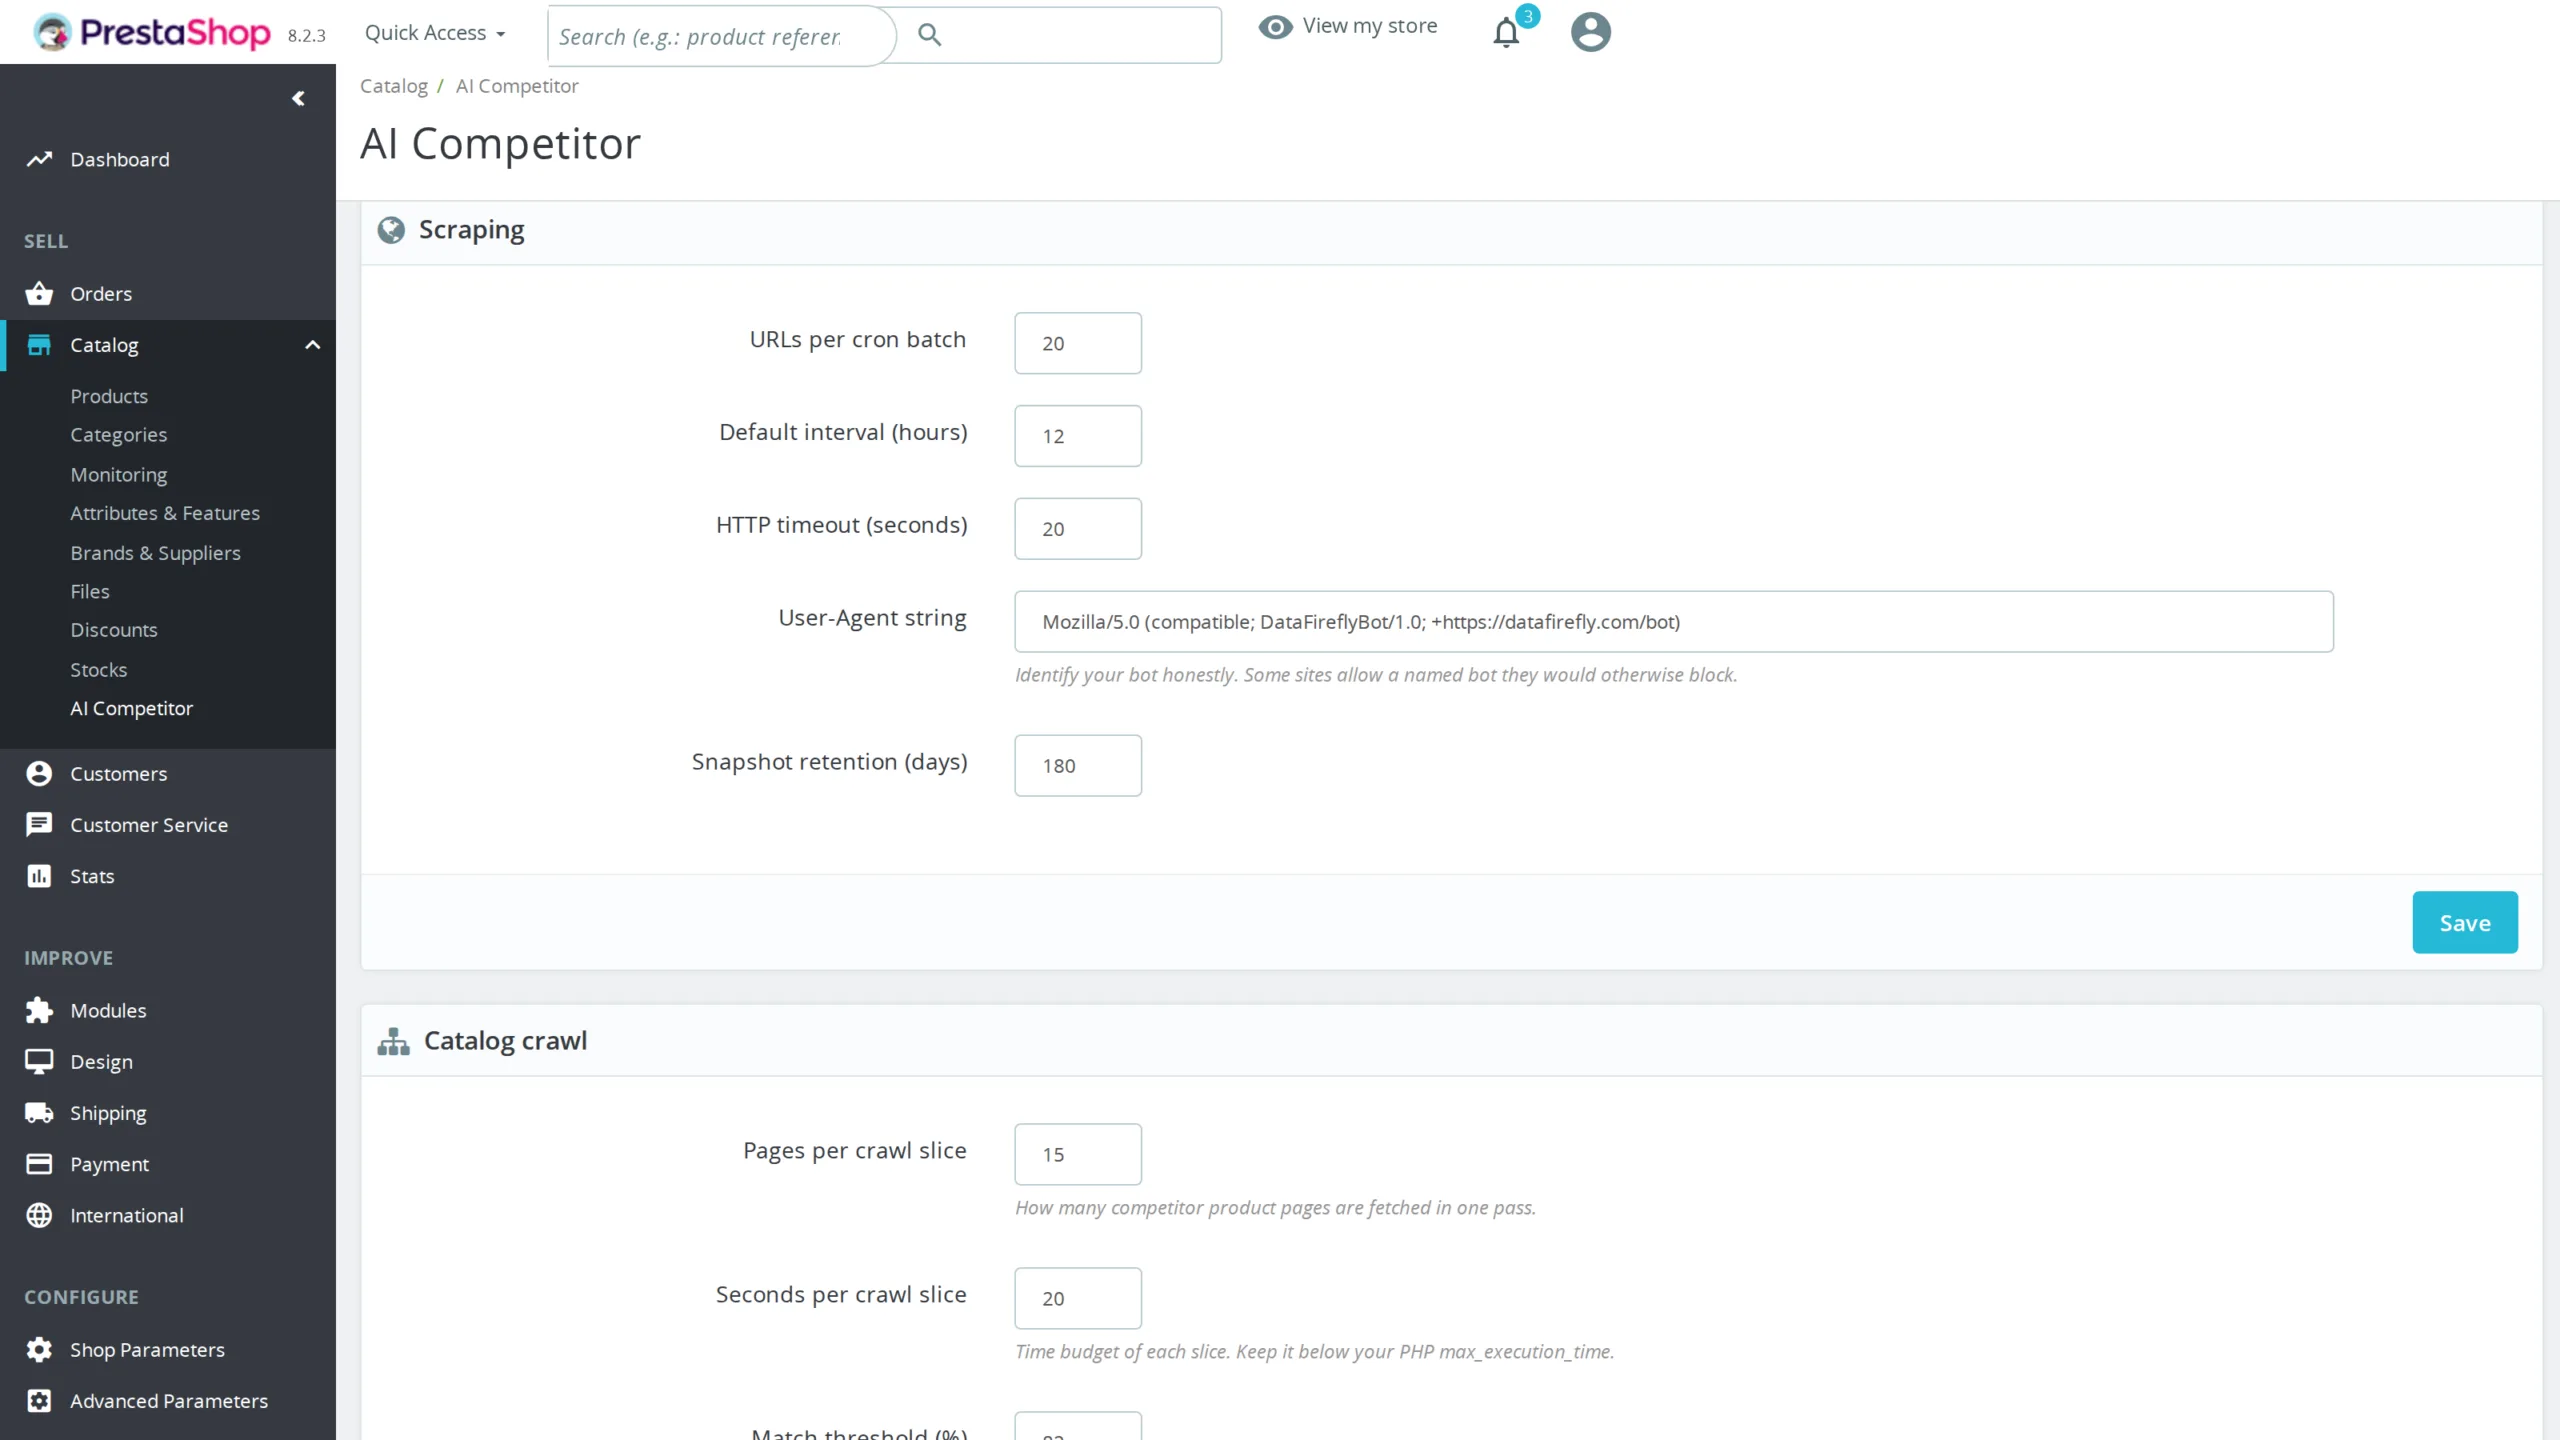
Lire les prix publics d'un concurrent est une pratique commerciale ordinaire, et le module est construit pour le faire proprement. Le robots.txt du site visé est respecté par défaut, pour la découverte comme pour la lecture des fiches, avec la règle de précédence du standard entre Allow et Disallow. Un Crawl-delay publié est honoré, et un délai entre deux requêtes s'applique par concurrent, réglé par défaut à une requête par seconde. Un plafond de produits borne le volume de chaque crawl. Le User-Agent identifie le robot par son nom plutôt que de se faire passer pour un navigateur. Ces réglages se désactivent concurrent par concurrent, mais l'appréciation des conditions d'utilisation du site visé vous revient.
§ 11
Installation et exploitation simplifiées
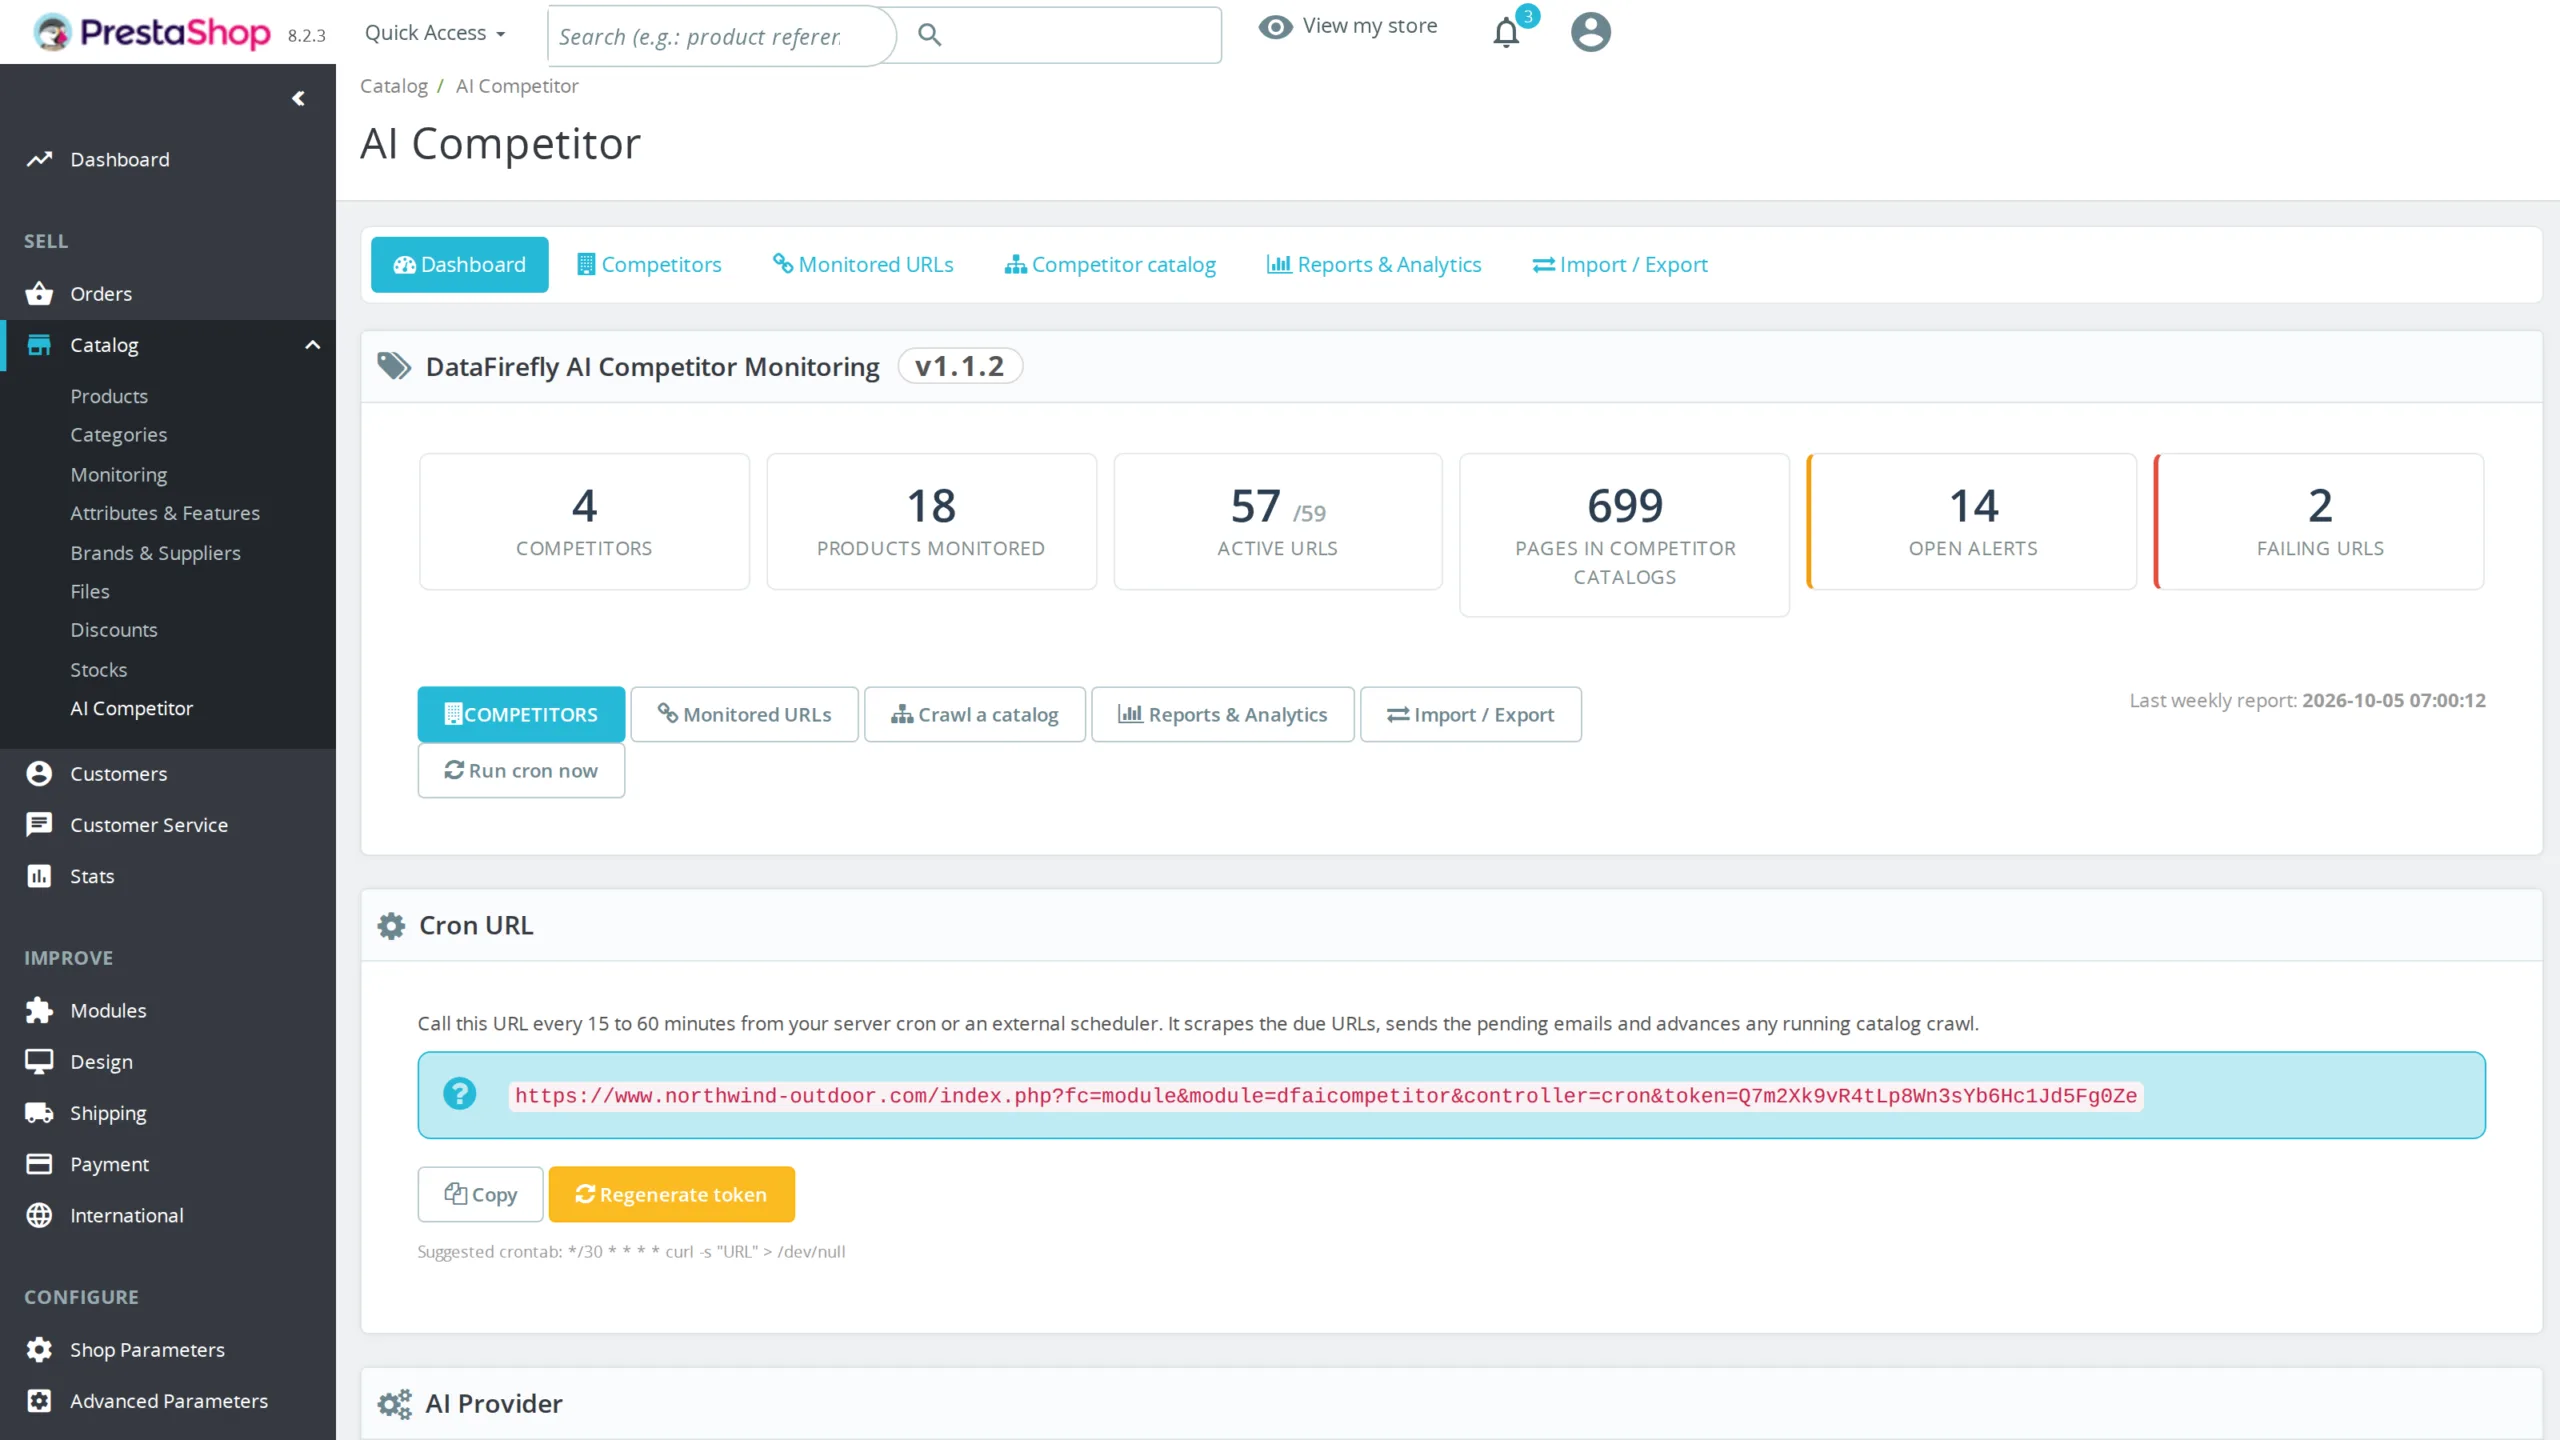
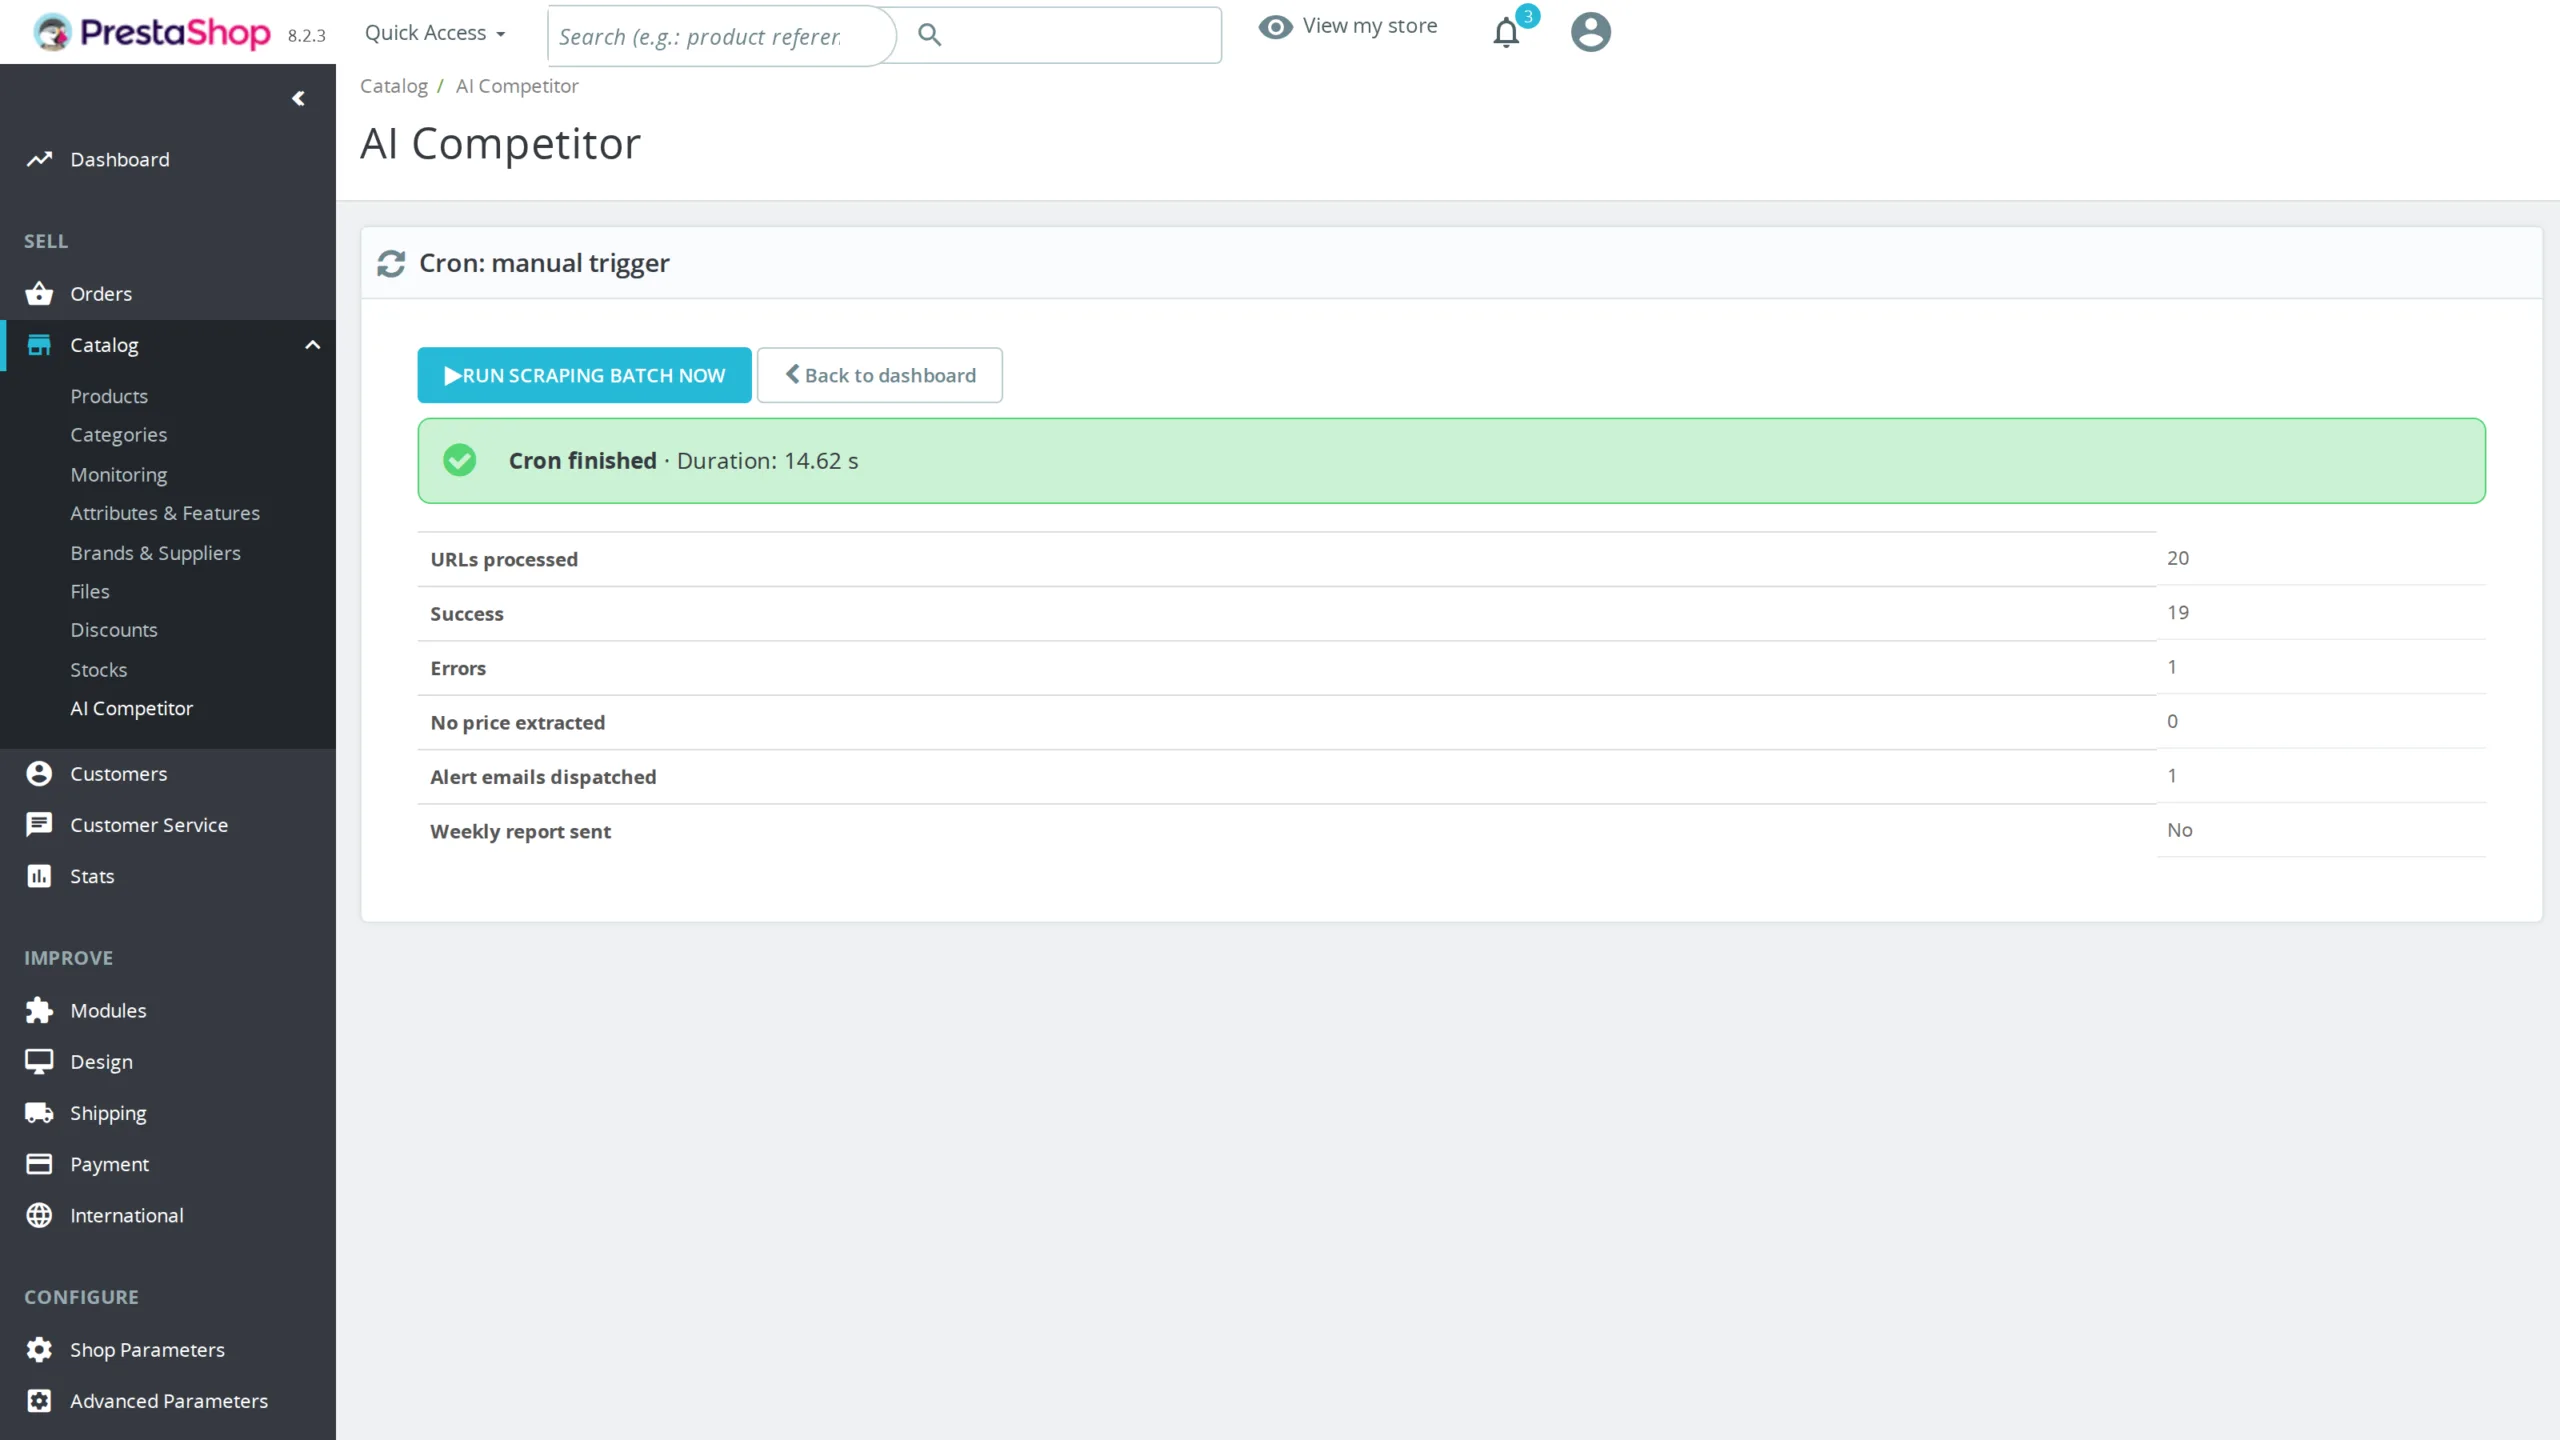
Installation via l'uploader de modules PrestaShop standard. Configuration en cinq minutes : provider IA, clé API, email de notification, jour du rapport hebdomadaire, stratégie d'ajustement. Le module fournit lui-même son URL de cron sécurisée par token, régénérable depuis le tableau de bord. Cron suggéré toutes les 30 minutes : le passage relève les URLs échues, envoie les emails en attente, fait avancer un crawl en cours et purge l'historique expiré. Aucune dépendance Composer, aucun service externe imposé hors du provider IA que vous choisissez.
§ 12
Compatibilité PrestaShop 8 et 9 garantie
Le module utilise uniquement les API stables cross-version : ObjectModel pour les entités, ModuleAdminController avec HelperList et HelperForm pour le back-office, ModuleFrontController pour l'endpoint cron. La traduction passe par l'instance du module et non par la méthode retirée d'AdminController en PrestaShop 9, et les liens AJAX sont construits avec les paramètres dans le quatrième argument de getAdminLink comme l'attend PrestaShop 9. Aucune injection invasive dans l'onglet produit Symfony. Vous n'avez pas à attendre une mise à jour quand vous migrez.
Il n’y a pas encore d’avis.